


 Maison
Dévoiler des modifications subtiles mais percutantes d'IA dans le contenu vidéo authentique
En 2019, une vidéo trompeuse de Nancy Pelosi, alors présidente de la Chambre des représentants des États-Unis, a largement circulé. La vidéo, modifiée pour la faire apparaître intoxiquée, a été un rappel frappant de la facilité avec laquelle les médias manipulés peuvent induire le public en erreur. Malgré sa simplicité, cet incident a mis en évidence le potentiel de dommage des montages audiovisuels même basiques.
À l'époque, le paysage des deepfakes était largement dominé par des technologies de remplacement de visage basées sur des autoencodeurs, présentes depuis fin 2017. Ces systèmes précoces peinaient à effectuer les modifications nuancées observées dans la vidéo de Pelosi, se concentrant plutôt sur des échanges de visages plus évidents.
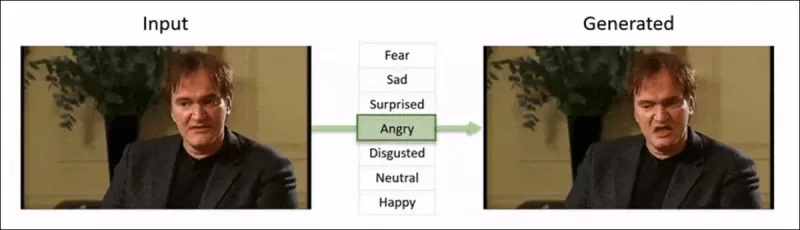 Le cadre ‘Neural Emotion Director' de 2022 modifie l'humeur d'un visage célèbre. Source : https://www.youtube.com/watch?v=Li6W8pRDMJQ
Aujourd'hui, l'industrie du cinéma et de la télévision explore de plus en plus les montages de post-production pilotés par l'IA. Cette tendance suscite à la fois intérêt et critiques, car l'IA permet un niveau de perfectionnisme auparavant inatteignable. En réponse, la communauté scientifique a développé divers projets axés sur les 'modifications locales' des captures faciales, tels que Diffusion Video Autoencoders, Stitch it in Time, ChatFace, MagicFace et DISCO.
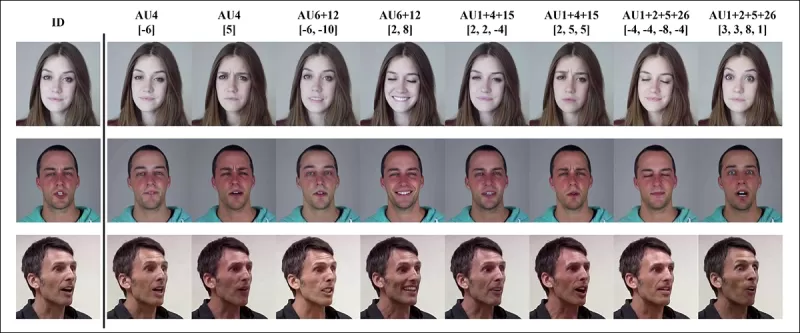 Modification d'expression avec le projet MagicFace de janvier 2025. Source : https://arxiv.org/pdf/2501.02260
Nouveaux visages, nouvelles rides
Cependant, la technologie pour créer ces modifications subtiles progresse beaucoup plus rapidement que notre capacité à les détecter. La plupart des méthodes de détection de deepfakes sont obsolètes, se concentrant sur des techniques et des ensembles de données plus anciens. Cela, jusqu'à une récente percée de chercheurs en Inde.
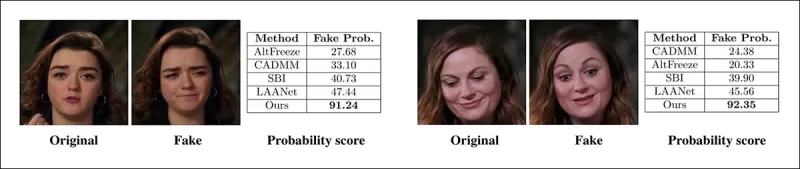 Détection de modifications locales subtiles dans les deepfakes : une vidéo réelle est altérée pour produire des faux avec des changements nuancés tels que des sourcils relevés, des traits de genre modifiés et des changements d'expression vers le dégoût (illustré ici par une seule image). Source : https://arxiv.org/pdf/2503.22121
Cette nouvelle recherche cible la détection de manipulations faciales subtiles et localisées, un type de falsification souvent négligé. Au lieu de chercher des incohérences générales ou des discordances d'identité, la méthode se concentre sur des détails fins comme de légers changements d'expression ou des modifications mineures de caractéristiques faciales spécifiques. Elle s'appuie sur le Facial Action Coding System (FACS), qui décompose les expressions faciales en 64 zones modifiables.
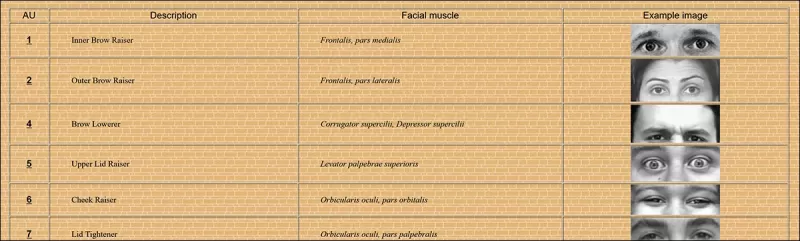 Certaines des 64 parties constitutives des expressions dans le FACS. Source : https://www.cs.cmu.edu/~face/facs.htm
Les chercheurs ont testé leur approche contre diverses méthodes d'édition récentes et ont constaté qu'elle surpassait systématiquement les solutions existantes, même avec des ensembles de données plus anciens et de nouveaux vecteurs d'attaque.
« En utilisant des caractéristiques basées sur les AU pour guider les représentations vidéo apprises à travers des autoencodeurs masqués (MAE), notre méthode capture efficacement les changements localisés cruciaux pour détecter les modifications faciales subtiles.
« Cette approche nous permet de construire une représentation latente unifiée qui encode à la fois les modifications localisées et les altérations plus larges dans les vidéos centrées sur les visages, offrant une solution complète et adaptable pour la détection de deepfakes. »
L'article, intitulé Détection des manipulations de deepfakes localisées à l'aide de représentations vidéo guidées par les unités d'action, a été rédigé par des chercheurs de l'Indian Institute of Technology à Madras.
Méthode
La méthode commence par détecter les visages dans une vidéo et échantillonner des images espacées uniformément centrées sur ces visages. Ces images sont ensuite divisées en petits patches 3D, capturant des détails spatiaux et temporels locaux.
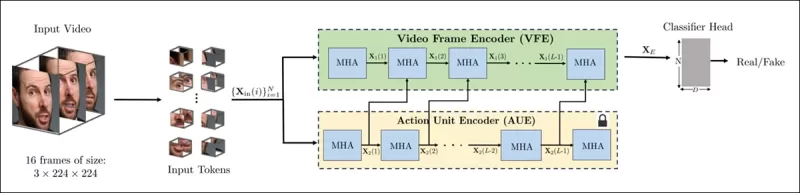 Schéma de la nouvelle méthode. La vidéo d'entrée est traitée avec une détection de visage pour extraire des images centrées sur le visage, espacées uniformément, qui sont ensuite divisées en patches tubulaires et passées à travers un encodeur qui fusionne les représentations latentes de deux tâches de prétexte pré-entraînées. Le vecteur résultant est ensuite utilisé par un classificateur pour déterminer si la vidéo est réelle ou fausse.
Chaque patch contient une petite fenêtre de pixels provenant de quelques images successives, permettant au modèle d'apprendre les mouvements et les changements d'expression à court terme. Ces patches sont intégrés et encodés positionnellement avant d'être introduits dans un encodeur conçu pour distinguer les vidéos réelles des fausses.
Le défi de détecter des manipulations subtiles est abordé en utilisant un encodeur qui combine deux types de représentations apprises à travers un mécanisme d'attention croisée, visant à créer un espace de caractéristiques plus sensible et généralisable.
Tâches de prétexte
La première représentation provient d'un encodeur entraîné avec une tâche d'autoencodage masqué. En masquant la plupart des patches 3D de la vidéo, l'encodeur apprend à reconstruire les parties manquantes, capturant des motifs spatiotemporels importants comme les mouvements faciaux.
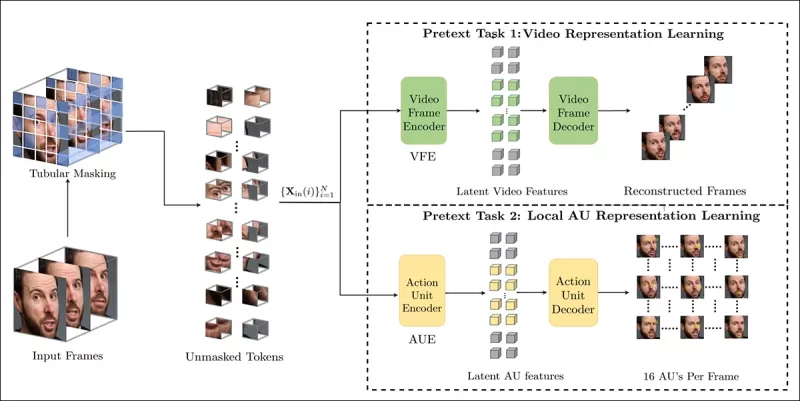 L'entraînement des tâches de prétexte implique de masquer des parties de l'entrée vidéo et d'utiliser une configuration encodeur-décodeur pour reconstruire soit les images originales, soit les cartes d'unités d'action par image, selon la tâche.
Cependant, cela seul ne suffit pas pour détecter les modifications à grain fin. Les chercheurs ont introduit un second encodeur entraîné à détecter les unités d'action faciales (AU), l'encourageant à se concentrer sur l'activité musculaire localisée où les modifications subtiles des deepfakes se produisent souvent.
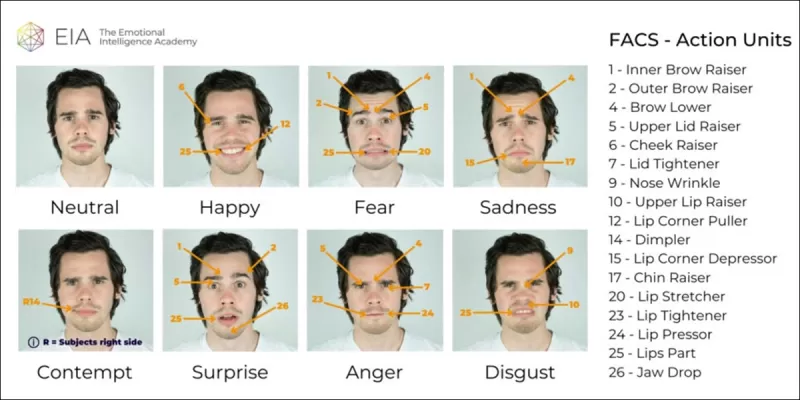 Autres exemples d'unités d'action faciales (FAUs, ou AUs). Source : https://www.eiagroup.com/the-facial-action-coding-system/
Après le pré-entraînement, les sorties des deux encodeurs sont combinées à l'aide d'une attention croisée, les caractéristiques basées sur les AU guidant l'attention sur les caractéristiques spatio-temporelles. Cela donne une représentation latente fusionnée qui capture à la fois le contexte de mouvement plus large et les détails d'expression localisés, utilisée pour la tâche de classification finale.
Données et tests
Mise en œuvre
Le système a été implémenté en utilisant le cadre de détection de visage FaceXZoo basé sur PyTorch, extrayant 16 images centrées sur le visage de chaque clip vidéo. Les tâches de prétexte ont été entraînées sur l'ensemble de données CelebV-HQ, qui comprend 35 000 vidéos faciales de haute qualité.
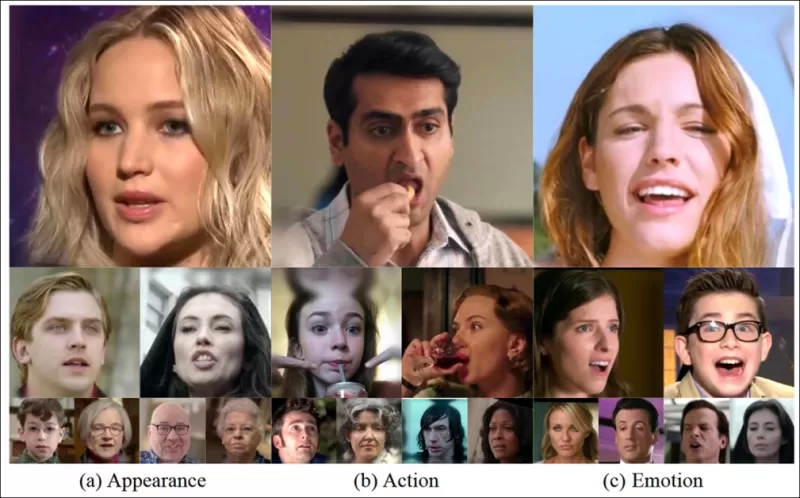 Extrait de l'article source, exemples de l'ensemble de données CelebV-HQ utilisé dans le nouveau projet. Source : https://arxiv.org/pdf/2207.12393
La moitié des données a été masquée pour éviter le surajustement. Pour la tâche de reconstruction d'images masquées, le modèle a été entraîné à prédire les régions manquantes en utilisant la perte L1. Pour la seconde tâche, il a été entraîné à générer des cartes pour 16 unités d'action faciales, supervisé par la perte L1.
Après le pré-entraînement, les encodeurs ont été fusionnés et affinés pour la détection de deepfakes en utilisant l'ensemble de données FaceForensics++, qui comprend à la fois des vidéos réelles et manipulées.
 L'ensemble de données FaceForensics++ est le point de référence central pour la détection de deepfakes depuis 2017, bien qu'il soit maintenant considérablement dépassé en ce qui concerne les dernières techniques de synthèse faciale. Source : https://www.youtube.com/watch?v=x2g48Q2I2ZQ
Pour résoudre le problème de déséquilibre des classes, les auteurs ont utilisé la perte focale, mettant l'accent sur les exemples plus difficiles pendant l'entraînement. Tout l'entraînement a été effectué sur un seul GPU RTX 4090 avec 24 Go de VRAM, en utilisant des points de contrôle pré-entraînés de VideoMAE.
Tests
La méthode a été évaluée par rapport à diverses techniques de détection de deepfakes, en se concentrant sur les deepfakes modifiés localement. Les tests incluaient une gamme de méthodes d'édition et d'ensembles de données deepfake plus anciens, en utilisant des métriques telles que l'aire sous la courbe (AUC), la précision moyenne et le score F1 moyen.
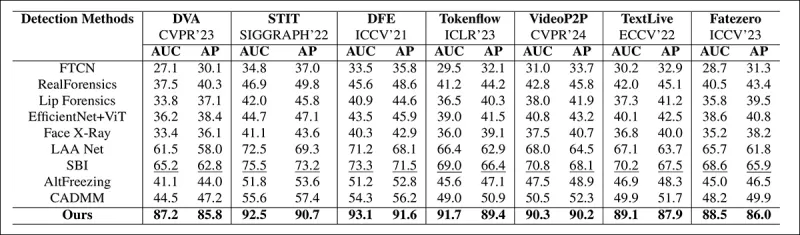 Extrait de l'article : la comparaison sur les deepfakes localisés récents montre que la méthode proposée a surpassé toutes les autres, avec un gain de 15 à 20 pour cent en AUC et en précision moyenne par rapport à l'approche suivante la meilleure.
Les auteurs ont fourni des comparaisons visuelles de vidéos manipulées localement, montrant la sensibilité supérieure de leur méthode aux modifications subtiles.
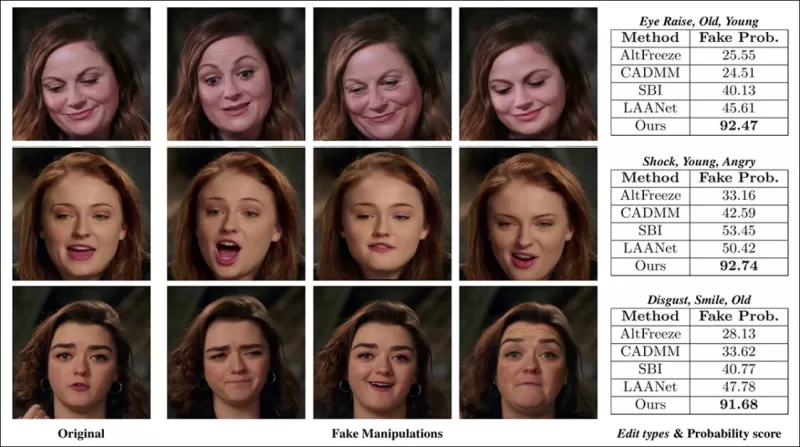 Une vidéo réelle a été altérée à l'aide de trois manipulations localisées différentes pour produire des faux qui restaient visuellement similaires à l'original. Sont présentées ici des images représentatives ainsi que les scores moyens de détection de faux pour chaque méthode. Alors que les détecteurs existants avaient du mal avec ces modifications subtiles, le modèle proposé a constamment attribué des probabilités élevées de faux, indiquant une plus grande sensibilité aux changements localisés.
Les chercheurs ont noté que les méthodes de détection de pointe existantes avaient du mal avec les dernières techniques de génération de deepfakes, tandis que leur méthode montrait une généralisation robuste, obtenant des scores élevés en AUC et en précision moyenne.
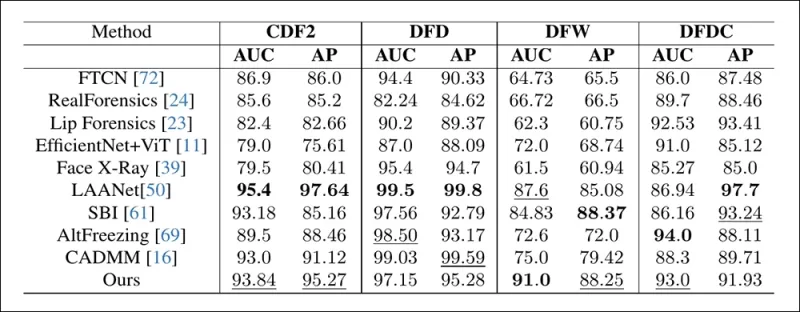 Les performances sur les ensembles de données deepfake traditionnels montrent que la méthode proposée restait compétitive avec les approches de pointe, indiquant une forte généralisation sur une gamme de types de manipulation.
Les auteurs ont également testé la fiabilité du modèle dans des conditions réelles, le trouvant résilient aux distorsions vidéo courantes telles que les ajustements de saturation, le flou gaussien et la pixellisation.
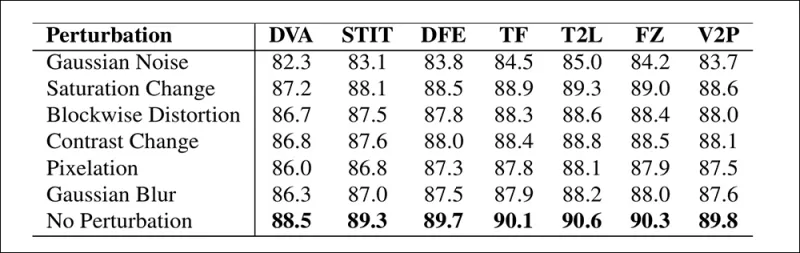 Une illustration de la manière dont la précision de la détection change sous différentes distorsions vidéo. La nouvelle méthode est restée résiliente dans la plupart des cas, avec seulement une légère baisse en AUC. La baisse la plus significative s'est produite lorsque du bruit gaussien a été introduit.
Conclusion
Bien que le public pense souvent aux deepfakes comme à des échanges d'identité, la réalité de la manipulation par IA est plus nuancée et potentiellement plus insidieuse. Le type de modification locale discuté dans cette nouvelle recherche pourrait ne pas attirer l'attention du public jusqu'à ce qu'un autre incident de grande envergure se produise. Pourtant, comme l'a souligné l'acteur Nic Cage, le potentiel des modifications de post-production pour altérer les performances est une préoccupation dont nous devrions tous être conscients. Nous sommes naturellement sensibles aux moindres changements dans les expressions faciales, et le contexte peut considérablement en modifier l'impact.
Première publication mercredi 2 avril 2025
Article connexe
 OpenAI facilite la vérification des images générées par l'IA
À mesure que les générateurs d’images basés sur l’IA se généralisent et gagnent en sophistication sur Internet, il n’a jamais été aussi difficile de distinguer les images réelles des faux. Mardi, Open
YouTube étend sa détection des deepfakes par IA aux personnalités politiques, aux responsables gouvernementaux et aux journalistes
Mardi, YouTube a annoncé qu’il étendait sa technologie de détection des deepfakes à un groupe restreint de responsables gouvernementaux, de candidats politiques et de journalistes. Cet outil identifie
YouTube renforce ses mesures de protection contre les deepfakes générés par l'IA pour les personnalités politiques, les responsables publics et les journalistes
YouTube étend l'accès à sa technologie de détection d'images à son effigie, conçue pour identifier les deepfakes générés par l'IA, dans le cadre d'un programme pilote destiné aux responsables gouverne
Recommandations de sujets spéciaux liés
Composition musicale
 Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
 8 outils
 xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Analyse des données
Meilleurs outils de nettoyage de données IA : corrigez rapidement les valeurs manquantes et les doublons
2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

 commentaires (47)
![CarlPerez]()
Honestly, the Pelosi incident still gives me chills. It's not just deepfakes; even simple speed changes can distort reality. We need better tools to detect these manipulations. 🧐
![RalphMitchell]()
この記事を読んで、AIによる映像改ざんがこんなに簡単にできるなんて怖いですね。ペロシ議長の例は氷山の一角で、もっと巧妙な偽動画がSNSで拡散される可能性があります。一般ユーザーとして、どうやって本物と偽物を見分ければいいのか悩みます。技術の進歩は素晴らしいけど、悪用されないための規制も必要じゃないかな🤔
![JustinHarris]()
Honestly, this Pelosi video case is a perfect example of how 'low-tech' AI manipulation can be the most dangerous. It doesn't need deepfakes; just slowing down footage creates a narrative. Makes you wonder what subtle edits we're already consuming daily without a second thought. The real battle for truth is in these tiny, almost invisible tweaks. 😳
![DavidRodriguez]()
Dieser Artikel erinnert mich daran, wie wichtig Medienkompetenz heute ist. Die Pelosi-Video-Manipulation war ja noch relativ plump, aber mit aktueller KI wird das bestimmt viel subtiler. Macht mir schon etwas Sorgen, vor Wahlen oder so. Wie soll man da noch zwischen echt und fake unterscheiden? 😕
![WilliamCarter]()
That Pelosi video from 2019 is wild! It’s scary how a few tweaks can make someone look totally drunk. AI’s power to mess with videos is both cool and creepy—makes you wonder what’s real anymore. 😬
![JuanMartínez]()
This Pelosi video incident is wild! 🤯 It’s scary how a few tweaks can make someone look totally out of it. Makes me wonder how much of what we see online is real anymore. AI’s cool, but this kind of stuff could mess with trust big time.
En 2019, une vidéo trompeuse de Nancy Pelosi, alors présidente de la Chambre des représentants des États-Unis, a largement circulé. La vidéo, modifiée pour la faire apparaître intoxiquée, a été un rappel frappant de la facilité avec laquelle les médias manipulés peuvent induire le public en erreur. Malgré sa simplicité, cet incident a mis en évidence le potentiel de dommage des montages audiovisuels même basiques.
À l'époque, le paysage des deepfakes était largement dominé par des technologies de remplacement de visage basées sur des autoencodeurs, présentes depuis fin 2017. Ces systèmes précoces peinaient à effectuer les modifications nuancées observées dans la vidéo de Pelosi, se concentrant plutôt sur des échanges de visages plus évidents.
Le cadre ‘Neural Emotion Director' de 2022 modifie l'humeur d'un visage célèbre. Source : https://www.youtube.com/watch?v=Li6W8pRDMJQ
Aujourd'hui, l'industrie du cinéma et de la télévision explore de plus en plus les montages de post-production pilotés par l'IA. Cette tendance suscite à la fois intérêt et critiques, car l'IA permet un niveau de perfectionnisme auparavant inatteignable. En réponse, la communauté scientifique a développé divers projets axés sur les 'modifications locales' des captures faciales, tels que Diffusion Video Autoencoders, Stitch it in Time, ChatFace, MagicFace et DISCO.
Modification d'expression avec le projet MagicFace de janvier 2025. Source : https://arxiv.org/pdf/2501.02260
Nouveaux visages, nouvelles rides
Cependant, la technologie pour créer ces modifications subtiles progresse beaucoup plus rapidement que notre capacité à les détecter. La plupart des méthodes de détection de deepfakes sont obsolètes, se concentrant sur des techniques et des ensembles de données plus anciens. Cela, jusqu'à une récente percée de chercheurs en Inde.
Détection de modifications locales subtiles dans les deepfakes : une vidéo réelle est altérée pour produire des faux avec des changements nuancés tels que des sourcils relevés, des traits de genre modifiés et des changements d'expression vers le dégoût (illustré ici par une seule image). Source : https://arxiv.org/pdf/2503.22121
Cette nouvelle recherche cible la détection de manipulations faciales subtiles et localisées, un type de falsification souvent négligé. Au lieu de chercher des incohérences générales ou des discordances d'identité, la méthode se concentre sur des détails fins comme de légers changements d'expression ou des modifications mineures de caractéristiques faciales spécifiques. Elle s'appuie sur le Facial Action Coding System (FACS), qui décompose les expressions faciales en 64 zones modifiables.
Certaines des 64 parties constitutives des expressions dans le FACS. Source : https://www.cs.cmu.edu/~face/facs.htm
Les chercheurs ont testé leur approche contre diverses méthodes d'édition récentes et ont constaté qu'elle surpassait systématiquement les solutions existantes, même avec des ensembles de données plus anciens et de nouveaux vecteurs d'attaque.
« En utilisant des caractéristiques basées sur les AU pour guider les représentations vidéo apprises à travers des autoencodeurs masqués (MAE), notre méthode capture efficacement les changements localisés cruciaux pour détecter les modifications faciales subtiles.
« Cette approche nous permet de construire une représentation latente unifiée qui encode à la fois les modifications localisées et les altérations plus larges dans les vidéos centrées sur les visages, offrant une solution complète et adaptable pour la détection de deepfakes. »
L'article, intitulé Détection des manipulations de deepfakes localisées à l'aide de représentations vidéo guidées par les unités d'action, a été rédigé par des chercheurs de l'Indian Institute of Technology à Madras.
Méthode
La méthode commence par détecter les visages dans une vidéo et échantillonner des images espacées uniformément centrées sur ces visages. Ces images sont ensuite divisées en petits patches 3D, capturant des détails spatiaux et temporels locaux.
Schéma de la nouvelle méthode. La vidéo d'entrée est traitée avec une détection de visage pour extraire des images centrées sur le visage, espacées uniformément, qui sont ensuite divisées en patches tubulaires et passées à travers un encodeur qui fusionne les représentations latentes de deux tâches de prétexte pré-entraînées. Le vecteur résultant est ensuite utilisé par un classificateur pour déterminer si la vidéo est réelle ou fausse.
Chaque patch contient une petite fenêtre de pixels provenant de quelques images successives, permettant au modèle d'apprendre les mouvements et les changements d'expression à court terme. Ces patches sont intégrés et encodés positionnellement avant d'être introduits dans un encodeur conçu pour distinguer les vidéos réelles des fausses.
Le défi de détecter des manipulations subtiles est abordé en utilisant un encodeur qui combine deux types de représentations apprises à travers un mécanisme d'attention croisée, visant à créer un espace de caractéristiques plus sensible et généralisable.
Tâches de prétexte
La première représentation provient d'un encodeur entraîné avec une tâche d'autoencodage masqué. En masquant la plupart des patches 3D de la vidéo, l'encodeur apprend à reconstruire les parties manquantes, capturant des motifs spatiotemporels importants comme les mouvements faciaux.
L'entraînement des tâches de prétexte implique de masquer des parties de l'entrée vidéo et d'utiliser une configuration encodeur-décodeur pour reconstruire soit les images originales, soit les cartes d'unités d'action par image, selon la tâche.
Cependant, cela seul ne suffit pas pour détecter les modifications à grain fin. Les chercheurs ont introduit un second encodeur entraîné à détecter les unités d'action faciales (AU), l'encourageant à se concentrer sur l'activité musculaire localisée où les modifications subtiles des deepfakes se produisent souvent.
Autres exemples d'unités d'action faciales (FAUs, ou AUs). Source : https://www.eiagroup.com/the-facial-action-coding-system/
Après le pré-entraînement, les sorties des deux encodeurs sont combinées à l'aide d'une attention croisée, les caractéristiques basées sur les AU guidant l'attention sur les caractéristiques spatio-temporelles. Cela donne une représentation latente fusionnée qui capture à la fois le contexte de mouvement plus large et les détails d'expression localisés, utilisée pour la tâche de classification finale.
Données et tests
Mise en œuvre
Le système a été implémenté en utilisant le cadre de détection de visage FaceXZoo basé sur PyTorch, extrayant 16 images centrées sur le visage de chaque clip vidéo. Les tâches de prétexte ont été entraînées sur l'ensemble de données CelebV-HQ, qui comprend 35 000 vidéos faciales de haute qualité.
Extrait de l'article source, exemples de l'ensemble de données CelebV-HQ utilisé dans le nouveau projet. Source : https://arxiv.org/pdf/2207.12393
La moitié des données a été masquée pour éviter le surajustement. Pour la tâche de reconstruction d'images masquées, le modèle a été entraîné à prédire les régions manquantes en utilisant la perte L1. Pour la seconde tâche, il a été entraîné à générer des cartes pour 16 unités d'action faciales, supervisé par la perte L1.
Après le pré-entraînement, les encodeurs ont été fusionnés et affinés pour la détection de deepfakes en utilisant l'ensemble de données FaceForensics++, qui comprend à la fois des vidéos réelles et manipulées.
L'ensemble de données FaceForensics++ est le point de référence central pour la détection de deepfakes depuis 2017, bien qu'il soit maintenant considérablement dépassé en ce qui concerne les dernières techniques de synthèse faciale. Source : https://www.youtube.com/watch?v=x2g48Q2I2ZQ
Pour résoudre le problème de déséquilibre des classes, les auteurs ont utilisé la perte focale, mettant l'accent sur les exemples plus difficiles pendant l'entraînement. Tout l'entraînement a été effectué sur un seul GPU RTX 4090 avec 24 Go de VRAM, en utilisant des points de contrôle pré-entraînés de VideoMAE.
Tests
La méthode a été évaluée par rapport à diverses techniques de détection de deepfakes, en se concentrant sur les deepfakes modifiés localement. Les tests incluaient une gamme de méthodes d'édition et d'ensembles de données deepfake plus anciens, en utilisant des métriques telles que l'aire sous la courbe (AUC), la précision moyenne et le score F1 moyen.
Extrait de l'article : la comparaison sur les deepfakes localisés récents montre que la méthode proposée a surpassé toutes les autres, avec un gain de 15 à 20 pour cent en AUC et en précision moyenne par rapport à l'approche suivante la meilleure.
Les auteurs ont fourni des comparaisons visuelles de vidéos manipulées localement, montrant la sensibilité supérieure de leur méthode aux modifications subtiles.
Une vidéo réelle a été altérée à l'aide de trois manipulations localisées différentes pour produire des faux qui restaient visuellement similaires à l'original. Sont présentées ici des images représentatives ainsi que les scores moyens de détection de faux pour chaque méthode. Alors que les détecteurs existants avaient du mal avec ces modifications subtiles, le modèle proposé a constamment attribué des probabilités élevées de faux, indiquant une plus grande sensibilité aux changements localisés.
Les chercheurs ont noté que les méthodes de détection de pointe existantes avaient du mal avec les dernières techniques de génération de deepfakes, tandis que leur méthode montrait une généralisation robuste, obtenant des scores élevés en AUC et en précision moyenne.
Les performances sur les ensembles de données deepfake traditionnels montrent que la méthode proposée restait compétitive avec les approches de pointe, indiquant une forte généralisation sur une gamme de types de manipulation.
Les auteurs ont également testé la fiabilité du modèle dans des conditions réelles, le trouvant résilient aux distorsions vidéo courantes telles que les ajustements de saturation, le flou gaussien et la pixellisation.
Une illustration de la manière dont la précision de la détection change sous différentes distorsions vidéo. La nouvelle méthode est restée résiliente dans la plupart des cas, avec seulement une légère baisse en AUC. La baisse la plus significative s'est produite lorsque du bruit gaussien a été introduit.
Conclusion
Bien que le public pense souvent aux deepfakes comme à des échanges d'identité, la réalité de la manipulation par IA est plus nuancée et potentiellement plus insidieuse. Le type de modification locale discuté dans cette nouvelle recherche pourrait ne pas attirer l'attention du public jusqu'à ce qu'un autre incident de grande envergure se produise. Pourtant, comme l'a souligné l'acteur Nic Cage, le potentiel des modifications de post-production pour altérer les performances est une préoccupation dont nous devrions tous être conscients. Nous sommes naturellement sensibles aux moindres changements dans les expressions faciales, et le contexte peut considérablement en modifier l'impact.
Première publication mercredi 2 avril 2025








 OpenAI facilite la vérification des images générées par l'IA
À mesure que les générateurs d’images basés sur l’IA se généralisent et gagnent en sophistication sur Internet, il n’a jamais été aussi difficile de distinguer les images réelles des faux. Mardi, Open
 YouTube étend sa détection des deepfakes par IA aux personnalités politiques, aux responsables gouvernementaux et aux journalistes
Mardi, YouTube a annoncé qu’il étendait sa technologie de détection des deepfakes à un groupe restreint de responsables gouvernementaux, de candidats politiques et de journalistes. Cet outil identifie
 YouTube renforce ses mesures de protection contre les deepfakes générés par l'IA pour les personnalités politiques, les responsables publics et les journalistes
YouTube étend l'accès à sa technologie de détection d'images à son effigie, conçue pour identifier les deepfakes générés par l'IA, dans le cadre d'un programme pilote destiné aux responsables gouverne

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

Honestly, the Pelosi incident still gives me chills. It's not just deepfakes; even simple speed changes can distort reality. We need better tools to detect these manipulations. 🧐
この記事を読んで、AIによる映像改ざんがこんなに簡単にできるなんて怖いですね。ペロシ議長の例は氷山の一角で、もっと巧妙な偽動画がSNSで拡散される可能性があります。一般ユーザーとして、どうやって本物と偽物を見分ければいいのか悩みます。技術の進歩は素晴らしいけど、悪用されないための規制も必要じゃないかな🤔
Honestly, this Pelosi video case is a perfect example of how 'low-tech' AI manipulation can be the most dangerous. It doesn't need deepfakes; just slowing down footage creates a narrative. Makes you wonder what subtle edits we're already consuming daily without a second thought. The real battle for truth is in these tiny, almost invisible tweaks. 😳
Dieser Artikel erinnert mich daran, wie wichtig Medienkompetenz heute ist. Die Pelosi-Video-Manipulation war ja noch relativ plump, aber mit aktueller KI wird das bestimmt viel subtiler. Macht mir schon etwas Sorgen, vor Wahlen oder so. Wie soll man da noch zwischen echt und fake unterscheiden? 😕
That Pelosi video from 2019 is wild! It’s scary how a few tweaks can make someone look totally drunk. AI’s power to mess with videos is both cool and creepy—makes you wonder what’s real anymore. 😬
This Pelosi video incident is wild! 🤯 It’s scary how a few tweaks can make someone look totally out of it. Makes me wonder how much of what we see online is real anymore. AI’s cool, but this kind of stuff could mess with trust big time.












