


 Дом
Открытие тонких, но эффективных модификаций ИИ в аутентичном видеоконтенте
В 2019 году широко распространилось обманное видео с Нэнси Пелоси, тогда спикером Палаты представителей США. Видео, отредактированное так, чтобы она выглядела пьяной, стало ярким напоминанием о том, как легко манипулируемые медиа могут ввести в заблуждение общественность. Несмотря на свою простоту, этот инцидент подчеркнул потенциальный ущерб даже от базовых аудиовизуальных правок.
В то время ландшафт дипфейков в основном определялся технологиями замены лиц на основе автоэнкодеров, появившихся в конце 2017 года. Эти ранние системы с трудом справлялись с тонкими изменениями, как в видео с Пелоси, сосредотачиваясь вместо этого на более явных заменах лиц.
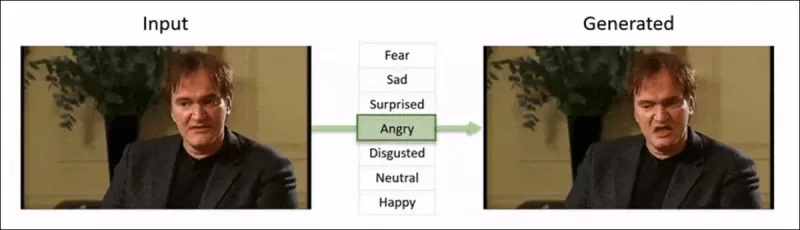 Структура 2022 года ‘Neural Emotion Director' изменяет настроение известного лица. Источник: https://www.youtube.com/watch?v=Li6W8pRDMJQ
Сегодня кино- и телеиндустрия всё больше исследует правки постпроизводства с использованием ИИ. Эта тенденция вызвала как интерес, так и критику, поскольку ИИ позволяет достичь уровня перфекционизма, ранее недоступного. В ответ научное сообщество разработало различные проекты, сосредоточенные на «локальных правках» захвата лиц, такие как Diffusion Video Autoencoders, Stitch it in Time, ChatFace, MagicFace и DISCO.
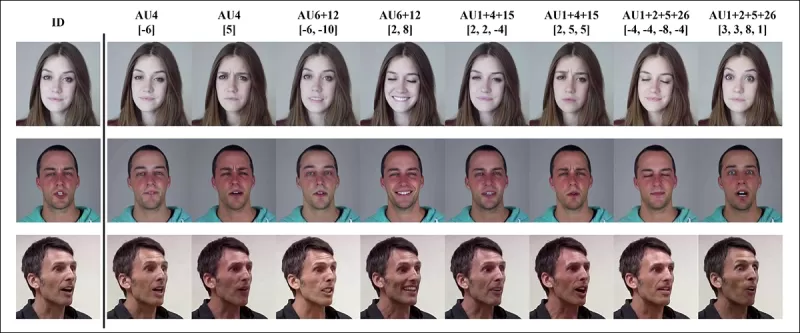 Редактирование выражений с проектом MagicFace января 2025 года. Источник: https://arxiv.org/pdf/2501.02260
Новые лица, новые морщины
Однако технологии для создания таких тонких правок развиваются гораздо быстрее, чем наша способность их обнаруживать. Большинство методов обнаружения дипфейков устарели, сосредотачиваясь на старых техниках и наборах данных. Это продолжалось до недавнего прорыва от исследователей из Индии.
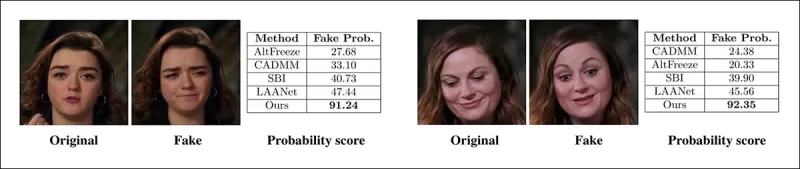 Обнаружение тонких локальных правок в дипфейках: реальное видео изменяется для создания подделок с нюансными изменениями, такими как поднятые брови, изменённые гендерные черты и сдвиги в выражении в сторону отвращения (показано здесь на одном кадре). Источник: https://arxiv.org/pdf/2503.22121
Это новое исследование направлено на обнаружение тонких, локализованных манипуляций с лицами, тип подделки, который часто игнорируется. Вместо поиска широких несоответствий или несовпадений идентичности метод сосредотачивается на мелких деталях, таких как лёгкие сдвиги в выражении или незначительные правки отдельных черт лица. Он использует систему кодирования лицевых движений (FACS), которая разбивает выражения лица на 64 изменяемые области.
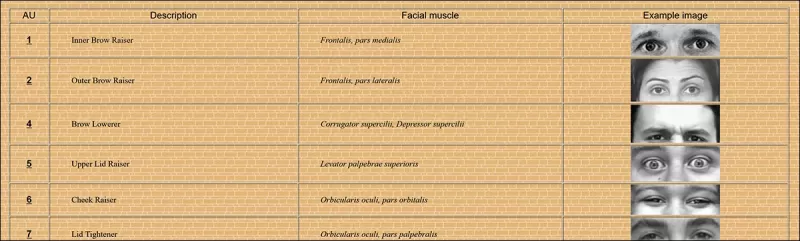 Некоторые из 64 составных частей выражений в FACS. Источник: https://www.cs.cmu.edu/~face/facs.htm
Исследователи протестировали свой подход против различных недавних методов редактирования и обнаружили, что он стабильно превосходит существующие решения, даже с более старыми наборами данных и новыми векторами атак.
«Используя функции на основе AU для управления видеоизображениями, изученными через маскированные автоэнкодеры (MAE), наш метод эффективно фиксирует локализованные изменения, критически важные для обнаружения тонких правок лица.»
«Этот подход позволяет нам создать единое скрытое представление, которое кодирует как локализованные правки, так и более широкие изменения в видео, сосредоточенных на лице, предоставляя всестороннее и адаптируемое решение для обнаружения дипфейков.»
Статья, озаглавленная Обнаружение локализованных манипуляций дипфейков с использованием видеоизображений, управляемых единицами действия, была написана исследователями из Индийского института технологий в Мадрасе.
Метод
Метод начинается с обнаружения лиц в видео и выборки равномерно распределённых кадров, центрированных на этих лицах. Эти кадры затем разбиваются на небольшие 3D-патчи, фиксирующие локальные пространственные и временные детали.
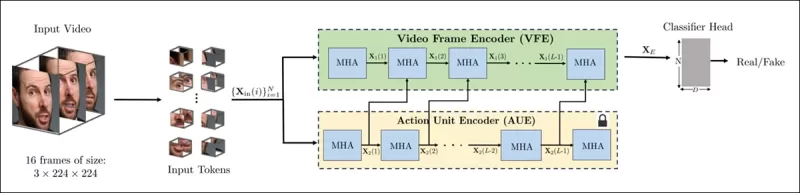 Схема нового метода. Входное видео обрабатывается с обнаружением лиц для извлечения равномерно распределённых, центрированных на лице кадров, которые затем делятся на «трубчатые» патчи и проходят через энкодер, который объединяет скрытые представления из двух предварительно обученных задач. Получившийся вектор затем используется классификатором для определения, является ли видео реальным или поддельным.
Каждый патч содержит небольшое окно пикселей из нескольких последовательных кадров, позволяя модели изучать краткосрочные движения и изменения выражений. Эти патчи встраиваются и позиционно кодируются перед подачей в энкодер, предназначенный для различения реальных и поддельных видео.
Задача обнаружения тонких манипуляций решается с использованием энкодера, который объединяет два типа изученных представлений через механизм перекрестного внимания, стремясь создать более чувствительное и обобщающее пространство признаков.
Предварительные задачи
Первое представление исходит от энкодера, обученного задаче маскированного автоэнкодирования. Скрывая большую часть 3D-патчей видео, энкодер учится восстанавливать недостающие части, фиксируя важные пространственно-временные шаблоны, такие как движения лица.
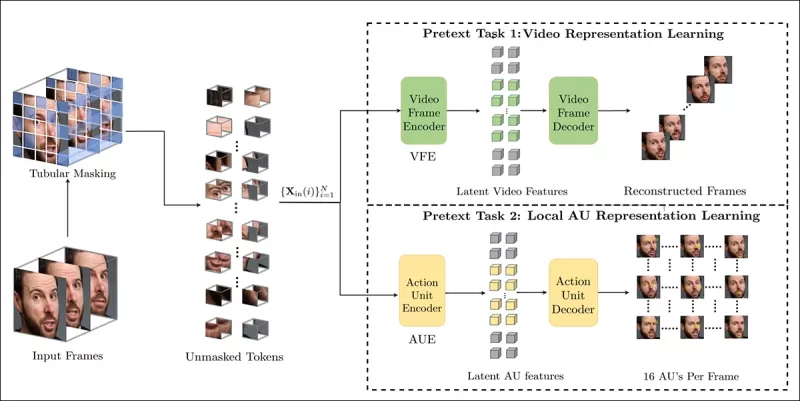 Обучение предварительной задаче включает маскирование частей входного видео и использование конфигурации энкодер-декодер для восстановления либо исходных кадров, либо карт единиц действия по кадрам, в зависимости от задачи.
Однако этого недостаточно для обнаружения мелкозернистых правок. Исследователи ввели второй энкодер, обученный обнаружению единиц лицевых действий (AUs), побуждая его сосредотачиваться на локализованной мышечной активности, где часто происходят тонкие правки дипфейков.
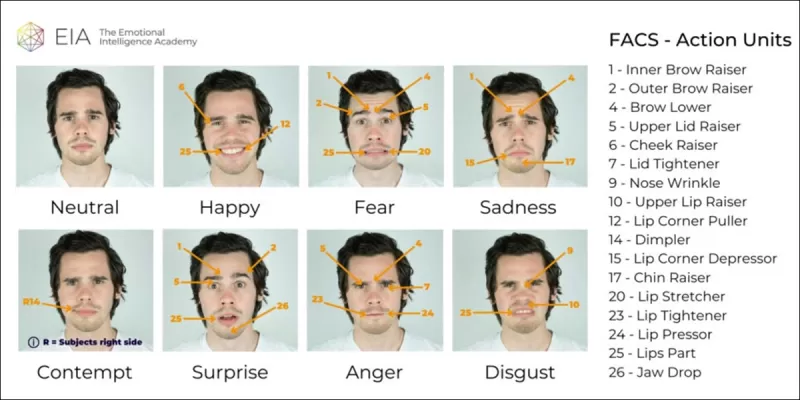 Дополнительные примеры единиц лицевых действий (FAUs, или AUs). Источник: https://www.eiagroup.com/the-facial-action-coding-system/
После предварительного обучения выходы обоих энкодеров объединяются с использованием перекрестного внимания, при этом функции на основе AU направляют внимание на пространственно-временные признаки. Это приводит к объединённому скрытому представлению, которое фиксирует как более широкий контекст движения, так и локализованные детали выражений, используемые для финальной задачи классификации.
Данные и тесты
Реализация
Система была реализована с использованием фреймворка обнаружения лиц FaceXZoo на базе PyTorch, извлекая 16 центрированных на лице кадров из каждого видеоклипа. Предварительные задачи обучались на наборе данных CelebV-HQ, который включает 35 000 высококачественных видеороликов с лицами.
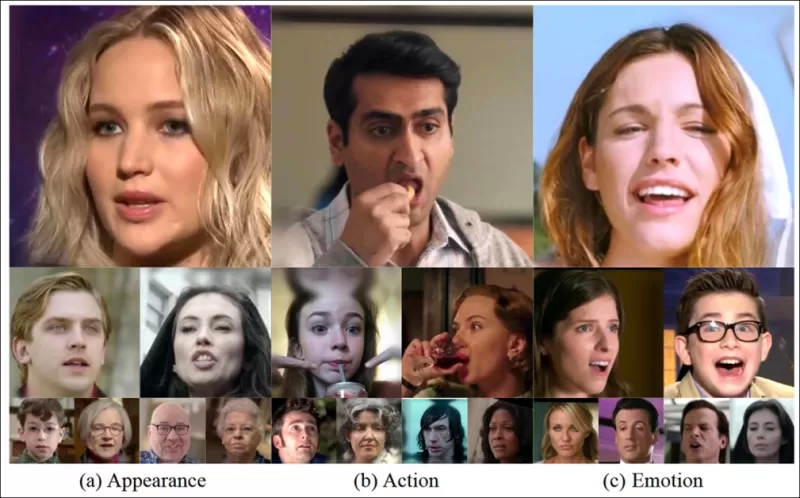 Из исходной статьи, примеры из набора данных CelebV-HQ, использованного в новом проекте. Источник: https://arxiv.org/pdf/2207.12393
Половина данных была замаскирована для предотвращения переобучения. Для задачи восстановления маскированных кадров модель обучалась предсказывать недостающие области с использованием функции потерь L1. Для второй задачи она обучалась генерировать карты для 16 единиц лицевых действий, контролируемых функцией потерь L1.
После предварительного обучения энкодеры были объединены и тонко настроены для обнаружения дипфейков с использованием набора данных FaceForensics++, который включает как реальные, так и манипулированные видео.
 Набор данных FaceForensics++ является основой для обнаружения дипфейков с 2017 года, хотя он теперь значительно устарел в отношении новейших техник синтеза лиц. Источник: https://www.youtube.com/watch?v=x2g48Q2I2ZQ
Для решения проблемы дисбаланса классов авторы использовали функцию потерь Focal Loss, акцентируя внимание на более сложных примерах во время обучения. Всё обучение проводилось на одном GPU RTX 4090 с 24 ГБ видеопамяти, используя предварительно обученные контрольные точки от VideoMAE.
Тесты
Метод был протестирован против различных техник обнаружения дипфейков, сосредоточившись на локально отредактированных дипфейках. Тесты включали ряд методов редактирования и более старые наборы данных дипфейков, используя метрики, такие как площадь под кривой (AUC), средняя точность и средний F1-показатель.
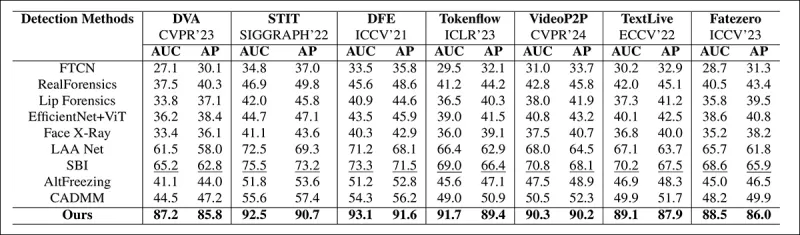 Из статьи: сравнение на недавних локализованных дипфейках показывает, что предложенный метод превзошёл все остальные, с приростом на 15–20 процентов как в AUC, так и в средней точности по сравнению с ближайшим подходом.
Авторы предоставили визуальные сравнения локально манипулированных видео, демонстрируя превосходную чувствительность их метода к тонким правкам.
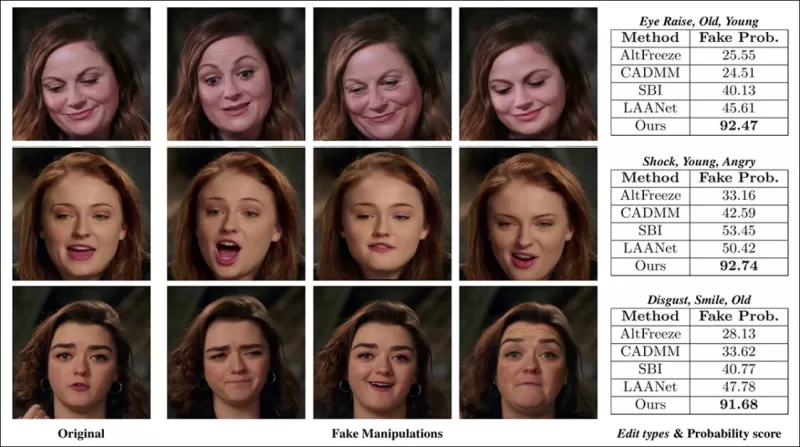 Реальное видео было изменено с использованием трёх различных локализованных манипуляций для создания подделок, которые оставались визуально похожими на оригинал. Показаны здесь представительские кадры вместе со средними оценками обнаружения подделок для каждого метода. В то время как существующие детекторы испытывали трудности с этими тонкими правками, предложенная модель стабильно присваивала высокие вероятности подделки, указывая на большую чувствительность к локализованным изменениям.
Исследователи отметили, что существующие современные методы обнаружения испытывали трудности с новейшими техниками генерации дипфейков, в то время как их метод показал устойчивую обобщающую способность, достигая высоких показателей AUC и средней точности.
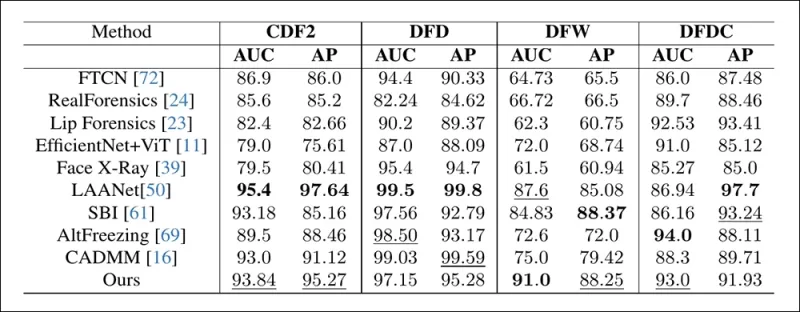 Производительность на традиционных наборах данных дипфейков показывает, что предложенный метод оставался конкурентоспособным с ведущими подходами, указывая на сильную обобщающую способность для различных типов манипуляций.
Авторы также протестировали надёжность модели в реальных условиях, обнаружив, что она устойчива к обычным искажениям видео, таким как корректировка насыщенности, гауссово размытие и пикселизация.
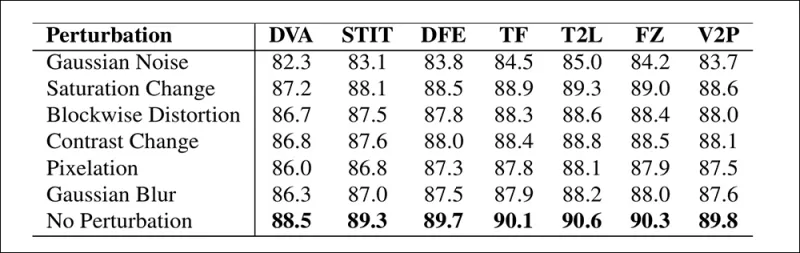 Иллюстрация того, как точность обнаружения изменяется при различных искажениях видео. Новый метод оставался устойчивым в большинстве случаев, с лишь небольшим снижением AUC. Наиболее значительное падение произошло при введении гауссова шума.
Заключение
Хотя общественность часто ассоциирует дипфейки с заменой идентичности, реальность манипуляций ИИ более тонкая и потенциально более коварная. Тип локального редактирования, обсуждаемый в этом новом исследовании, может не привлечь внимания общественности до очередного громкого инцидента. Однако, как отметил актёр Ник Кейдж, потенциал правок постпроизводства для изменения актёрских выступлений — это проблема, о которой мы все должны знать. Мы естественно чувствительны даже к малейшим изменениям в выражениях лица, и контекст может кардинально изменить их воздействие.
Впервые опубликовано в среду, 2 апреля 2025 года
Связанная статья
 OpenAI упрощает проверку изображений, сгенерированных искусственным интеллектом
По мере того как генераторы изображений на базе ИИ становятся все более распространенными и совершенными в Интернете, отличить настоящие изображения от подделок становится сложнее, чем когда-либо. Во
YouTube расширяет сферу применения технологии искусственного интеллекта для выявления дипфейков, распространив её на политиков, государственных чиновников и журналистов
Во вторник YouTube объявил о расширении доступа к своей технологии обнаружения дипфейков для определенной группы государственных чиновников, политических кандидатов и журналистов. Этот инструмент выяв
YouTube усиливает меры защиты от поддельных видеороликов, созданных с помощью искусственного интеллекта, для политиков, государственных служащих и журналистов
YouTube расширяет доступ к своей технологии распознавания лиц, предназначенной для выявления дипфейков, созданных с помощью искусственного интеллекта, в рамках пилотной программы для государственных ч
Рекомендации по связанным специальным темам
Музыкальная композиция
 Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
 8 инструментов
 xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai
Помощник по встречам
Лучшие инструменты для составления отчетов о встречах с использованием ИИ: четкое отслеживание решений и последующих действий
2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai
Анализ данных
Лучшие инструменты для очистки данных с использованием ИИ: быстрое устранение пропущенных значений и дубликатов
2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai

 Комментарии (47)
![CarlPerez]()
Honestly, the Pelosi incident still gives me chills. It's not just deepfakes; even simple speed changes can distort reality. We need better tools to detect these manipulations. 🧐
![RalphMitchell]()
この記事を読んで、AIによる映像改ざんがこんなに簡単にできるなんて怖いですね。ペロシ議長の例は氷山の一角で、もっと巧妙な偽動画がSNSで拡散される可能性があります。一般ユーザーとして、どうやって本物と偽物を見分ければいいのか悩みます。技術の進歩は素晴らしいけど、悪用されないための規制も必要じゃないかな🤔
![JustinHarris]()
Honestly, this Pelosi video case is a perfect example of how 'low-tech' AI manipulation can be the most dangerous. It doesn't need deepfakes; just slowing down footage creates a narrative. Makes you wonder what subtle edits we're already consuming daily without a second thought. The real battle for truth is in these tiny, almost invisible tweaks. 😳
![DavidRodriguez]()
Dieser Artikel erinnert mich daran, wie wichtig Medienkompetenz heute ist. Die Pelosi-Video-Manipulation war ja noch relativ plump, aber mit aktueller KI wird das bestimmt viel subtiler. Macht mir schon etwas Sorgen, vor Wahlen oder so. Wie soll man da noch zwischen echt und fake unterscheiden? 😕
![WilliamCarter]()
That Pelosi video from 2019 is wild! It’s scary how a few tweaks can make someone look totally drunk. AI’s power to mess with videos is both cool and creepy—makes you wonder what’s real anymore. 😬
![JuanMartínez]()
This Pelosi video incident is wild! 🤯 It’s scary how a few tweaks can make someone look totally out of it. Makes me wonder how much of what we see online is real anymore. AI’s cool, but this kind of stuff could mess with trust big time.
В 2019 году широко распространилось обманное видео с Нэнси Пелоси, тогда спикером Палаты представителей США. Видео, отредактированное так, чтобы она выглядела пьяной, стало ярким напоминанием о том, как легко манипулируемые медиа могут ввести в заблуждение общественность. Несмотря на свою простоту, этот инцидент подчеркнул потенциальный ущерб даже от базовых аудиовизуальных правок.
В то время ландшафт дипфейков в основном определялся технологиями замены лиц на основе автоэнкодеров, появившихся в конце 2017 года. Эти ранние системы с трудом справлялись с тонкими изменениями, как в видео с Пелоси, сосредотачиваясь вместо этого на более явных заменах лиц.
Структура 2022 года ‘Neural Emotion Director' изменяет настроение известного лица. Источник: https://www.youtube.com/watch?v=Li6W8pRDMJQ
Сегодня кино- и телеиндустрия всё больше исследует правки постпроизводства с использованием ИИ. Эта тенденция вызвала как интерес, так и критику, поскольку ИИ позволяет достичь уровня перфекционизма, ранее недоступного. В ответ научное сообщество разработало различные проекты, сосредоточенные на «локальных правках» захвата лиц, такие как Diffusion Video Autoencoders, Stitch it in Time, ChatFace, MagicFace и DISCO.
Редактирование выражений с проектом MagicFace января 2025 года. Источник: https://arxiv.org/pdf/2501.02260
Новые лица, новые морщины
Однако технологии для создания таких тонких правок развиваются гораздо быстрее, чем наша способность их обнаруживать. Большинство методов обнаружения дипфейков устарели, сосредотачиваясь на старых техниках и наборах данных. Это продолжалось до недавнего прорыва от исследователей из Индии.
Обнаружение тонких локальных правок в дипфейках: реальное видео изменяется для создания подделок с нюансными изменениями, такими как поднятые брови, изменённые гендерные черты и сдвиги в выражении в сторону отвращения (показано здесь на одном кадре). Источник: https://arxiv.org/pdf/2503.22121
Это новое исследование направлено на обнаружение тонких, локализованных манипуляций с лицами, тип подделки, который часто игнорируется. Вместо поиска широких несоответствий или несовпадений идентичности метод сосредотачивается на мелких деталях, таких как лёгкие сдвиги в выражении или незначительные правки отдельных черт лица. Он использует систему кодирования лицевых движений (FACS), которая разбивает выражения лица на 64 изменяемые области.
Некоторые из 64 составных частей выражений в FACS. Источник: https://www.cs.cmu.edu/~face/facs.htm
Исследователи протестировали свой подход против различных недавних методов редактирования и обнаружили, что он стабильно превосходит существующие решения, даже с более старыми наборами данных и новыми векторами атак.
«Используя функции на основе AU для управления видеоизображениями, изученными через маскированные автоэнкодеры (MAE), наш метод эффективно фиксирует локализованные изменения, критически важные для обнаружения тонких правок лица.»
«Этот подход позволяет нам создать единое скрытое представление, которое кодирует как локализованные правки, так и более широкие изменения в видео, сосредоточенных на лице, предоставляя всестороннее и адаптируемое решение для обнаружения дипфейков.»
Статья, озаглавленная Обнаружение локализованных манипуляций дипфейков с использованием видеоизображений, управляемых единицами действия, была написана исследователями из Индийского института технологий в Мадрасе.
Метод
Метод начинается с обнаружения лиц в видео и выборки равномерно распределённых кадров, центрированных на этих лицах. Эти кадры затем разбиваются на небольшие 3D-патчи, фиксирующие локальные пространственные и временные детали.
Схема нового метода. Входное видео обрабатывается с обнаружением лиц для извлечения равномерно распределённых, центрированных на лице кадров, которые затем делятся на «трубчатые» патчи и проходят через энкодер, который объединяет скрытые представления из двух предварительно обученных задач. Получившийся вектор затем используется классификатором для определения, является ли видео реальным или поддельным.
Каждый патч содержит небольшое окно пикселей из нескольких последовательных кадров, позволяя модели изучать краткосрочные движения и изменения выражений. Эти патчи встраиваются и позиционно кодируются перед подачей в энкодер, предназначенный для различения реальных и поддельных видео.
Задача обнаружения тонких манипуляций решается с использованием энкодера, который объединяет два типа изученных представлений через механизм перекрестного внимания, стремясь создать более чувствительное и обобщающее пространство признаков.
Предварительные задачи
Первое представление исходит от энкодера, обученного задаче маскированного автоэнкодирования. Скрывая большую часть 3D-патчей видео, энкодер учится восстанавливать недостающие части, фиксируя важные пространственно-временные шаблоны, такие как движения лица.
Обучение предварительной задаче включает маскирование частей входного видео и использование конфигурации энкодер-декодер для восстановления либо исходных кадров, либо карт единиц действия по кадрам, в зависимости от задачи.
Однако этого недостаточно для обнаружения мелкозернистых правок. Исследователи ввели второй энкодер, обученный обнаружению единиц лицевых действий (AUs), побуждая его сосредотачиваться на локализованной мышечной активности, где часто происходят тонкие правки дипфейков.
Дополнительные примеры единиц лицевых действий (FAUs, или AUs). Источник: https://www.eiagroup.com/the-facial-action-coding-system/
После предварительного обучения выходы обоих энкодеров объединяются с использованием перекрестного внимания, при этом функции на основе AU направляют внимание на пространственно-временные признаки. Это приводит к объединённому скрытому представлению, которое фиксирует как более широкий контекст движения, так и локализованные детали выражений, используемые для финальной задачи классификации.
Данные и тесты
Реализация
Система была реализована с использованием фреймворка обнаружения лиц FaceXZoo на базе PyTorch, извлекая 16 центрированных на лице кадров из каждого видеоклипа. Предварительные задачи обучались на наборе данных CelebV-HQ, который включает 35 000 высококачественных видеороликов с лицами.
Из исходной статьи, примеры из набора данных CelebV-HQ, использованного в новом проекте. Источник: https://arxiv.org/pdf/2207.12393
Половина данных была замаскирована для предотвращения переобучения. Для задачи восстановления маскированных кадров модель обучалась предсказывать недостающие области с использованием функции потерь L1. Для второй задачи она обучалась генерировать карты для 16 единиц лицевых действий, контролируемых функцией потерь L1.
После предварительного обучения энкодеры были объединены и тонко настроены для обнаружения дипфейков с использованием набора данных FaceForensics++, который включает как реальные, так и манипулированные видео.
Набор данных FaceForensics++ является основой для обнаружения дипфейков с 2017 года, хотя он теперь значительно устарел в отношении новейших техник синтеза лиц. Источник: https://www.youtube.com/watch?v=x2g48Q2I2ZQ
Для решения проблемы дисбаланса классов авторы использовали функцию потерь Focal Loss, акцентируя внимание на более сложных примерах во время обучения. Всё обучение проводилось на одном GPU RTX 4090 с 24 ГБ видеопамяти, используя предварительно обученные контрольные точки от VideoMAE.
Тесты
Метод был протестирован против различных техник обнаружения дипфейков, сосредоточившись на локально отредактированных дипфейках. Тесты включали ряд методов редактирования и более старые наборы данных дипфейков, используя метрики, такие как площадь под кривой (AUC), средняя точность и средний F1-показатель.
Из статьи: сравнение на недавних локализованных дипфейках показывает, что предложенный метод превзошёл все остальные, с приростом на 15–20 процентов как в AUC, так и в средней точности по сравнению с ближайшим подходом.
Авторы предоставили визуальные сравнения локально манипулированных видео, демонстрируя превосходную чувствительность их метода к тонким правкам.
Реальное видео было изменено с использованием трёх различных локализованных манипуляций для создания подделок, которые оставались визуально похожими на оригинал. Показаны здесь представительские кадры вместе со средними оценками обнаружения подделок для каждого метода. В то время как существующие детекторы испытывали трудности с этими тонкими правками, предложенная модель стабильно присваивала высокие вероятности подделки, указывая на большую чувствительность к локализованным изменениям.
Исследователи отметили, что существующие современные методы обнаружения испытывали трудности с новейшими техниками генерации дипфейков, в то время как их метод показал устойчивую обобщающую способность, достигая высоких показателей AUC и средней точности.
Производительность на традиционных наборах данных дипфейков показывает, что предложенный метод оставался конкурентоспособным с ведущими подходами, указывая на сильную обобщающую способность для различных типов манипуляций.
Авторы также протестировали надёжность модели в реальных условиях, обнаружив, что она устойчива к обычным искажениям видео, таким как корректировка насыщенности, гауссово размытие и пикселизация.
Иллюстрация того, как точность обнаружения изменяется при различных искажениях видео. Новый метод оставался устойчивым в большинстве случаев, с лишь небольшим снижением AUC. Наиболее значительное падение произошло при введении гауссова шума.
Заключение
Хотя общественность часто ассоциирует дипфейки с заменой идентичности, реальность манипуляций ИИ более тонкая и потенциально более коварная. Тип локального редактирования, обсуждаемый в этом новом исследовании, может не привлечь внимания общественности до очередного громкого инцидента. Однако, как отметил актёр Ник Кейдж, потенциал правок постпроизводства для изменения актёрских выступлений — это проблема, о которой мы все должны знать. Мы естественно чувствительны даже к малейшим изменениям в выражениях лица, и контекст может кардинально изменить их воздействие.
Впервые опубликовано в среду, 2 апреля 2025 года








 OpenAI упрощает проверку изображений, сгенерированных искусственным интеллектом
По мере того как генераторы изображений на базе ИИ становятся все более распространенными и совершенными в Интернете, отличить настоящие изображения от подделок становится сложнее, чем когда-либо. Во
 YouTube расширяет сферу применения технологии искусственного интеллекта для выявления дипфейков, распространив её на политиков, государственных чиновников и журналистов
Во вторник YouTube объявил о расширении доступа к своей технологии обнаружения дипфейков для определенной группы государственных чиновников, политических кандидатов и журналистов. Этот инструмент выяв
 YouTube усиливает меры защиты от поддельных видеороликов, созданных с помощью искусственного интеллекта, для политиков, государственных служащих и журналистов
YouTube расширяет доступ к своей технологии распознавания лиц, предназначенной для выявления дипфейков, созданных с помощью искусственного интеллекта, в рамках пилотной программы для государственных ч

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai

Honestly, the Pelosi incident still gives me chills. It's not just deepfakes; even simple speed changes can distort reality. We need better tools to detect these manipulations. 🧐
この記事を読んで、AIによる映像改ざんがこんなに簡単にできるなんて怖いですね。ペロシ議長の例は氷山の一角で、もっと巧妙な偽動画がSNSで拡散される可能性があります。一般ユーザーとして、どうやって本物と偽物を見分ければいいのか悩みます。技術の進歩は素晴らしいけど、悪用されないための規制も必要じゃないかな🤔
Honestly, this Pelosi video case is a perfect example of how 'low-tech' AI manipulation can be the most dangerous. It doesn't need deepfakes; just slowing down footage creates a narrative. Makes you wonder what subtle edits we're already consuming daily without a second thought. The real battle for truth is in these tiny, almost invisible tweaks. 😳
Dieser Artikel erinnert mich daran, wie wichtig Medienkompetenz heute ist. Die Pelosi-Video-Manipulation war ja noch relativ plump, aber mit aktueller KI wird das bestimmt viel subtiler. Macht mir schon etwas Sorgen, vor Wahlen oder so. Wie soll man da noch zwischen echt und fake unterscheiden? 😕
That Pelosi video from 2019 is wild! It’s scary how a few tweaks can make someone look totally drunk. AI’s power to mess with videos is both cool and creepy—makes you wonder what’s real anymore. 😬
This Pelosi video incident is wild! 🤯 It’s scary how a few tweaks can make someone look totally out of it. Makes me wonder how much of what we see online is real anymore. AI’s cool, but this kind of stuff could mess with trust big time.












