


 Maison
Défis de l'annotation par IA : Le mythe de l'étiquetage automatisé
La recherche en apprentissage automatique suppose souvent que l'IA peut améliorer les annotations des ensembles de données, en particulier les légendes d'images pour les modèles vision-langage (VLM), pour réduire les coûts et les besoins de supervision humaine.
Cela rappelle le mème des années 2000 « télécharger plus de RAM », qui se moquait de l'idée que le logiciel peut résoudre les limites matérielles.
Pourtant, la qualité de l'annotation est souvent négligée, éclipsée par l'engouement pour les nouveaux modèles d'IA, malgré son rôle crucial dans les pipelines d'apprentissage automatique.
La capacité de l'IA à identifier et reproduire des motifs dépend d'annotations humaines de haute qualité et cohérentes — étiquettes et descriptions créées par des personnes prenant des décisions subjectives dans des contextes imparfaits.
Les systèmes visant à imiter le comportement des annotateurs pour remplacer les humains et scaler l'étiquetage précis peinent face à des données non incluses dans les exemples fournis par les humains. La similarité n'équivaut pas à l'équivalence, et la cohérence inter-domaine reste insaisissable en vision par ordinateur.
En fin de compte, le jugement humain définit les données qui façonnent les systèmes d'IA.
Solutions RAG
Jusqu'à récemment, les erreurs dans les annotations des ensembles de données étaient tolérées comme des compromis mineurs étant donné les résultats imparfaits mais commercialisables de l'IA générative.
Une étude de Singapour de 2025 a révélé que les hallucinations — l'IA générant des sorties fausses — sont inhérentes à la conception de ces systèmes.
Les agents basés sur RAG, qui vérifient les faits via des recherches sur Internet, gagnent en popularité dans la recherche et les applications commerciales, mais augmentent les coûts de ressources et les délais de requête. Les nouvelles informations appliquées aux modèles entraînés manquent de la profondeur des connexions natives des modèles.
Les annotations défectueuses compromettent les performances des modèles, et améliorer leur qualité, bien qu'imparfaite en raison de la subjectivité humaine, est crucial.
Perspectives RePOPE
Une étude allemande expose les défauts des anciens ensembles de données, en se concentrant sur la précision des légendes d'images dans des benchmarks comme MSCOCO. Elle révèle comment les erreurs d'étiquetage faussent les évaluations des hallucinations dans les modèles vision-langage.
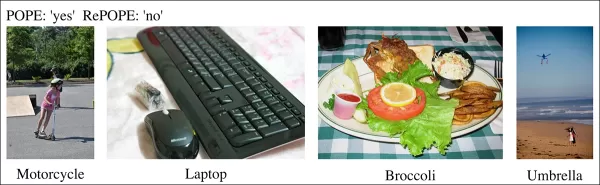
Exemples d'une étude récente montrant une identification incorrecte des objets dans les légendes de l'ensemble de données MSCOCO. Les révisions manuelles du benchmark POPE soulignent les écueils de la réduction des coûts dans la curation d'annotations. Source : https://arxiv.org/pdf/2504.15707
Considérez une IA évaluant une image de scène de rue pour un vélo. Si le modèle dit oui mais que l'ensemble de données dit non, il est marqué comme erroné. Pourtant, si un vélo est visiblement présent mais manqué dans l'annotation, le modèle est correct, et l'ensemble de données est défectueux. Ces erreurs faussent la précision du modèle et les métriques d'hallucination.
Des annotations incorrectes ou vagues peuvent faire paraître des modèles précis comme erronés ou des modèles défectueux comme fiables, compliquant le diagnostic des hallucinations et le classement des modèles.
L'étude revisite le benchmark d'évaluation par sondage d'objets (POPE), qui teste la capacité des modèles vision-langage à identifier des objets dans les images en utilisant les étiquettes MSCOCO.
POPE reformule l'hallucination comme une tâche de classification oui/non, demandant aux modèles si des objets spécifiques apparaissent dans les images, en utilisant des invites comme « Y a-t-il un dans l'image ? »
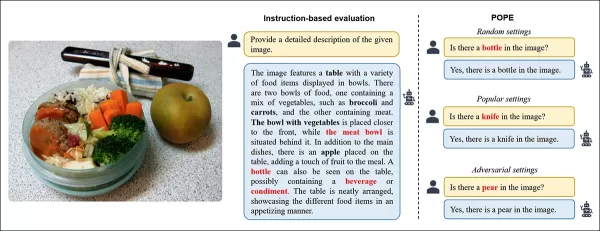
Exemples d'hallucination d'objets dans les modèles vision-langage. Les étiquettes en gras marquent les objets des annotations originales ; les étiquettes rouges soulignent les objets hallucinés par les modèles. L'exemple de gauche utilise une évaluation traditionnelle, tandis que les trois de droite proviennent de variantes POPE. Source : https://aclanthology.org/2023.emnlp-main.20.pdf
Les objets de vérité terrain (réponse : Oui) sont jumelés avec des objets inexistants (réponse : Non), sélectionnés aléatoirement, fréquemment, ou en fonction de la co-occurrence. Cela permet une évaluation stable des hallucinations, indépendante des invites, sans analyse complexe des légendes.
L'étude, RePOPE : Impact des erreurs d'annotation sur le benchmark POPE, revérifie les étiquettes MSCOCO et trouve de nombreuses erreurs ou ambiguïtés.
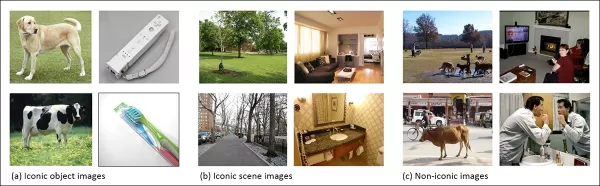
Images de l'ensemble de données MSCOCO de 2014. Source : https://arxiv.org/pdf/1405.0312
Ces erreurs modifient les classements des modèles, certains des meilleurs performeurs chutant lorsqu'évalués avec des étiquettes corrigées.
Les tests sur des modèles vision-langage à poids ouvert utilisant le POPE original et le RePOPE relabellisé montrent des changements significatifs de classement, en particulier dans les scores F1, avec plusieurs modèles en baisse de performance.
L'étude soutient que les erreurs d'annotation masquent les véritables hallucinations des modèles, présentant RePOPE comme un outil d'évaluation plus précis.
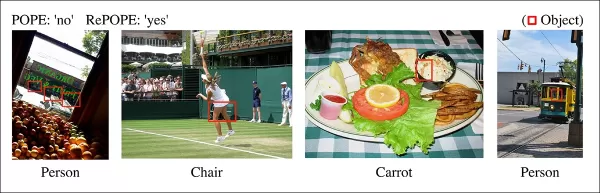
Exemples de l'étude montrant que les légendes POPE manquent des objets subtils, comme une personne près d'une cabine de tram ou une chaise obscurcie par un joueur de tennis.
Méthodologie et tests
Les chercheurs ont relabellisé les annotations MSCOCO avec deux réviseurs humains par instance. Les cas ambigus, comme ceux ci-dessous, ont été exclus des tests.
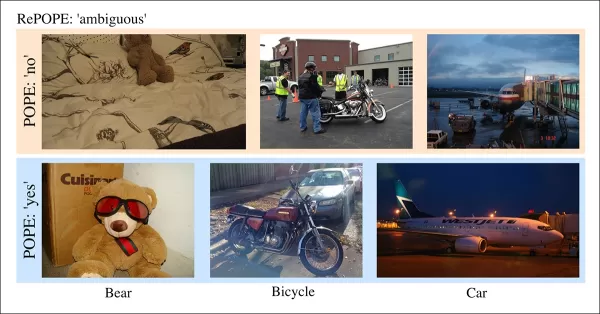
Cas ambigus dans POPE avec des étiquettes floues, comme des ours en peluche comme ours ou des motos comme vélos, exclus de RePOPE en raison de classifications subjectives et d'incohérences MSCOCO.
L'article note :
« Les annotateurs originaux ont négligé les personnes en arrière-plan ou derrière une vitre, les chaises obscurcies par un joueur de tennis, ou une carotte floue dans une salade de chou. »
« Les étiquettes MSCOCO incohérentes, comme classer un ours en peluche comme ours ou une moto comme vélo, proviennent de définitions variables des objets, marquant ces cas comme ambigus. »
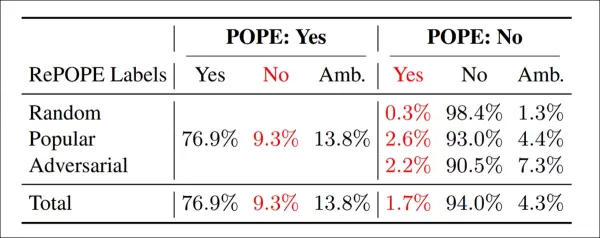
Résultats de la ré-annotation : Sur toutes les variantes POPE, 9,3 % des étiquettes « Oui » étaient incorrectes, 13,8 % ambiguës ; 1,7 % des étiquettes « Non » étaient mal étiquetées, 4,3 % ambiguës.
L'équipe a testé des modèles à poids ouvert, y compris InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B et PaliGemma2, sur POPE et RePOPE.
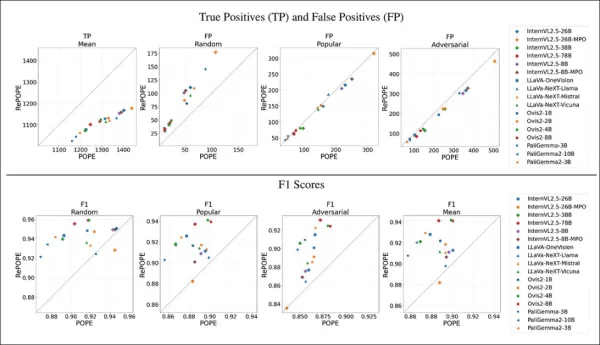
Les résultats montrent que les erreurs d'étiquettes originales ont causé une baisse des vrais positifs. Les faux positifs ont doublé sur le sous-ensemble aléatoire, sont restés stables sur le sous-ensemble populaire, et ont légèrement diminué sur le sous-ensemble adversarial. La relabellisation a modifié les classements F1, avec des modèles comme Ovis2-4B et -8B en hausse.
Les graphiques montrent que les vrais positifs ont chuté pour tous les modèles, car les réponses correctes étaient souvent basées sur des étiquettes erronées, tandis que les faux positifs variaient.
Dans le sous-ensemble aléatoire de POPE, les faux positifs ont presque doublé, révélant des objets présents mais manqués dans les annotations originales. Dans le sous-ensemble adversarial, les faux positifs ont diminué, car les objets absents étaient souvent non étiquetés mais présents.
La précision et le rappel ont été affectés, mais les classements des modèles sont restés stables. Les scores F1, métrique clé de POPE, ont changé de manière significative, avec des modèles de tête comme InternVL2.5-8B en baisse et Ovis2-4B et -8B en hausse.
Les scores de précision étaient moins fiables en raison d'exemples positifs et négatifs inégaux dans l'ensemble de données corrigé.
L'étude souligne la nécessité d'annotations de haute qualité et partage les étiquettes corrigées sur GitHub, notant que RePOPE seul ne résout pas complètement la saturation des benchmarks, car les modèles obtiennent encore plus de 90 % en vrais positifs et négatifs. Des benchmarks supplémentaires comme DASH-B sont recommandés.
Conclusion
Cette étude, réalisable grâce à la petite taille de l'ensemble de données, met en lumière les défis de la mise à l'échelle vers des ensembles de données hyperscale, où isoler des données représentatives est difficile et peut fausser les résultats.
Même si cela est réalisable, les méthodes actuelles soulignent le besoin d'annotations humaines meilleures et plus nombreuses.
« Meilleur » et « plus » posent des défis distincts. Les plateformes à faible coût comme Amazon Mechanical Turk risquent des annotations de mauvaise qualité, tandis que l'externalisation dans différentes régions peut ne pas correspondre à l'usage prévu du modèle.
Cela reste un problème central et non résolu dans l'économie de l'apprentissage automatique.
Publié pour la première fois le mercredi 23 avril 2025
Article connexe
 Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l
Le géant indien du logiciel réduit ses embauches et promet des licenciements nuls à mesure que les agents IA se développent
Alors que l’intelligence artificielle redéfinit les modèles d’affaires traditionnellement intensifs en main-d’œuvre, Tata Consultancy Services (TCS), l’un des principaux prestataires indiens de sous-traitance logicielle, a dévoilé sa réponse stratégi
La Chine verrouille les modèles d'IA pendant le Gaokao pour bloquer l'aide instantanée aux devoirs
Avec l’approche rapide du Gaokao 2026, les rumeurs concernant la suspension des outils d’intelligence artificielle pendant la période d’examen ont déclenché un intense débat en ligne. En réponse aux préoccupations du public, les principales plateform
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
 9 outils
 xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Analyse des données
Meilleurs outils de nettoyage de données IA : corrigez rapidement les valeurs manquantes et les doublons
2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai
Conception et art
Meilleurs outils d’idéation créative par IA pour les artistes : surmonter les blocages visuels
2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai
Composition musicale
Créateurs de musique par IA pour les pistes d'accompagnement TikTok, les fichiers audio Reels et la musique promotionnelle des créateurs
Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

 commentaires (2)
![RaymondWalker]()
Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
![KeithSanchez]()
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?
La recherche en apprentissage automatique suppose souvent que l'IA peut améliorer les annotations des ensembles de données, en particulier les légendes d'images pour les modèles vision-langage (VLM), pour réduire les coûts et les besoins de supervision humaine.
Cela rappelle le mème des années 2000 « télécharger plus de RAM », qui se moquait de l'idée que le logiciel peut résoudre les limites matérielles.
Pourtant, la qualité de l'annotation est souvent négligée, éclipsée par l'engouement pour les nouveaux modèles d'IA, malgré son rôle crucial dans les pipelines d'apprentissage automatique.
La capacité de l'IA à identifier et reproduire des motifs dépend d'annotations humaines de haute qualité et cohérentes — étiquettes et descriptions créées par des personnes prenant des décisions subjectives dans des contextes imparfaits.
Les systèmes visant à imiter le comportement des annotateurs pour remplacer les humains et scaler l'étiquetage précis peinent face à des données non incluses dans les exemples fournis par les humains. La similarité n'équivaut pas à l'équivalence, et la cohérence inter-domaine reste insaisissable en vision par ordinateur.
En fin de compte, le jugement humain définit les données qui façonnent les systèmes d'IA.
Solutions RAG
Jusqu'à récemment, les erreurs dans les annotations des ensembles de données étaient tolérées comme des compromis mineurs étant donné les résultats imparfaits mais commercialisables de l'IA générative.
Une étude de Singapour de 2025 a révélé que les hallucinations — l'IA générant des sorties fausses — sont inhérentes à la conception de ces systèmes.
Les agents basés sur RAG, qui vérifient les faits via des recherches sur Internet, gagnent en popularité dans la recherche et les applications commerciales, mais augmentent les coûts de ressources et les délais de requête. Les nouvelles informations appliquées aux modèles entraînés manquent de la profondeur des connexions natives des modèles.
Les annotations défectueuses compromettent les performances des modèles, et améliorer leur qualité, bien qu'imparfaite en raison de la subjectivité humaine, est crucial.
Perspectives RePOPE
Une étude allemande expose les défauts des anciens ensembles de données, en se concentrant sur la précision des légendes d'images dans des benchmarks comme MSCOCO. Elle révèle comment les erreurs d'étiquetage faussent les évaluations des hallucinations dans les modèles vision-langage.
Exemples d'une étude récente montrant une identification incorrecte des objets dans les légendes de l'ensemble de données MSCOCO. Les révisions manuelles du benchmark POPE soulignent les écueils de la réduction des coûts dans la curation d'annotations. Source : https://arxiv.org/pdf/2504.15707
Considérez une IA évaluant une image de scène de rue pour un vélo. Si le modèle dit oui mais que l'ensemble de données dit non, il est marqué comme erroné. Pourtant, si un vélo est visiblement présent mais manqué dans l'annotation, le modèle est correct, et l'ensemble de données est défectueux. Ces erreurs faussent la précision du modèle et les métriques d'hallucination.
Des annotations incorrectes ou vagues peuvent faire paraître des modèles précis comme erronés ou des modèles défectueux comme fiables, compliquant le diagnostic des hallucinations et le classement des modèles.
L'étude revisite le benchmark d'évaluation par sondage d'objets (POPE), qui teste la capacité des modèles vision-langage à identifier des objets dans les images en utilisant les étiquettes MSCOCO.
POPE reformule l'hallucination comme une tâche de classification oui/non, demandant aux modèles si des objets spécifiques apparaissent dans les images, en utilisant des invites comme « Y a-t-il un
Exemples d'hallucination d'objets dans les modèles vision-langage. Les étiquettes en gras marquent les objets des annotations originales ; les étiquettes rouges soulignent les objets hallucinés par les modèles. L'exemple de gauche utilise une évaluation traditionnelle, tandis que les trois de droite proviennent de variantes POPE. Source : https://aclanthology.org/2023.emnlp-main.20.pdf
Les objets de vérité terrain (réponse : Oui) sont jumelés avec des objets inexistants (réponse : Non), sélectionnés aléatoirement, fréquemment, ou en fonction de la co-occurrence. Cela permet une évaluation stable des hallucinations, indépendante des invites, sans analyse complexe des légendes.
L'étude, RePOPE : Impact des erreurs d'annotation sur le benchmark POPE, revérifie les étiquettes MSCOCO et trouve de nombreuses erreurs ou ambiguïtés.
Images de l'ensemble de données MSCOCO de 2014. Source : https://arxiv.org/pdf/1405.0312
Ces erreurs modifient les classements des modèles, certains des meilleurs performeurs chutant lorsqu'évalués avec des étiquettes corrigées.
Les tests sur des modèles vision-langage à poids ouvert utilisant le POPE original et le RePOPE relabellisé montrent des changements significatifs de classement, en particulier dans les scores F1, avec plusieurs modèles en baisse de performance.
L'étude soutient que les erreurs d'annotation masquent les véritables hallucinations des modèles, présentant RePOPE comme un outil d'évaluation plus précis.
Exemples de l'étude montrant que les légendes POPE manquent des objets subtils, comme une personne près d'une cabine de tram ou une chaise obscurcie par un joueur de tennis.
Méthodologie et tests
Les chercheurs ont relabellisé les annotations MSCOCO avec deux réviseurs humains par instance. Les cas ambigus, comme ceux ci-dessous, ont été exclus des tests.
Cas ambigus dans POPE avec des étiquettes floues, comme des ours en peluche comme ours ou des motos comme vélos, exclus de RePOPE en raison de classifications subjectives et d'incohérences MSCOCO.
L'article note :
« Les annotateurs originaux ont négligé les personnes en arrière-plan ou derrière une vitre, les chaises obscurcies par un joueur de tennis, ou une carotte floue dans une salade de chou. »
« Les étiquettes MSCOCO incohérentes, comme classer un ours en peluche comme ours ou une moto comme vélo, proviennent de définitions variables des objets, marquant ces cas comme ambigus. »
Résultats de la ré-annotation : Sur toutes les variantes POPE, 9,3 % des étiquettes « Oui » étaient incorrectes, 13,8 % ambiguës ; 1,7 % des étiquettes « Non » étaient mal étiquetées, 4,3 % ambiguës.
L'équipe a testé des modèles à poids ouvert, y compris InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B et PaliGemma2, sur POPE et RePOPE.
Les résultats montrent que les erreurs d'étiquettes originales ont causé une baisse des vrais positifs. Les faux positifs ont doublé sur le sous-ensemble aléatoire, sont restés stables sur le sous-ensemble populaire, et ont légèrement diminué sur le sous-ensemble adversarial. La relabellisation a modifié les classements F1, avec des modèles comme Ovis2-4B et -8B en hausse.
Les graphiques montrent que les vrais positifs ont chuté pour tous les modèles, car les réponses correctes étaient souvent basées sur des étiquettes erronées, tandis que les faux positifs variaient.
Dans le sous-ensemble aléatoire de POPE, les faux positifs ont presque doublé, révélant des objets présents mais manqués dans les annotations originales. Dans le sous-ensemble adversarial, les faux positifs ont diminué, car les objets absents étaient souvent non étiquetés mais présents.
La précision et le rappel ont été affectés, mais les classements des modèles sont restés stables. Les scores F1, métrique clé de POPE, ont changé de manière significative, avec des modèles de tête comme InternVL2.5-8B en baisse et Ovis2-4B et -8B en hausse.
Les scores de précision étaient moins fiables en raison d'exemples positifs et négatifs inégaux dans l'ensemble de données corrigé.
L'étude souligne la nécessité d'annotations de haute qualité et partage les étiquettes corrigées sur GitHub, notant que RePOPE seul ne résout pas complètement la saturation des benchmarks, car les modèles obtiennent encore plus de 90 % en vrais positifs et négatifs. Des benchmarks supplémentaires comme DASH-B sont recommandés.
Conclusion
Cette étude, réalisable grâce à la petite taille de l'ensemble de données, met en lumière les défis de la mise à l'échelle vers des ensembles de données hyperscale, où isoler des données représentatives est difficile et peut fausser les résultats.
Même si cela est réalisable, les méthodes actuelles soulignent le besoin d'annotations humaines meilleures et plus nombreuses.
« Meilleur » et « plus » posent des défis distincts. Les plateformes à faible coût comme Amazon Mechanical Turk risquent des annotations de mauvaise qualité, tandis que l'externalisation dans différentes régions peut ne pas correspondre à l'usage prévu du modèle.
Cela reste un problème central et non résolu dans l'économie de l'apprentissage automatique.
Publié pour la première fois le mercredi 23 avril 2025








 Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l
 Le géant indien du logiciel réduit ses embauches et promet des licenciements nuls à mesure que les agents IA se développent
Alors que l’intelligence artificielle redéfinit les modèles d’affaires traditionnellement intensifs en main-d’œuvre, Tata Consultancy Services (TCS), l’un des principaux prestataires indiens de sous-traitance logicielle, a dévoilé sa réponse stratégi
 La Chine verrouille les modèles d'IA pendant le Gaokao pour bloquer l'aide instantanée aux devoirs
Avec l’approche rapide du Gaokao 2026, les rumeurs concernant la suspension des outils d’intelligence artificielle pendant la période d’examen ont déclenché un intense débat en ligne. En réponse aux préoccupations du public, les principales plateform

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai

Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?












