


 Lar
Desafios de Anotação de IA: O Mito da Rotulagem Automatizada
A pesquisa em aprendizado de máquina frequentemente presume que a IA pode melhorar as anotações de conjuntos de dados, especialmente legendas de imagens para modelos de visão-linguagem (VLMs), para reduzir custos e aliviar a carga de supervisão humana.
Isso ecoa o meme do início dos anos 2000 'baixar mais RAM', zombando da ideia de que o software pode corrigir limitações de hardware.
No entanto, a qualidade da anotação é muitas vezes negligenciada, ofuscada pelo entusiasmo em torno de novos modelos de IA, apesar de seu papel crítico nos pipelines de aprendizado de máquina.
A capacidade da IA de identificar e replicar padrões depende de anotações humanas de alta qualidade e consistentes—rótulos e descrições criados por pessoas tomando decisões subjetivas em cenários imperfeitos.
Sistemas que tentam imitar o comportamento de anotadores para substituir humanos e escalar a rotulagem precisa enfrentam dificuldades quando confrontados com dados não incluídos nos exemplos fornecidos por humanos. Similaridade não equivale a equivalência, e a consistência entre domínios permanece elusiva na visão computacional.
Em última análise, o julgamento humano define os dados que moldam os sistemas de IA.
Soluções RAG
Até recentemente, erros nas anotações de conjuntos de dados eram tolerados como compensações menores, dado os resultados imperfeitos, mas comercializáveis, da IA generativa.
Um estudo de Cingapura de 2025 descobriu que alucinações—a IA gerando saídas falsas—são inerentes ao design desses sistemas.
Agentes baseados em RAG, que verificam fatos por meio de pesquisas na internet, estão ganhando tração em aplicações de pesquisa e comerciais, mas aumentam os custos de recursos e os atrasos nas consultas. Novas informações aplicadas a modelos treinados carecem da profundidade das conexões nativas do modelo.
Anotações falhas comprometem o desempenho do modelo, e melhorar sua qualidade, embora imperfeita devido à subjetividade humana, é crucial.
Insights do RePOPE
Um estudo alemão expõe falhas em conjuntos de dados mais antigos, focando na precisão das legendas de imagens em benchmarks como MSCOCO. Ele revela como erros de rótulos distorcem avaliações de alucinações em modelos de visão-linguagem.
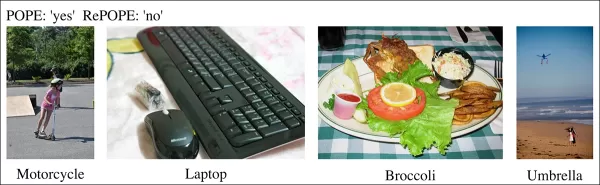
Exemplos de um estudo recente mostrando identificação incorreta de objetos nas legendas do conjunto de dados MSCOCO. Revisões manuais do benchmark POPE destacam as armadilhas de cortar custos na curadoria de anotações. Fonte: https://arxiv.org/pdf/2504.15707
Considere uma IA avaliando uma imagem de cena de rua em busca de uma bicicleta. Se o modelo diz sim, mas o conjunto de dados afirma não, ele é marcado como errado. No entanto, se uma bicicleta está visivelmente presente, mas foi omitida na anotação, o modelo está correto, e o conjunto de dados está falho. Esses erros distorcem a precisão do modelo e as métricas de alucinação.
Anotações incorretas ou vagas podem fazer modelos precisos parecerem propensos a erros ou modelos defeituosos parecerem confiáveis, complicando o diagnóstico de alucinações e a classificação de modelos.
O estudo revisita o benchmark de Avaliação de Sondagem de Objetos Baseada em Votação (POPE), que testa a capacidade dos modelos de visão-linguagem de identificar objetos em imagens usando rótulos MSCOCO.
O POPE reformula a alucinação como uma tarefa de classificação sim/não, perguntando aos modelos se objetos específicos aparecem nas imagens, usando prompts como “Há um na imagem?”
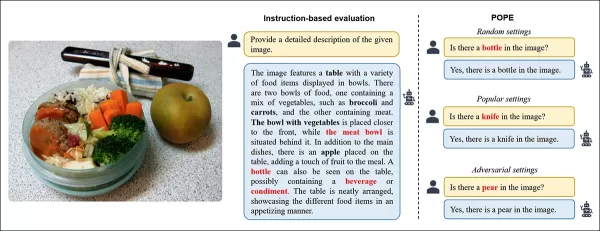
Exemplos de alucinação de objetos em modelos de visão-linguagem. Rótulos em negrito marcam objetos nas anotações originais; rótulos vermelhos destacam objetos alucinados pelo modelo. O exemplo à esquerda usa avaliação tradicional, enquanto os três à direita vêm de variantes do POPE. Fonte: https://aclanthology.org/2023.emnlp-main.20.pdf
Objetos de referência (resposta: Sim) são pareados com objetos inexistentes (resposta: Não), selecionados aleatoriamente, frequentemente ou com base em coocorrência. Isso permite uma avaliação de alucinação estável, independente de prompts, sem análise complexa de legendas.
O estudo, RePOPE: Impacto de Erros de Anotação no Benchmark POPE, verifica novamente os rótulos MSCOCO e encontra muitos erros ou ambiguidades.
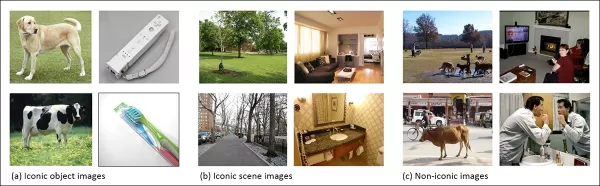
Imagens do conjunto de dados MSCOCO de 2014. Fonte: https://arxiv.org/pdf/1405.0312
Esses erros alteram as classificações de modelos, com alguns dos melhores desempenhos caindo quando avaliados contra rótulos corrigidos.
Testes em modelos de visão-linguagem de peso aberto usando o POPE original e o RePOPE re-rotulado mostram mudanças significativas nas classificações, especialmente nos escores F1, com vários modelos caindo em desempenho.
O estudo argumenta que erros de anotação escondem a verdadeira alucinação do modelo, apresentando o RePOPE como uma ferramenta de avaliação mais precisa.
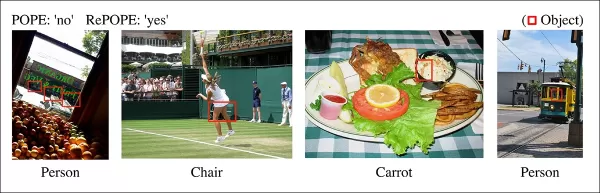
Exemplos do estudo mostrando legendas do POPE que perderam objetos sutis, como uma pessoa perto da cabine de um bonde ou uma cadeira obscurecida por um jogador de tênis.
Metodologia e Testes
Os pesquisadores re-rotularam as anotações MSCOCO com dois revisores humanos por instância. Casos ambíguos, como os abaixo, foram excluídos dos testes.
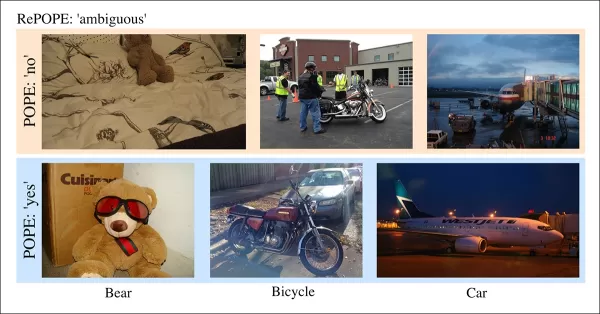
Casos ambíguos no POPE com rótulos pouco claros, como ursos de pelúcia como ursos ou motocicletas como bicicletas, excluídos do RePOPE devido a classificações subjetivas e inconsistências do MSCOCO.
O artigo observa:
“Os anotadores originais ignoraram pessoas ao fundo ou atrás de vidros, cadeiras obscurecidas por um jogador de tênis, ou uma cenoura fraca em salada de repolho.”
“Rótulos inconsistentes do MSCOCO, como classificar um urso de pelúcia como urso ou uma motocicleta como bicicleta, derivam de definições de objetos variadas, marcando esses casos como ambíguos.”
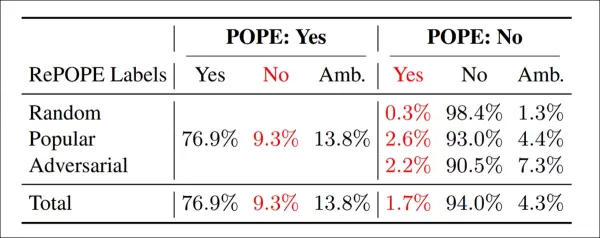
Resultados da re-anotação: Entre as variantes do POPE, 9,3% dos rótulos 'Sim' estavam incorretos, 13,8% ambíguos; 1,7% dos rótulos 'Não' estavam errados, 4,3% ambíguos.
A equipe testou modelos de peso aberto, incluindo InternVL2.5, LLaVA-NeXT, Vicuna,Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B e PaliGemma2, em POPE e RePOPE.
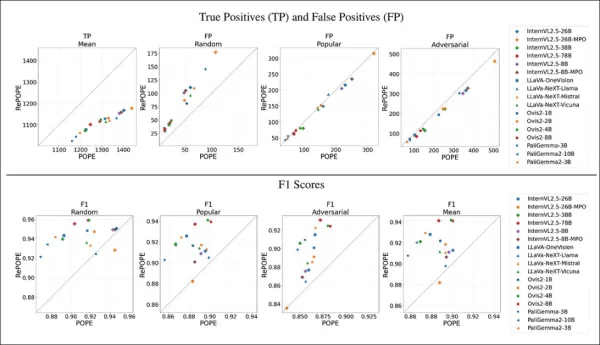
Resultados mostram que erros de rótulos originais causaram uma queda nos verdadeiros positivos. Falsos positivos dobraram no subconjunto aleatório, permaneceram estáveis no subconjunto popular e diminuíram ligeiramente no subconjunto adversário. A re-rotulagem mudou as classificações F1, com modelos como Ovis2-4B e -8B subindo ao topo.
Gráficos mostram que os verdadeiros positivos caíram entre os modelos, já que respostas corretas muitas vezes se baseavam em rótulos defeituosos, enquanto os falsos positivos variaram.
No subconjunto aleatório do POPE, os falsos positivos quase dobraram, revelando objetos presentes, mas perdidos nas anotações originais. No subconjunto adversário, os falsos positivos caíram, pois objetos ausentes muitas vezes não foram rotulados, mas estavam presentes.
Precisão e revocação foram afetadas, mas as classificações de modelos permaneceram estáveis. Os escores F1, métrica chave do POPE, mudaram significativamente, com modelos de ponta como InternVL2.5-8B caindo e Ovis2-4B e -8B subindo.
Os escores de precisão foram menos confiáveis devido a exemplos positivos e negativos desiguais no conjunto de dados corrigido.
O estudo enfatiza a necessidade de anotações de alta qualidade e compartilha rótulos corrigidos no GitHub, observando que o RePOPE sozinho não aborda completamente a saturação do benchmark, pois os modelos ainda pontuam acima de 90% em verdadeiros positivos e negativos. Benchmarks adicionais como DASH-B são recomendados.
Conclusão
Este estudo, viável devido ao pequeno conjunto de dados, destaca os desafios de escalar para conjuntos de dados em hiperescala, onde isolar dados representativos é difícil e pode distorcer resultados.
Mesmo que viável, os métodos atuais apontam para a necessidade de uma anotação humana melhor e mais extensa.
‘Melhor’ e ‘mais’ apresentam desafios distintos. Plataformas de baixo custo como Amazon Mechanical Turk arriscam anotações de baixa qualidade, enquanto a terceirização para diferentes regiões pode não se alinhar com o caso de uso pretendido do modelo.
Isso permanece um problema central e não resolvido na economia do aprendizado de máquina.
Artigo relacionado
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m
Recomendações de tópicos especiais relacionados
chatbot
 Melhores aplicativos de chat de interpretação de papéis com IA para prática de idiomas, preparação para entrevistas e fluência diária
2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
 10 ferramentas
 xix.ai
Composição musical
Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

 Comentários (2)
![RaymondWalker]()
Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
![KeithSanchez]()
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?
A pesquisa em aprendizado de máquina frequentemente presume que a IA pode melhorar as anotações de conjuntos de dados, especialmente legendas de imagens para modelos de visão-linguagem (VLMs), para reduzir custos e aliviar a carga de supervisão humana.
Isso ecoa o meme do início dos anos 2000 'baixar mais RAM', zombando da ideia de que o software pode corrigir limitações de hardware.
No entanto, a qualidade da anotação é muitas vezes negligenciada, ofuscada pelo entusiasmo em torno de novos modelos de IA, apesar de seu papel crítico nos pipelines de aprendizado de máquina.
A capacidade da IA de identificar e replicar padrões depende de anotações humanas de alta qualidade e consistentes—rótulos e descrições criados por pessoas tomando decisões subjetivas em cenários imperfeitos.
Sistemas que tentam imitar o comportamento de anotadores para substituir humanos e escalar a rotulagem precisa enfrentam dificuldades quando confrontados com dados não incluídos nos exemplos fornecidos por humanos. Similaridade não equivale a equivalência, e a consistência entre domínios permanece elusiva na visão computacional.
Em última análise, o julgamento humano define os dados que moldam os sistemas de IA.
Soluções RAG
Até recentemente, erros nas anotações de conjuntos de dados eram tolerados como compensações menores, dado os resultados imperfeitos, mas comercializáveis, da IA generativa.
Um estudo de Cingapura de 2025 descobriu que alucinações—a IA gerando saídas falsas—são inerentes ao design desses sistemas.
Agentes baseados em RAG, que verificam fatos por meio de pesquisas na internet, estão ganhando tração em aplicações de pesquisa e comerciais, mas aumentam os custos de recursos e os atrasos nas consultas. Novas informações aplicadas a modelos treinados carecem da profundidade das conexões nativas do modelo.
Anotações falhas comprometem o desempenho do modelo, e melhorar sua qualidade, embora imperfeita devido à subjetividade humana, é crucial.
Insights do RePOPE
Um estudo alemão expõe falhas em conjuntos de dados mais antigos, focando na precisão das legendas de imagens em benchmarks como MSCOCO. Ele revela como erros de rótulos distorcem avaliações de alucinações em modelos de visão-linguagem.
Exemplos de um estudo recente mostrando identificação incorreta de objetos nas legendas do conjunto de dados MSCOCO. Revisões manuais do benchmark POPE destacam as armadilhas de cortar custos na curadoria de anotações. Fonte: https://arxiv.org/pdf/2504.15707
Considere uma IA avaliando uma imagem de cena de rua em busca de uma bicicleta. Se o modelo diz sim, mas o conjunto de dados afirma não, ele é marcado como errado. No entanto, se uma bicicleta está visivelmente presente, mas foi omitida na anotação, o modelo está correto, e o conjunto de dados está falho. Esses erros distorcem a precisão do modelo e as métricas de alucinação.
Anotações incorretas ou vagas podem fazer modelos precisos parecerem propensos a erros ou modelos defeituosos parecerem confiáveis, complicando o diagnóstico de alucinações e a classificação de modelos.
O estudo revisita o benchmark de Avaliação de Sondagem de Objetos Baseada em Votação (POPE), que testa a capacidade dos modelos de visão-linguagem de identificar objetos em imagens usando rótulos MSCOCO.
O POPE reformula a alucinação como uma tarefa de classificação sim/não, perguntando aos modelos se objetos específicos aparecem nas imagens, usando prompts como “Há um
Exemplos de alucinação de objetos em modelos de visão-linguagem. Rótulos em negrito marcam objetos nas anotações originais; rótulos vermelhos destacam objetos alucinados pelo modelo. O exemplo à esquerda usa avaliação tradicional, enquanto os três à direita vêm de variantes do POPE. Fonte: https://aclanthology.org/2023.emnlp-main.20.pdf
Objetos de referência (resposta: Sim) são pareados com objetos inexistentes (resposta: Não), selecionados aleatoriamente, frequentemente ou com base em coocorrência. Isso permite uma avaliação de alucinação estável, independente de prompts, sem análise complexa de legendas.
O estudo, RePOPE: Impacto de Erros de Anotação no Benchmark POPE, verifica novamente os rótulos MSCOCO e encontra muitos erros ou ambiguidades.
Imagens do conjunto de dados MSCOCO de 2014. Fonte: https://arxiv.org/pdf/1405.0312
Esses erros alteram as classificações de modelos, com alguns dos melhores desempenhos caindo quando avaliados contra rótulos corrigidos.
Testes em modelos de visão-linguagem de peso aberto usando o POPE original e o RePOPE re-rotulado mostram mudanças significativas nas classificações, especialmente nos escores F1, com vários modelos caindo em desempenho.
O estudo argumenta que erros de anotação escondem a verdadeira alucinação do modelo, apresentando o RePOPE como uma ferramenta de avaliação mais precisa.
Exemplos do estudo mostrando legendas do POPE que perderam objetos sutis, como uma pessoa perto da cabine de um bonde ou uma cadeira obscurecida por um jogador de tênis.
Metodologia e Testes
Os pesquisadores re-rotularam as anotações MSCOCO com dois revisores humanos por instância. Casos ambíguos, como os abaixo, foram excluídos dos testes.
Casos ambíguos no POPE com rótulos pouco claros, como ursos de pelúcia como ursos ou motocicletas como bicicletas, excluídos do RePOPE devido a classificações subjetivas e inconsistências do MSCOCO.
O artigo observa:
“Os anotadores originais ignoraram pessoas ao fundo ou atrás de vidros, cadeiras obscurecidas por um jogador de tênis, ou uma cenoura fraca em salada de repolho.”
“Rótulos inconsistentes do MSCOCO, como classificar um urso de pelúcia como urso ou uma motocicleta como bicicleta, derivam de definições de objetos variadas, marcando esses casos como ambíguos.”
Resultados da re-anotação: Entre as variantes do POPE, 9,3% dos rótulos 'Sim' estavam incorretos, 13,8% ambíguos; 1,7% dos rótulos 'Não' estavam errados, 4,3% ambíguos.
A equipe testou modelos de peso aberto, incluindo InternVL2.5, LLaVA-NeXT, Vicuna,Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B e PaliGemma2, em POPE e RePOPE.
Resultados mostram que erros de rótulos originais causaram uma queda nos verdadeiros positivos. Falsos positivos dobraram no subconjunto aleatório, permaneceram estáveis no subconjunto popular e diminuíram ligeiramente no subconjunto adversário. A re-rotulagem mudou as classificações F1, com modelos como Ovis2-4B e -8B subindo ao topo.
Gráficos mostram que os verdadeiros positivos caíram entre os modelos, já que respostas corretas muitas vezes se baseavam em rótulos defeituosos, enquanto os falsos positivos variaram.
No subconjunto aleatório do POPE, os falsos positivos quase dobraram, revelando objetos presentes, mas perdidos nas anotações originais. No subconjunto adversário, os falsos positivos caíram, pois objetos ausentes muitas vezes não foram rotulados, mas estavam presentes.
Precisão e revocação foram afetadas, mas as classificações de modelos permaneceram estáveis. Os escores F1, métrica chave do POPE, mudaram significativamente, com modelos de ponta como InternVL2.5-8B caindo e Ovis2-4B e -8B subindo.
Os escores de precisão foram menos confiáveis devido a exemplos positivos e negativos desiguais no conjunto de dados corrigido.
O estudo enfatiza a necessidade de anotações de alta qualidade e compartilha rótulos corrigidos no GitHub, observando que o RePOPE sozinho não aborda completamente a saturação do benchmark, pois os modelos ainda pontuam acima de 90% em verdadeiros positivos e negativos. Benchmarks adicionais como DASH-B são recomendados.
Conclusão
Este estudo, viável devido ao pequeno conjunto de dados, destaca os desafios de escalar para conjuntos de dados em hiperescala, onde isolar dados representativos é difícil e pode distorcer resultados.
Mesmo que viável, os métodos atuais apontam para a necessidade de uma anotação humana melhor e mais extensa.
‘Melhor’ e ‘mais’ apresentam desafios distintos. Plataformas de baixo custo como Amazon Mechanical Turk arriscam anotações de baixa qualidade, enquanto a terceirização para diferentes regiões pode não se alinhar com o caso de uso pretendido do modelo.
Isso permanece um problema central e não resolvido na economia do aprendizado de máquina.








 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
 OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m

2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?












