


 家
AIアノテーションの課題:自動ラベリングの神話
機械学習研究では、AIがデータセットのアノテーション、特に視覚言語モデル(VLM)の画像キャプションを強化し、コスト削減や人間の監督負担軽減が可能とされることが多い。
これは2000年代初頭の「RAMを増やす」ミームを彷彿とさせ、ソフトウェアがハードウェアの限界を解決できるという考えを嘲笑する。
しかし、アノテーションの品質は、機械学習パイプラインで重要な役割を果たすにもかかわらず、新しいAIモデルの話題性に埋もれて見過ごされることが多い。
AIがパターンを識別し再現する能力は、高品質で一貫性のある人間のアノテーション(ラベルや説明)に依存し、それは不完全な環境で主観的な判断を行う人々によって作成される。
人間の行動を模倣して正確なラベリングをスケールアップしようとするシステムは、人間が提供した例に含まれないデータに直面すると苦戦する。類似性は同等性を意味せず、コンピュータビジョンでのクロスドメインの一貫性は依然として困難である。
最終的に、AIシステムを形成するデータは人間の判断によって定義される。
RAGソリューション
最近まで、データセットのアノテーションエラーは、生成AIの不完全だが市場性のある出力に対して、許容可能な小さなトレードオフとして扱われてきた。
2025年のシンガポール研究では、幻覚(AIが誤った出力を生成すること)がこれらのシステムの設計に内在していることがわかった。
インターネット検索を通じて事実を検証するRAGベースのエージェントは、研究や商用アプリケーションで注目を集めているが、リソースコストやクエリ遅延が増加する。訓練済みモデルに適用される新しい情報は、ネイティブモデルの接続の深さに欠ける。
欠陥のあるアノテーションはモデルの性能を損ない、その品質を改善することは、人間の主観性により不完全ではあるが、極めて重要である。
RePOPEの洞察
ドイツの研究では、古いデータセットの欠陥、特にMSCOCOのようなベンチマークでの画像キャプションの正確性に焦点を当て、ラベルエラーが視覚言語モデルの幻覚評価を歪めることを明らかにした。
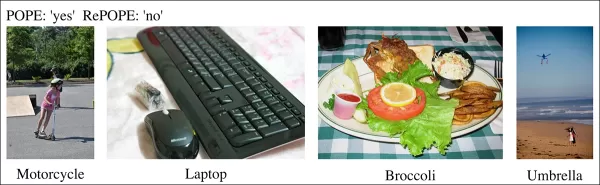
https://arxiv.org/pdf/2504.15707
自転車を評価するAIが街のシーン画像を分析し、モデルが「はい」と答えたがデータセットが「いいえ」と主張する場合、誤りとされる。しかし、画像に自転車が明確に存在するのにアノテーションが見逃した場合、モデルが正しく、データセットが欠陥となる。このようなエラーは、モデルの精度や幻覚メトリクスを歪める。
不正確または曖昧なアノテーションは、正確なモデルをエラーがあるように見せたり、欠陥のあるモデルを信頼できるように見せたりし、幻覚の診断やモデルランキングを複雑にする。
この研究は、MSCOCOラベルを使用し、視覚言語モデルの画像内オブジェクト識別能力をテストするPolling-based Object Probing Evaluation(POPE)ベンチマークを再検討する。
POPEは、幻覚をはい/いいえの分類タスクとして再構成し、モデルに「画像に
関連記事
 内部詳細が明かされた次世代ジェミニ:計算リソースの逼迫、開発チーム間で優先順位とリソース配分を巡り意見が割れた
報告によると、Googleの次世代Geminiモデルの発売は延期された。開発の優先順位とリソース配分をめぐる社内での意見の相違、限られた計算能力、複雑な承認手続きが重なり、2ヶ月の延期を余儀なくされた。独自開発のTPUチップを所有しているものの、モデルのトレーニング、Google Cloudサービス、多数の消費者向けおよび企業向けAIアプリケーションからの競合する需要により、Googleは計算資源の不足に直面している。上層部は現在、組織再編成を通じてこれらの部門間の対立に対処している。同時に、リ
OpenAI、成長鈍化への懸念を退け、複数の事業部門が加速していると表明
外部からの販売成長の鈍化や社内目標の未達に関する scrutiny に対応し、AI リーダーである OpenAI は 4 月 28 日(火曜日)、自信に満ちた声明を発表した。同社は、消費者向け製品とエンタープライズサービスが急速に進展しており、最近のビジネス減速に関する憶測を直接否定していると明らかにした。同社が「複数の社内目標を逸脱した」とする主張に対し、OpenAI はこれらの報道を「典型的なクリックベイト」と一蹴した。同社は、AI 統合に対する堅調なエンタープライズ需要を強調し、広告施策
アリババ・スーパーカップ:Qwen3.8-Max、強化されたコーディング機能とオフィスツールを搭載してデビュー
アリババは公式に、2.4兆パラメータを備えた次世代の基盤大規模モデル「Qwen3.8-Max」を発表しました。この重要なAIの進歩は、コーディングや専門的なオフィス業務といった中核領域において大幅なパフォーマンス向上をもたらし、堅牢な技術能力を示しています。権威あるArena大規模モデルランキングにおいて、Qwen3.8-Maxは目覚ましい結果を残し、AnthropicのClaudeシリーズに次ぐ順位で、業界リーダーの仲間入りを果たしました。このマイルストーンは、複雑なタスクの処理における国内
関連特集おすすめ
作曲
 曲のドラフト作成に最適なAIメロディ作成ツール
2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
 8 ツール
 xix.ai
チャットボット
面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
データ分析
最強のAIデータクリーニングツール:欠損値や重複データを迅速に修正
2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

 コメント (2)
0/500
![RaymondWalker]()
Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
![KeithSanchez]()
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?
機械学習研究では、AIがデータセットのアノテーション、特に視覚言語モデル(VLM)の画像キャプションを強化し、コスト削減や人間の監督負担軽減が可能とされることが多い。
これは2000年代初頭の「RAMを増やす」ミームを彷彿とさせ、ソフトウェアがハードウェアの限界を解決できるという考えを嘲笑する。
しかし、アノテーションの品質は、機械学習パイプラインで重要な役割を果たすにもかかわらず、新しいAIモデルの話題性に埋もれて見過ごされることが多い。
AIがパターンを識別し再現する能力は、高品質で一貫性のある人間のアノテーション(ラベルや説明)に依存し、それは不完全な環境で主観的な判断を行う人々によって作成される。
人間の行動を模倣して正確なラベリングをスケールアップしようとするシステムは、人間が提供した例に含まれないデータに直面すると苦戦する。類似性は同等性を意味せず、コンピュータビジョンでのクロスドメインの一貫性は依然として困難である。
最終的に、AIシステムを形成するデータは人間の判断によって定義される。
RAGソリューション
最近まで、データセットのアノテーションエラーは、生成AIの不完全だが市場性のある出力に対して、許容可能な小さなトレードオフとして扱われてきた。
2025年のシンガポール研究では、幻覚(AIが誤った出力を生成すること)がこれらのシステムの設計に内在していることがわかった。
インターネット検索を通じて事実を検証するRAGベースのエージェントは、研究や商用アプリケーションで注目を集めているが、リソースコストやクエリ遅延が増加する。訓練済みモデルに適用される新しい情報は、ネイティブモデルの接続の深さに欠ける。
欠陥のあるアノテーションはモデルの性能を損ない、その品質を改善することは、人間の主観性により不完全ではあるが、極めて重要である。
RePOPEの洞察
ドイツの研究では、古いデータセットの欠陥、特にMSCOCOのようなベンチマークでの画像キャプションの正確性に焦点を当て、ラベルエラーが視覚言語モデルの幻覚評価を歪めることを明らかにした。
https://arxiv.org/pdf/2504.15707
自転車を評価するAIが街のシーン画像を分析し、モデルが「はい」と答えたがデータセットが「いいえ」と主張する場合、誤りとされる。しかし、画像に自転車が明確に存在するのにアノテーションが見逃した場合、モデルが正しく、データセットが欠陥となる。このようなエラーは、モデルの精度や幻覚メトリクスを歪める。
不正確または曖昧なアノテーションは、正確なモデルをエラーがあるように見せたり、欠陥のあるモデルを信頼できるように見せたりし、幻覚の診断やモデルランキングを複雑にする。
この研究は、MSCOCOラベルを使用し、視覚言語モデルの画像内オブジェクト識別能力をテストするPolling-based Object Probing Evaluation(POPE)ベンチマークを再検討する。
POPEは、幻覚をはい/いいえの分類タスクとして再構成し、モデルに「画像に








 内部詳細が明かされた次世代ジェミニ:計算リソースの逼迫、開発チーム間で優先順位とリソース配分を巡り意見が割れた
報告によると、Googleの次世代Geminiモデルの発売は延期された。開発の優先順位とリソース配分をめぐる社内での意見の相違、限られた計算能力、複雑な承認手続きが重なり、2ヶ月の延期を余儀なくされた。独自開発のTPUチップを所有しているものの、モデルのトレーニング、Google Cloudサービス、多数の消費者向けおよび企業向けAIアプリケーションからの競合する需要により、Googleは計算資源の不足に直面している。上層部は現在、組織再編成を通じてこれらの部門間の対立に対処している。同時に、リ
 OpenAI、成長鈍化への懸念を退け、複数の事業部門が加速していると表明
外部からの販売成長の鈍化や社内目標の未達に関する scrutiny に対応し、AI リーダーである OpenAI は 4 月 28 日(火曜日)、自信に満ちた声明を発表した。同社は、消費者向け製品とエンタープライズサービスが急速に進展しており、最近のビジネス減速に関する憶測を直接否定していると明らかにした。同社が「複数の社内目標を逸脱した」とする主張に対し、OpenAI はこれらの報道を「典型的なクリックベイト」と一蹴した。同社は、AI 統合に対する堅調なエンタープライズ需要を強調し、広告施策
 アリババ・スーパーカップ:Qwen3.8-Max、強化されたコーディング機能とオフィスツールを搭載してデビュー
アリババは公式に、2.4兆パラメータを備えた次世代の基盤大規模モデル「Qwen3.8-Max」を発表しました。この重要なAIの進歩は、コーディングや専門的なオフィス業務といった中核領域において大幅なパフォーマンス向上をもたらし、堅牢な技術能力を示しています。権威あるArena大規模モデルランキングにおいて、Qwen3.8-Maxは目覚ましい結果を残し、AnthropicのClaudeシリーズに次ぐ順位で、業界リーダーの仲間入りを果たしました。このマイルストーンは、複雑なタスクの処理における国内

2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?












