


 Heim
AI-Anmerkungsherausforderungen: Der Mythos der automatisierten Kennzeichnung
Die Forschung im Bereich maschinelles Lernen geht oft davon aus, dass AI die Annotation von Datensätzen verbessern kann, insbesondere Bildunterschriften für Vision-Sprach-Modelle (VLMs), um Kosten zu senken und die Belastung durch menschliche Überwachung zu reduzieren.
Dies erinnert an den „Download mehr RAM“-Meme aus den frühen 2000er Jahren, der die Vorstellung verspottet, dass Software Hardware-Beschränkungen beheben kann.
Dennoch wird die Qualität der Annotation oft übersehen, überschattet von der Aufregung um neue AI-Modelle, obwohl sie eine entscheidende Rolle in maschinellen Lernpipelines spielt.
Die Fähigkeit von AI, Muster zu erkennen und zu replizieren, hängt von hochwertigen, konsistenten menschlichen Annotationen ab – Labels und Beschreibungen, die von Menschen in unvollkommenen Umgebungen subjektiv erstellt werden.
Systeme, die darauf abzielen, das Verhalten von Annotatoren nachzuahmen, um Menschen zu ersetzen und genaue Kennzeichnung zu skalieren, scheitern, wenn sie mit Daten konfrontiert werden, die nicht in menschlich gelieferten Beispielen enthalten sind. Ähnlichkeit ist nicht gleichbedeutend mit Gleichwertigkeit, und domänenübergreifende Konsistenz bleibt in der Computer Vision schwer erreichbar.
Letztendlich definiert menschliches Urteilsvermögen die Daten, die AI-Systeme formen.
RAG-Lösungen
Bis vor kurzem wurden Fehler in Datensatz-Annotationen als geringfügige Kompromisse toleriert, angesichts der unvollkommenen, aber marktfähigen Ergebnisse generativer AI.
Eine Studie aus Singapur 2025 stellte fest, dass Halluzinationen – AI, die falsche Ausgaben generiert – inhärent im Design dieser Systeme sind.
RAG-basierte Agenten, die Fakten über Internetsuchen verifizieren, gewinnen in Forschung und kommerziellen Anwendungen an Bedeutung, erhöhen jedoch die Ressourcenkosten und verursachen Verzögerungen bei Anfragen. Neue Informationen, die auf trainierte Modelle angewendet werden, fehlt die Tiefe nativer Modellverbindungen.
Fehlerhafte Annotationen untergraben die Modellleistung, und die Verbesserung ihrer Qualität, obwohl aufgrund menschlicher Subjektivität unvollkommen, ist entscheidend.
RePOPE-Einblicke
Eine deutsche Studie deckt Mängel in älteren Datensätzen auf, mit Fokus auf die Genauigkeit von Bildunterschriften in Benchmarks wie MSCOCO. Sie zeigt, wie Fehler in Labels die Bewertung von Halluzinationen in Vision-Sprach-Modellen verzerren.
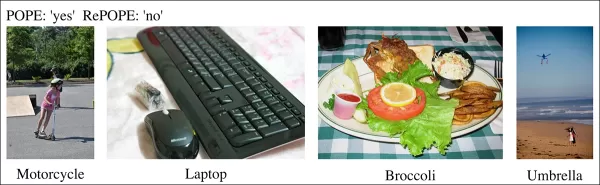
Beispiele aus einer aktuellen Studie, die falsche Objektidentifikationen in Bildunterschriften des MSCOCO-Datensatzes zeigen. Manuelle Überarbeitungen des POPE-Benchmarks verdeutlichen die Fallstricke der Kostensenkung bei der Annotationspflege. Quelle: https://arxiv.org/pdf/2504.15707
Stellen Sie sich ein AI vor, das ein Straßenbild auf ein Fahrrad hin bewertet. Wenn das Modell Ja sagt, der Datensatz aber Nein, wird es als falsch markiert. Wenn jedoch ein Fahrrad sichtbar ist, aber in der Annotation übersehen wurde, ist das Modell korrekt, und der Datensatz ist fehlerhaft. Solche Fehler verzerren die Modellgenauigkeit und Halluzinationsmetriken.
Falsche oder vage Annotationen können genaue Modelle fehleranfällig erscheinen lassen oder fehlerhafte Modelle zuverlässig wirken, was die Diagnose von Halluzinationen und die Modellbewertung erschwert.
Die Studie überprüft den Polling-based Object Probing Evaluation (POPE)-Benchmark, der die Fähigkeit von Vision-Sprach-Modellen testet, Objekte in Bildern mit MSCOCO-Labels zu identifizieren.
POPE formuliert Halluzination als Ja/Nein-Klassifikationsaufgabe und fragt Modelle, ob bestimmte Objekte in Bildern vorkommen, mit Prompts wie „Gibt es ein im Bild?“
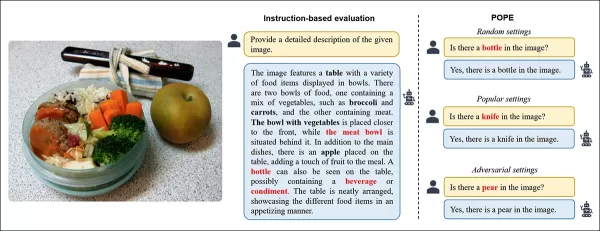
Beispiele für Objekthalluzinationen in Vision-Sprach-Modellen. Fettgedruckte Labels markieren Objekte in ursprünglichen Annotationen; rote Labels heben von Modellen halluzinierte Objekte hervor. Das linke Beispiel verwendet traditionelle Bewertung, während die drei rechten aus POPE-Varianten stammen. Quelle: https://aclanthology.org/2023.emnlp-main.20.pdf
Grundwahrheits-Objekte (Antwort: Ja) werden mit nicht existierenden Objekten (Antwort: Nein) gepaart, die zufällig, häufig oder basierend auf Co-Occurrence ausgewählt werden. Dies ermöglicht eine stabile, von Prompts unabhängige Halluzinationsbewertung ohne komplexe Bildunterschriftenanalyse.
Die Studie, RePOPE: Einfluss von Annotationsfehlern auf den POPE-Benchmark, überprüft MSCOCO-Labels und findet viele Fehler oder Mehrdeutigkeiten.
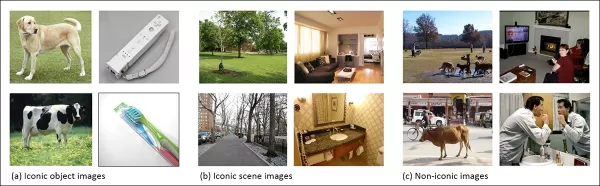
Bilder aus dem MSCOCO-Datensatz von 2014. Quelle: https://arxiv.org/pdf/1405.0312
Diese Fehler verändern die Modellrankings, wobei einige Spitzenperformer bei Bewertung mit korrigierten Labels zurückfallen.
Tests an Open-Weight-Vision-Sprach-Modellen mit dem ursprünglichen POPE und dem neu gelabelten RePOPE zeigen erhebliche Verschiebungen im Ranking, insbesondere bei F1-Scores, wobei mehrere Modelle an Leistung einbüßen.
Die Studie argumentiert, dass Annotationsfehler echte Modellhalluzinationen verbergen und präsentiert RePOPE als genaueres Bewertungstool.
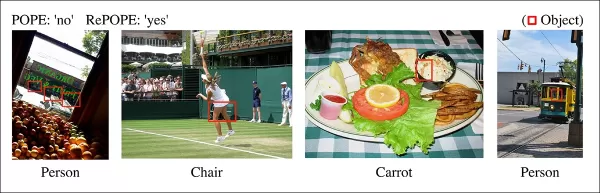
Beispiele aus der Studie zeigen, dass POPE-Bildunterschriften subtile Objekte übersehen, wie eine Person nahe einer Straßenbahnkabine oder ein vom Tennisspieler verdeckter Stuhl.
Methodik und Tests
Forscher haben MSCOCO-Annotationen mit zwei menschlichen Prüfern pro Instanz neu gelabelt. Mehrdeutige Fälle, wie die folgenden, wurden aus den Tests ausgeschlossen.
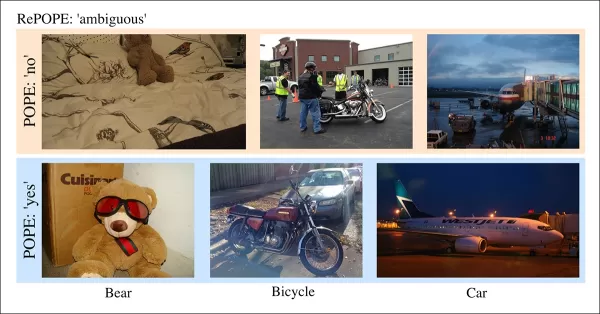
Mehrdeutige Fälle in POPE mit unklaren Labels, wie Teddybären als Bären oder Motorräder als Fahrräder, ausgeschlossen aus RePOPE aufgrund subjektiver Klassifikationen und MSCOCO-Inkonsistenzen.
Das Paper stellt fest:
„Ursprüngliche Annotatoren übersehen Menschen im Hintergrund oder hinter Glas, Stühle, die von einem Tennisspieler verdeckt werden, oder eine schwache Karotte in Krautsalat.“
„Inkonsistente MSCOCO-Labels, wie die Klassifizierung eines Teddybären als Bär oder eines Motorrads als Fahrrad, resultieren aus unterschiedlichen Objektdefinitionen, was solche Fälle als mehrdeutig kennzeichnet.“
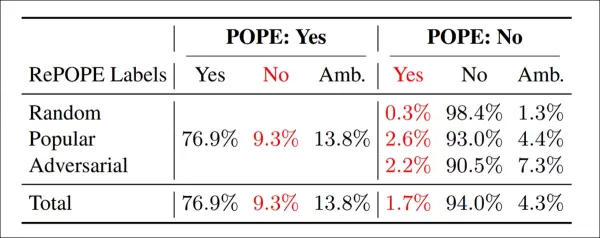
Ergebnisse der Neu-Annotation: In allen POPE-Varianten waren 9,3 % der ‚Ja‘-Labels falsch, 13,8 % mehrdeutig; 1,7 % der ‚Nein‘-Labels waren falsch gelabelt, 4,3 % mehrdeutig.
Das Team testete Open-Weight-Modelle, einschließlich InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B und PaliGemma2, anhand von POPE und RePOPE.
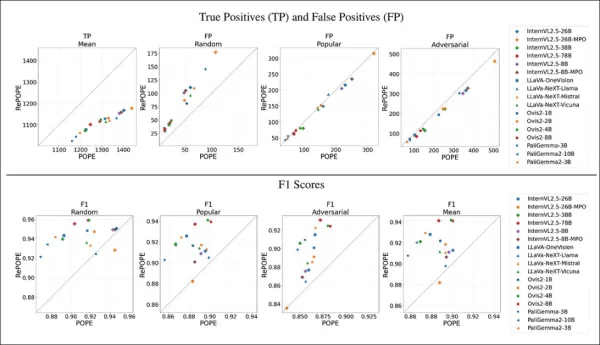
Ergebnisse zeigen, dass Fehler in den ursprünglichen Labels einen Rückgang der wahren Positiven verursachten. Falsche Positiven verdoppelten sich im zufälligen Subset, blieben im populären Subset stabil und nahmen im adversariellen Subset leicht ab. Neu-Labelung verschob F1-Rankings, wobei Modelle wie Ovis2-4B und -8B an die Spitze stiegen.
Grafiken zeigen, dass wahre Positiven bei allen Modellen zurückgingen, da korrekte Antworten oft auf fehlerhaften Labels basierten, während falsche Positiven variierten.
Im zufälligen Subset von POPE verdoppelten sich die falschen Positiven fast, da vorhandene, aber in den ursprünglichen Annotationen übersehene Objekte aufgedeckt wurden. Im adversariellen Subset sanken die falschen Positiven, da abwesende Objekte oft ungelabelt, aber vorhanden waren.
Präzision und Recall waren betroffen, aber die Modellrankings blieben stabil. F1-Scores, die zentrale Metrik von POPE, verschoben sich signifikant, wobei Top-Modelle wie InternVL2.5-8B zurückfielen und Ovis2-4B und -8B aufstiegen.
Genauigkeitsscores waren aufgrund ungleichmäßiger positiver und negativer Beispiele im korrigierten Datensatz weniger zuverlässig.
Die Studie betont die Notwendigkeit hochwertiger Annotationen und teilt korrigierte Labels auf GitHub, wobei sie anmerkt, dass RePOPE allein die Benchmarksättigung nicht vollständig löst, da Modelle immer noch über 90 % bei wahren Positiven und Negativen erreichen. Zusätzliche Benchmarks wie DASH-B werden empfohlen.
Fazit
Diese Studie, durchführbar aufgrund des kleinen Datensatzes, beleuchtet Herausforderungen bei der Skalierung auf Hyperscale-Datensätze, wo die Isolierung repräsentativer Daten schwierig ist und Ergebnisse verzerren kann.
Selbst wenn machbar, deuten aktuelle Methoden auf die Notwendigkeit besserer, umfassenderer menschlicher Annotation hin.
„Besser“ und „mehr“ stellen unterschiedliche Herausforderungen dar. Kostengünstige Plattformen wie Amazon Mechanical Turk riskieren schlechte Annotationsqualität, während Outsourcing in verschiedene Regionen nicht mit dem beabsichtigten Anwendungsfall des Modells übereinstimmen könnte.
Dies bleibt ein zentrales, ungelöstes Problem in der Ökonomie des maschinellen Lernens.
Erstmals veröffentlicht am Mittwoch, 23. April 2025
Verwandter Artikel
 Anthropic erweitert die Claude KI-Coding-Tools in Japan im Rahmen der Bemühungen um internationales Wachstum
Anthropic, ein führendes US-amerikalisches Unternehmen für künstliche Intelligenz, intensiviert seine globalen Outreach-Bemühungen. Am Mittwoch veranstaltete das Unternehmen in Tokio eine große Entwicklerkonferenz namens „Code with Claude“, an der kn
Indiens Software-Riese stellt weniger ein, verspricht aber keine Entlassungen, während KI-Agenten ausgebaut werden
Während die künstliche Intelligenz traditionelle, arbeitsintensive Geschäftsmodelle neu gestaltet, hat Tata Consultancy Services (TCS), ein führendes indisches Software-Outsourcing-Unternehmen, seine strategische Antwort vorgestellt. Während der jähr
China sperrt KI-Modelle während des Gaokam, um sofortige Hausaufgabenhilfe zu blockieren
Mit dem sich dem 2026-Gaokao schnell nähernden Termin haben Gerüchte über die Sperrung von KI-Tools während der Prüfungsphase eine intensive Online-Debatte entfacht. Als Reaktion auf die öffentlichen Bedenken haben große KI-Plattformen und Bildungs-A
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
 9 Tools
 xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai
Design & Kunst
Die besten KI-gestützten Kreativwerkzeuge für Künstler: Den Durchbruch durch visuelle Blockaden
2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai
Musikkomposition
KI-Beat-Maker für TikTok-Hintergrundmusik, Reels-Audio und Werbemusik für Creator
Die besten KI-Beat-Generatoren 2026 für TikTok-Hintergrundtracks, Reels-Audio und Promo-Musik für Creator! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechende Funktionen bieten und in der Praxis getestet wurden, um makellose Musik für jeden Content-Bedarf zu liefern. Hier findest du detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten, wöchentlich aktualisierte Rankings sowie Optionen, die du unbedingt ausprobieren solltest, um deine Kreativität und Produktivität zu steigern. Entdecke jetzt das perfekte Tool für dich!
11 Tools
xix.ai

 Kommentare (2)
![RaymondWalker]()
Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
![KeithSanchez]()
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?
Die Forschung im Bereich maschinelles Lernen geht oft davon aus, dass AI die Annotation von Datensätzen verbessern kann, insbesondere Bildunterschriften für Vision-Sprach-Modelle (VLMs), um Kosten zu senken und die Belastung durch menschliche Überwachung zu reduzieren.
Dies erinnert an den „Download mehr RAM“-Meme aus den frühen 2000er Jahren, der die Vorstellung verspottet, dass Software Hardware-Beschränkungen beheben kann.
Dennoch wird die Qualität der Annotation oft übersehen, überschattet von der Aufregung um neue AI-Modelle, obwohl sie eine entscheidende Rolle in maschinellen Lernpipelines spielt.
Die Fähigkeit von AI, Muster zu erkennen und zu replizieren, hängt von hochwertigen, konsistenten menschlichen Annotationen ab – Labels und Beschreibungen, die von Menschen in unvollkommenen Umgebungen subjektiv erstellt werden.
Systeme, die darauf abzielen, das Verhalten von Annotatoren nachzuahmen, um Menschen zu ersetzen und genaue Kennzeichnung zu skalieren, scheitern, wenn sie mit Daten konfrontiert werden, die nicht in menschlich gelieferten Beispielen enthalten sind. Ähnlichkeit ist nicht gleichbedeutend mit Gleichwertigkeit, und domänenübergreifende Konsistenz bleibt in der Computer Vision schwer erreichbar.
Letztendlich definiert menschliches Urteilsvermögen die Daten, die AI-Systeme formen.
RAG-Lösungen
Bis vor kurzem wurden Fehler in Datensatz-Annotationen als geringfügige Kompromisse toleriert, angesichts der unvollkommenen, aber marktfähigen Ergebnisse generativer AI.
Eine Studie aus Singapur 2025 stellte fest, dass Halluzinationen – AI, die falsche Ausgaben generiert – inhärent im Design dieser Systeme sind.
RAG-basierte Agenten, die Fakten über Internetsuchen verifizieren, gewinnen in Forschung und kommerziellen Anwendungen an Bedeutung, erhöhen jedoch die Ressourcenkosten und verursachen Verzögerungen bei Anfragen. Neue Informationen, die auf trainierte Modelle angewendet werden, fehlt die Tiefe nativer Modellverbindungen.
Fehlerhafte Annotationen untergraben die Modellleistung, und die Verbesserung ihrer Qualität, obwohl aufgrund menschlicher Subjektivität unvollkommen, ist entscheidend.
RePOPE-Einblicke
Eine deutsche Studie deckt Mängel in älteren Datensätzen auf, mit Fokus auf die Genauigkeit von Bildunterschriften in Benchmarks wie MSCOCO. Sie zeigt, wie Fehler in Labels die Bewertung von Halluzinationen in Vision-Sprach-Modellen verzerren.
Beispiele aus einer aktuellen Studie, die falsche Objektidentifikationen in Bildunterschriften des MSCOCO-Datensatzes zeigen. Manuelle Überarbeitungen des POPE-Benchmarks verdeutlichen die Fallstricke der Kostensenkung bei der Annotationspflege. Quelle: https://arxiv.org/pdf/2504.15707
Stellen Sie sich ein AI vor, das ein Straßenbild auf ein Fahrrad hin bewertet. Wenn das Modell Ja sagt, der Datensatz aber Nein, wird es als falsch markiert. Wenn jedoch ein Fahrrad sichtbar ist, aber in der Annotation übersehen wurde, ist das Modell korrekt, und der Datensatz ist fehlerhaft. Solche Fehler verzerren die Modellgenauigkeit und Halluzinationsmetriken.
Falsche oder vage Annotationen können genaue Modelle fehleranfällig erscheinen lassen oder fehlerhafte Modelle zuverlässig wirken, was die Diagnose von Halluzinationen und die Modellbewertung erschwert.
Die Studie überprüft den Polling-based Object Probing Evaluation (POPE)-Benchmark, der die Fähigkeit von Vision-Sprach-Modellen testet, Objekte in Bildern mit MSCOCO-Labels zu identifizieren.
POPE formuliert Halluzination als Ja/Nein-Klassifikationsaufgabe und fragt Modelle, ob bestimmte Objekte in Bildern vorkommen, mit Prompts wie „Gibt es ein
Beispiele für Objekthalluzinationen in Vision-Sprach-Modellen. Fettgedruckte Labels markieren Objekte in ursprünglichen Annotationen; rote Labels heben von Modellen halluzinierte Objekte hervor. Das linke Beispiel verwendet traditionelle Bewertung, während die drei rechten aus POPE-Varianten stammen. Quelle: https://aclanthology.org/2023.emnlp-main.20.pdf
Grundwahrheits-Objekte (Antwort: Ja) werden mit nicht existierenden Objekten (Antwort: Nein) gepaart, die zufällig, häufig oder basierend auf Co-Occurrence ausgewählt werden. Dies ermöglicht eine stabile, von Prompts unabhängige Halluzinationsbewertung ohne komplexe Bildunterschriftenanalyse.
Die Studie, RePOPE: Einfluss von Annotationsfehlern auf den POPE-Benchmark, überprüft MSCOCO-Labels und findet viele Fehler oder Mehrdeutigkeiten.
Bilder aus dem MSCOCO-Datensatz von 2014. Quelle: https://arxiv.org/pdf/1405.0312
Diese Fehler verändern die Modellrankings, wobei einige Spitzenperformer bei Bewertung mit korrigierten Labels zurückfallen.
Tests an Open-Weight-Vision-Sprach-Modellen mit dem ursprünglichen POPE und dem neu gelabelten RePOPE zeigen erhebliche Verschiebungen im Ranking, insbesondere bei F1-Scores, wobei mehrere Modelle an Leistung einbüßen.
Die Studie argumentiert, dass Annotationsfehler echte Modellhalluzinationen verbergen und präsentiert RePOPE als genaueres Bewertungstool.
Beispiele aus der Studie zeigen, dass POPE-Bildunterschriften subtile Objekte übersehen, wie eine Person nahe einer Straßenbahnkabine oder ein vom Tennisspieler verdeckter Stuhl.
Methodik und Tests
Forscher haben MSCOCO-Annotationen mit zwei menschlichen Prüfern pro Instanz neu gelabelt. Mehrdeutige Fälle, wie die folgenden, wurden aus den Tests ausgeschlossen.
Mehrdeutige Fälle in POPE mit unklaren Labels, wie Teddybären als Bären oder Motorräder als Fahrräder, ausgeschlossen aus RePOPE aufgrund subjektiver Klassifikationen und MSCOCO-Inkonsistenzen.
Das Paper stellt fest:
„Ursprüngliche Annotatoren übersehen Menschen im Hintergrund oder hinter Glas, Stühle, die von einem Tennisspieler verdeckt werden, oder eine schwache Karotte in Krautsalat.“
„Inkonsistente MSCOCO-Labels, wie die Klassifizierung eines Teddybären als Bär oder eines Motorrads als Fahrrad, resultieren aus unterschiedlichen Objektdefinitionen, was solche Fälle als mehrdeutig kennzeichnet.“
Ergebnisse der Neu-Annotation: In allen POPE-Varianten waren 9,3 % der ‚Ja‘-Labels falsch, 13,8 % mehrdeutig; 1,7 % der ‚Nein‘-Labels waren falsch gelabelt, 4,3 % mehrdeutig.
Das Team testete Open-Weight-Modelle, einschließlich InternVL2.5, LLaVA-NeXT, Vicuna, Mistral 7b, Llama, LLaVA-OneVision, Ovis2, PaliGemma-3B und PaliGemma2, anhand von POPE und RePOPE.
Ergebnisse zeigen, dass Fehler in den ursprünglichen Labels einen Rückgang der wahren Positiven verursachten. Falsche Positiven verdoppelten sich im zufälligen Subset, blieben im populären Subset stabil und nahmen im adversariellen Subset leicht ab. Neu-Labelung verschob F1-Rankings, wobei Modelle wie Ovis2-4B und -8B an die Spitze stiegen.
Grafiken zeigen, dass wahre Positiven bei allen Modellen zurückgingen, da korrekte Antworten oft auf fehlerhaften Labels basierten, während falsche Positiven variierten.
Im zufälligen Subset von POPE verdoppelten sich die falschen Positiven fast, da vorhandene, aber in den ursprünglichen Annotationen übersehene Objekte aufgedeckt wurden. Im adversariellen Subset sanken die falschen Positiven, da abwesende Objekte oft ungelabelt, aber vorhanden waren.
Präzision und Recall waren betroffen, aber die Modellrankings blieben stabil. F1-Scores, die zentrale Metrik von POPE, verschoben sich signifikant, wobei Top-Modelle wie InternVL2.5-8B zurückfielen und Ovis2-4B und -8B aufstiegen.
Genauigkeitsscores waren aufgrund ungleichmäßiger positiver und negativer Beispiele im korrigierten Datensatz weniger zuverlässig.
Die Studie betont die Notwendigkeit hochwertiger Annotationen und teilt korrigierte Labels auf GitHub, wobei sie anmerkt, dass RePOPE allein die Benchmarksättigung nicht vollständig löst, da Modelle immer noch über 90 % bei wahren Positiven und Negativen erreichen. Zusätzliche Benchmarks wie DASH-B werden empfohlen.
Fazit
Diese Studie, durchführbar aufgrund des kleinen Datensatzes, beleuchtet Herausforderungen bei der Skalierung auf Hyperscale-Datensätze, wo die Isolierung repräsentativer Daten schwierig ist und Ergebnisse verzerren kann.
Selbst wenn machbar, deuten aktuelle Methoden auf die Notwendigkeit besserer, umfassenderer menschlicher Annotation hin.
„Besser“ und „mehr“ stellen unterschiedliche Herausforderungen dar. Kostengünstige Plattformen wie Amazon Mechanical Turk riskieren schlechte Annotationsqualität, während Outsourcing in verschiedene Regionen nicht mit dem beabsichtigten Anwendungsfall des Modells übereinstimmen könnte.
Dies bleibt ein zentrales, ungelöstes Problem in der Ökonomie des maschinellen Lernens.
Erstmals veröffentlicht am Mittwoch, 23. April 2025








 Anthropic erweitert die Claude KI-Coding-Tools in Japan im Rahmen der Bemühungen um internationales Wachstum
Anthropic, ein führendes US-amerikalisches Unternehmen für künstliche Intelligenz, intensiviert seine globalen Outreach-Bemühungen. Am Mittwoch veranstaltete das Unternehmen in Tokio eine große Entwicklerkonferenz namens „Code with Claude“, an der kn
 Indiens Software-Riese stellt weniger ein, verspricht aber keine Entlassungen, während KI-Agenten ausgebaut werden
Während die künstliche Intelligenz traditionelle, arbeitsintensive Geschäftsmodelle neu gestaltet, hat Tata Consultancy Services (TCS), ein führendes indisches Software-Outsourcing-Unternehmen, seine strategische Antwort vorgestellt. Während der jähr
 China sperrt KI-Modelle während des Gaokam, um sofortige Hausaufgabenhilfe zu blockieren
Mit dem sich dem 2026-Gaokao schnell nähernden Termin haben Gerüchte über die Sperrung von KI-Tools während der Prüfungsphase eine intensive Online-Debatte entfacht. Als Reaktion auf die öffentlichen Bedenken haben große KI-Plattformen und Bildungs-A

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai

Die besten KI-Beat-Generatoren 2026 für TikTok-Hintergrundtracks, Reels-Audio und Promo-Musik für Creator! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechende Funktionen bieten und in der Praxis getestet wurden, um makellose Musik für jeden Content-Bedarf zu liefern. Hier findest du detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten, wöchentlich aktualisierte Rankings sowie Optionen, die du unbedingt ausprobieren solltest, um deine Kreativität und Produktivität zu steigern. Entdecke jetzt das perfekte Tool für dich!
11 Tools
xix.ai

Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?












