


 首页
AI标注挑战:自动化标注的神话
机器学习研究常常假设AI可以增强数据集标注,特别是视觉-语言模型(VLM)的图像描述,以降低成本和减少人工监督负担。
这让人想起2000年代初的“下载更多RAM”迷因,嘲笑软件可以解决硬件限制的想法。
然而,标注质量常常被忽视,被新AI模型的热潮所掩盖,尽管它在机器学习流程中扮演着关键角色。
AI识别和复制模式的能力依赖于高质量、一致的人工标注——由人在不完美环境中做出的主观判断所创建的标签和描述。
旨在模仿标注者行为以取代人工并扩展准确标注的系统,在面对未包含在人工提供示例中的数据时会遇到困难。相似性并不等同于等价性,跨领域一致性在计算机视觉中仍难以实现。
最终,人类判断定义了塑造AI系统的数据。
RAG解决方案
直到最近,数据集标注中的错误被视为次要权衡,因为生成式AI的输出虽不完美但具有市场价值。
2025年新加坡的一项研究发现,幻觉——AI生成虚假输出——是这些系统设计中固有的问题。
基于RAG的代理通过网络搜索验证事实,在研究和商业应用中逐渐受到关注,但增加了资源成本和查询延迟。新信息应用于训练模型时缺乏原生模型连接的深度。
有缺陷的标注会削弱模型性能,提高标注质量虽然因人类主观性而不完美,但至关重要。
RePOPE洞察
德国的一项研究揭示了旧数据集的缺陷,重点关注MSCOCO等基准测试中的图像描述准确性。它展示了标签错误如何扭曲视觉-语言模型的幻觉评估。
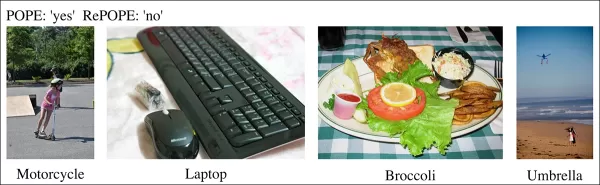
近期研究中的示例,显示MSCOCO数据集描述中物体识别错误。对POPE基准的手动修订凸显了在标注管理上节省成本的弊端。 来源:https://arxiv.org/pdf/2504.15707
考虑一个AI评估街景图像是否存在自行车。如果模型说是,但数据集声称否,则被标记为错误。然而,如果图像中明显存在自行车但标注遗漏,模型是正确的,而数据集有缺陷。此类错误会扭曲模型准确性和幻觉指标。
不正确或模糊的标注可能使准确的模型看似错误,或使有缺陷的模型看似可靠,复杂化幻觉诊断和模型排名。
该研究重新审视了基于投票的对象探测评估(POPE)基准,测试视觉-语言模型使用MSCOCO标签识别图像中物体的能力。
POPE将幻觉重新定义为是/否分类任务,通过提示如“图像中有吗?”询问模型特定物体是否出现在图像中。
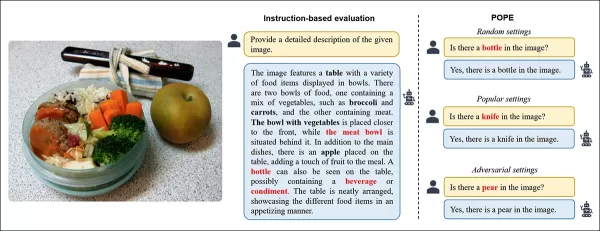
视觉-语言模型中的物体幻觉示例。加粗标签标记原始标注中的物体;红色标签高亮模型产生的幻觉物体。左侧示例使用传统评估,右侧三个示例来自POPE变体。 来源:https://aclanthology.org/2023.emnlp-main.20.pdf
真实物体(答案:是)与不存在的物体(答案:否)配对,随机、频繁或基于共现选择。这实现了无需复杂描述分析的稳定、与提示无关的幻觉评估。
该研究,RePOPE:标注错误对POPE基准的影响,重新检查MSCOCO标签,发现许多错误或模糊之处。
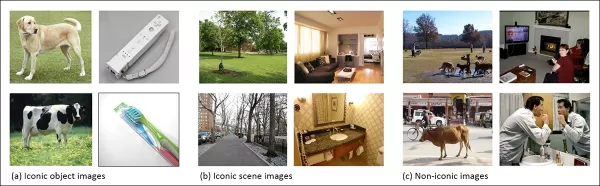
2014年MSCOCO数据集中的图像。 来源:https://arxiv.org/pdf/1405.0312
这些错误改变了模型排名,一些高性能模型在针对修正标签评估时排名下降。
在原始POPE和重新标注的RePOPE上测试开源视觉-语言模型,显示排名显著变化,特别是在F1分数上,几个模型性能下降。
该研究认为,标注错误掩盖了模型的真实幻觉,提出RePOPE作为更准确的评估工具。
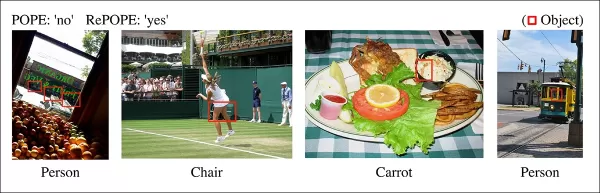
研究中的示例显示POPE描述遗漏了细微物体,如有轨电车车厢旁的人或被网球选手遮挡的椅子。
方法与测试
研究人员为MSCOCO标注重新标注,每实例由两名人工审查员处理。模糊案例,如下所述,被排除在测试之外。
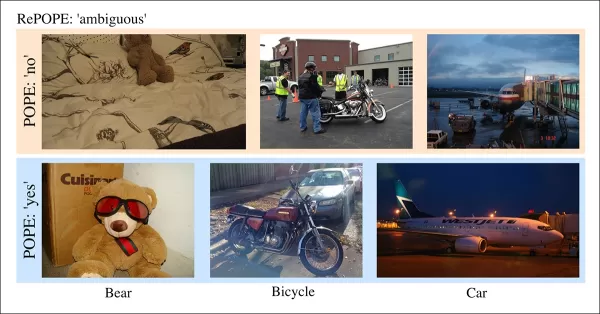
POPE中的模糊案例,如泰迪熊被标注为熊或摩托车被标注为自行车,因主观分类和MSCOCO不一致而被RePOPE排除。
论文指出:
“原始标注者忽略了背景中的人或玻璃后的人,被网球选手遮挡的椅子,或凉拌卷心菜中模糊的胡萝卜。”
“MSCOCO标签不一致,如将泰迪熊分类为熊或摩托车分类为自行车,源于不同的物体定义,使此类案例被标记为模糊。”
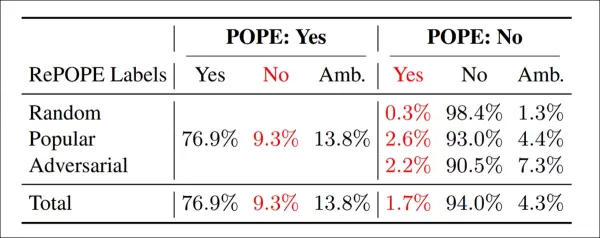
重新标注结果:在POPE变体中,‘是’标签中有9.3%不正确,13.8%模糊;‘否’标签中有1.7%错误,4.3%模糊。
团队测试了开源模型,包括InternVL2.5、LLaVA-NeXT、Vicuna、Mistral 7b、Llama、LLaVA-OneVision、Ovis2、PaliGemma-3B和PaliGemma2,跨POPE和RePOPE进行测试。
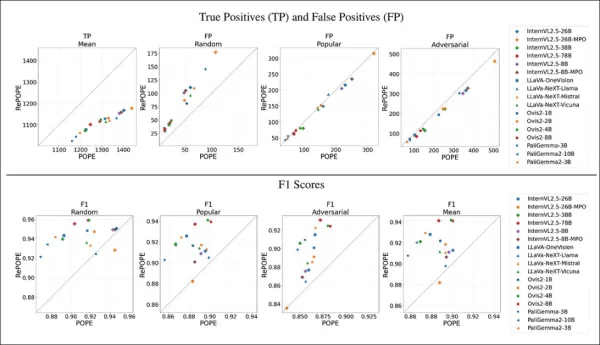
结果显示,原始标签错误导致真正例下降。虚假正例在随机子集上翻倍,流行子集上保持稳定,对抗子集上略降。重新标注改变了F1排名,Ovis2-4B和-8B等模型名列前茅。
图表显示,真正例在所有模型中下降,因为正确答案往往基于错误标签,而虚假正例变化不一。
在POPE的随机子集中,虚假正例几乎翻倍,揭示了存在但原始标注遗漏的物体。在对抗子集中,虚假正例下降,因为未标注但存在的物体常被忽略。
精确度和召回率受到影响,但模型排名保持稳定。F1分数,POPE的关键指标,显著变化,顶级模型如InternVL2.5-8B下降,Ovis2-4B和-8B上升。
由于修正数据集中正负样本不平衡,准确度分数可靠性较低。
该研究强调高质量标注的必要性,并在GitHub上共享了修正标签,指出RePOPE单独无法完全解决基准饱和问题,因为模型在真正例和负例上仍得分超过90%。建议使用DASH-B等额外基准。
结论
这项研究因数据集较小而可行,突显了扩展到超大规模数据集的挑战,隔离代表性数据很困难,可能导致结果偏差。
即使可行,当前方法表明需要更好、更广泛的人工标注。
“更好”和“更多”带来了不同挑战。像Amazon Mechanical Turk这样的低成本平台可能导致标注质量差,而外包到不同地区可能与模型预期用例不符。
这仍是机器学习经济学中一个核心、未解决的问题。
首次发布于2025年4月23日,星期三
相关文章
 苹果智能眼镜或将在WWDC27上首次亮相,重点突出隐私保护
彭博社的马克·古尔曼报道,苹果智能眼镜(内部代号 N50)计划于 2027 年 6 月的全球开发者大会(WWDC27)上首次亮相,零售版预计将于 2027 年秋季上市。该设备原定于今年晚些时候及 2027 年初发布,但现已推迟,以便进行进一步的产品完善并加强隐私保护协议。隐私仍是苹果智能眼镜战略的核心支柱。从 Meta 等竞争对手的隐私争议中吸取教训,苹果正在实施强有力的功能与政策。目前考虑的方案包括:完全移除摄像头,专注于人工智能交互、音频播放和通话;或保留摄像头但禁用照片和视频录制功能,仅
内部细节曝光:下一代 Gemini 算力紧张,内部团队在开发优先级和资源分配上存在分歧
报告显示,谷歌备受期待的下一代 Gemini 模型发布已被推迟。由于内部在开发优先级和资源分配上存在分歧,加上计算能力有限以及复杂的审批流程,导致发布时间延后了两个月。尽管谷歌拥有定制的 TPU 芯片,但由于模型训练、Google Cloud 服务以及众多消费和企业级 AI 应用对计算资源的需求相互竞争,谷歌仍面临计算资源短缺的问题。目前,高层管理人员正通过组织结构调整来解决这些部门间的冲突。与此同时,领导层也发生了变化,联合创始人谢尔盖·布林越来越多地参与到核心模型训练中,并倡导将资源专门用于
OpenAI 否认增长放缓担忧,称多个业务部门加速发展
针对外界对其销售增长放缓及未达内部基准的质疑,人工智能领域的领军企业 OpenAI 于 4 月 28 日(星期二)发表了一份信心十足的声明。该公司澄清称,其消费产品和企业服务正在快速推进,直接驳斥了近期关于业务放缓的猜测。针对该公司“未达成多项内部目标”的说法,OpenAI 将这些报道斥为“典型的标题党”。公司强调了企业对 AI 集成的强劲需求,并指出其广告业务早期增长前景良好。据 OpenAI 内部人士透露,公司内部情绪依然乐观。尽管市场竞争日益激烈,但公司正在向投资者传递信心,声称其商业
相关专题推荐
数据分析
 用于收入看板、转化漏斗分析及产品指标分析的 AI SQL 助手
2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
 9 个工具
 xix.ai
音乐创作
最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai
聊天机器人
最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

 评论 (2)
0/500
![RaymondWalker]()
Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
![KeithSanchez]()
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?
机器学习研究常常假设AI可以增强数据集标注,特别是视觉-语言模型(VLM)的图像描述,以降低成本和减少人工监督负担。
这让人想起2000年代初的“下载更多RAM”迷因,嘲笑软件可以解决硬件限制的想法。
然而,标注质量常常被忽视,被新AI模型的热潮所掩盖,尽管它在机器学习流程中扮演着关键角色。
AI识别和复制模式的能力依赖于高质量、一致的人工标注——由人在不完美环境中做出的主观判断所创建的标签和描述。
旨在模仿标注者行为以取代人工并扩展准确标注的系统,在面对未包含在人工提供示例中的数据时会遇到困难。相似性并不等同于等价性,跨领域一致性在计算机视觉中仍难以实现。
最终,人类判断定义了塑造AI系统的数据。
RAG解决方案
直到最近,数据集标注中的错误被视为次要权衡,因为生成式AI的输出虽不完美但具有市场价值。
2025年新加坡的一项研究发现,幻觉——AI生成虚假输出——是这些系统设计中固有的问题。
基于RAG的代理通过网络搜索验证事实,在研究和商业应用中逐渐受到关注,但增加了资源成本和查询延迟。新信息应用于训练模型时缺乏原生模型连接的深度。
有缺陷的标注会削弱模型性能,提高标注质量虽然因人类主观性而不完美,但至关重要。
RePOPE洞察
德国的一项研究揭示了旧数据集的缺陷,重点关注MSCOCO等基准测试中的图像描述准确性。它展示了标签错误如何扭曲视觉-语言模型的幻觉评估。
近期研究中的示例,显示MSCOCO数据集描述中物体识别错误。对POPE基准的手动修订凸显了在标注管理上节省成本的弊端。 来源:https://arxiv.org/pdf/2504.15707
考虑一个AI评估街景图像是否存在自行车。如果模型说是,但数据集声称否,则被标记为错误。然而,如果图像中明显存在自行车但标注遗漏,模型是正确的,而数据集有缺陷。此类错误会扭曲模型准确性和幻觉指标。
不正确或模糊的标注可能使准确的模型看似错误,或使有缺陷的模型看似可靠,复杂化幻觉诊断和模型排名。
该研究重新审视了基于投票的对象探测评估(POPE)基准,测试视觉-语言模型使用MSCOCO标签识别图像中物体的能力。
POPE将幻觉重新定义为是/否分类任务,通过提示如“图像中有吗?”询问模型特定物体是否出现在图像中。
视觉-语言模型中的物体幻觉示例。加粗标签标记原始标注中的物体;红色标签高亮模型产生的幻觉物体。左侧示例使用传统评估,右侧三个示例来自POPE变体。 来源:https://aclanthology.org/2023.emnlp-main.20.pdf
真实物体(答案:是)与不存在的物体(答案:否)配对,随机、频繁或基于共现选择。这实现了无需复杂描述分析的稳定、与提示无关的幻觉评估。
该研究,RePOPE:标注错误对POPE基准的影响,重新检查MSCOCO标签,发现许多错误或模糊之处。
2014年MSCOCO数据集中的图像。 来源:https://arxiv.org/pdf/1405.0312
这些错误改变了模型排名,一些高性能模型在针对修正标签评估时排名下降。
在原始POPE和重新标注的RePOPE上测试开源视觉-语言模型,显示排名显著变化,特别是在F1分数上,几个模型性能下降。
该研究认为,标注错误掩盖了模型的真实幻觉,提出RePOPE作为更准确的评估工具。
研究中的示例显示POPE描述遗漏了细微物体,如有轨电车车厢旁的人或被网球选手遮挡的椅子。
方法与测试
研究人员为MSCOCO标注重新标注,每实例由两名人工审查员处理。模糊案例,如下所述,被排除在测试之外。
POPE中的模糊案例,如泰迪熊被标注为熊或摩托车被标注为自行车,因主观分类和MSCOCO不一致而被RePOPE排除。
论文指出:
“原始标注者忽略了背景中的人或玻璃后的人,被网球选手遮挡的椅子,或凉拌卷心菜中模糊的胡萝卜。”
“MSCOCO标签不一致,如将泰迪熊分类为熊或摩托车分类为自行车,源于不同的物体定义,使此类案例被标记为模糊。”
重新标注结果:在POPE变体中,‘是’标签中有9.3%不正确,13.8%模糊;‘否’标签中有1.7%错误,4.3%模糊。
团队测试了开源模型,包括InternVL2.5、LLaVA-NeXT、Vicuna、Mistral 7b、Llama、LLaVA-OneVision、Ovis2、PaliGemma-3B和PaliGemma2,跨POPE和RePOPE进行测试。
结果显示,原始标签错误导致真正例下降。虚假正例在随机子集上翻倍,流行子集上保持稳定,对抗子集上略降。重新标注改变了F1排名,Ovis2-4B和-8B等模型名列前茅。
图表显示,真正例在所有模型中下降,因为正确答案往往基于错误标签,而虚假正例变化不一。
在POPE的随机子集中,虚假正例几乎翻倍,揭示了存在但原始标注遗漏的物体。在对抗子集中,虚假正例下降,因为未标注但存在的物体常被忽略。
精确度和召回率受到影响,但模型排名保持稳定。F1分数,POPE的关键指标,显著变化,顶级模型如InternVL2.5-8B下降,Ovis2-4B和-8B上升。
由于修正数据集中正负样本不平衡,准确度分数可靠性较低。
该研究强调高质量标注的必要性,并在GitHub上共享了修正标签,指出RePOPE单独无法完全解决基准饱和问题,因为模型在真正例和负例上仍得分超过90%。建议使用DASH-B等额外基准。
结论
这项研究因数据集较小而可行,突显了扩展到超大规模数据集的挑战,隔离代表性数据很困难,可能导致结果偏差。
即使可行,当前方法表明需要更好、更广泛的人工标注。
“更好”和“更多”带来了不同挑战。像Amazon Mechanical Turk这样的低成本平台可能导致标注质量差,而外包到不同地区可能与模型预期用例不符。
这仍是机器学习经济学中一个核心、未解决的问题。
首次发布于2025年4月23日,星期三








 苹果智能眼镜或将在WWDC27上首次亮相,重点突出隐私保护
彭博社的马克·古尔曼报道,苹果智能眼镜(内部代号 N50)计划于 2027 年 6 月的全球开发者大会(WWDC27)上首次亮相,零售版预计将于 2027 年秋季上市。该设备原定于今年晚些时候及 2027 年初发布,但现已推迟,以便进行进一步的产品完善并加强隐私保护协议。隐私仍是苹果智能眼镜战略的核心支柱。从 Meta 等竞争对手的隐私争议中吸取教训,苹果正在实施强有力的功能与政策。目前考虑的方案包括:完全移除摄像头,专注于人工智能交互、音频播放和通话;或保留摄像头但禁用照片和视频录制功能,仅
 内部细节曝光:下一代 Gemini 算力紧张,内部团队在开发优先级和资源分配上存在分歧
报告显示,谷歌备受期待的下一代 Gemini 模型发布已被推迟。由于内部在开发优先级和资源分配上存在分歧,加上计算能力有限以及复杂的审批流程,导致发布时间延后了两个月。尽管谷歌拥有定制的 TPU 芯片,但由于模型训练、Google Cloud 服务以及众多消费和企业级 AI 应用对计算资源的需求相互竞争,谷歌仍面临计算资源短缺的问题。目前,高层管理人员正通过组织结构调整来解决这些部门间的冲突。与此同时,领导层也发生了变化,联合创始人谢尔盖·布林越来越多地参与到核心模型训练中,并倡导将资源专门用于
 OpenAI 否认增长放缓担忧,称多个业务部门加速发展
针对外界对其销售增长放缓及未达内部基准的质疑,人工智能领域的领军企业 OpenAI 于 4 月 28 日(星期二)发表了一份信心十足的声明。该公司澄清称,其消费产品和企业服务正在快速推进,直接驳斥了近期关于业务放缓的猜测。针对该公司“未达成多项内部目标”的说法,OpenAI 将这些报道斥为“典型的标题党”。公司强调了企业对 AI 集成的强劲需求,并指出其广告业务早期增长前景良好。据 OpenAI 内部人士透露,公司内部情绪依然乐观。尽管市场竞争日益激烈,但公司正在向投资者传递信心,声称其商业

2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
9 个工具
xix.ai

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

Qué interesante plantean esto de la anotación automatizada. A veces da la sensación de que solo queremos reemplazar el trabajo humano sin pensar en las consecuencias... ¿Realmente es más preciso dejarle todo a la IA? 🤔 Me pregunto si esto no terminará generando más problemas de los que resuelve.
L'article sur les défis de l'annotation par IA est super intéressant ! 😊 J'avais jamais réalisé à quel point l'étiquetage automatique pouvait être un casse-tête. Ça me fait penser : est-ce qu'on surestime trop les capacités de l'IA dans ce domaine ?












