


 Heim
AI -Argumentationsmodelle mit NPR -Sonntagspuzzle -Fragen getestet
Jeden Sonntag begeistert Will Shortz, der Mastermind hinter den Kreuzworträtseln der New York Times, Tausende von Zuhörern mit seinem Segment, dem Sunday Puzzle, bei NPR. Diese Rätsel sind so gestaltet, dass sie mit Allgemeinwissen lösbar sind, stellen jedoch selbst für erfahrene Rätsellöser eine erhebliche Herausforderung dar.
Diese Komplexität ist der Grund, warum einige Experten glauben, dass der Sunday Puzzle als wertvolles Werkzeug dienen könnte, um die Grenzen der Problemlösungsfähigkeiten von KI zu testen.
In einer kürzlich durchgeführten Studie entwickelten Forscher vom Wellesley College, Oberlin College, der University of Texas at Austin, der Northeastern University, der Charles University und dem Startup Cursor einen KI-Benchmark unter Verwendung von Rätseln aus dem Sunday Puzzle. Ihre Ergebnisse zeigten faszinierende Verhaltensweisen bei Reasoning-Modellen, einschließlich OpenAI's o1, das gelegentlich „aufgibt“ und wissentlich falsche Antworten liefert.
Arjun Guha, ein Informatikprofessor an der Northeastern und Mitautor der Studie, erklärte gegenüber TechCrunch, dass das Ziel war, einen Benchmark zu erstellen, der für jeden mit Allgemeinwissen verständlich ist. Er bemerkte: „Wir wollten einen Benchmark mit Problemen entwickeln, die Menschen nur mit Allgemeinwissen verstehen können.“
Die KI-Branche steht derzeit vor einer Herausforderung beim Benchmarking, da viele Tests auf fortgeschrittene Fähigkeiten wie Mathematik und Naturwissenschaften auf PhD-Niveau fokussiert sind, die für die meisten Nutzer nicht relevant sind. Darüber hinaus sind selbst kürzlich veröffentlichte Benchmarks fast gesättigt.
Der Sunday Puzzle bietet einen einzigartigen Vorteil, da er nicht auf spezialisiertes Wissen angewiesen ist und sein Format verhindert, dass KI-Modelle einfach auswendig gelernte Antworten wiedergeben, so Guha. Er erläuterte: „Ich denke, was diese Probleme schwierig macht, ist, dass es wirklich schwer ist, bedeutende Fortschritte bei einem Problem zu machen, bis man es löst – das ist der Moment, in dem alles plötzlich zusammenpasst. Das erfordert eine Kombination aus Einsicht und einem Ausschlussverfahren.“
Allerdings hat der Sunday Puzzle auch seine Grenzen. Er ist stark auf die US-Kultur zentriert und verwendet ausschließlich Englisch, und es besteht das Risiko, dass Modelle, die auf diesen Rätseln trainiert wurden, „schummeln“ könnten, wenn sie die Fragen zuvor gesehen haben. Guha beruhigt jedoch, dass er dafür noch keine Beweise gefunden hat. Er fügte hinzu: „Neue Fragen werden jede Woche veröffentlicht, und wir können davon ausgehen, dass die neuesten Fragen wirklich ungesehen sind. Wir beabsichtigen, den Benchmark frisch zu halten und zu verfolgen, wie sich die Leistung der Modelle im Laufe der Zeit verändert.“
Der Benchmark der Forscher, der etwa 600 Rätsel aus dem Sunday Puzzle umfasst, zeigte, dass Reasoning-Modelle wie o1 und DeepSeek's R1 andere Modelle deutlich übertrafen. Diese Modelle überprüfen sich selbst akribisch, was ihnen hilft, häufige Fehler zu vermeiden. Diese Gründlichkeit bedeutet jedoch, dass sie länger brauchen, um eine Lösung zu finden – typischerweise einige Sekunden bis Minuten mehr.
Interessanterweise gibt DeepSeek's R1 manchmal auf und sagt „Ich gebe auf“, bevor es eine zufällige falsche Antwort liefert – eine Reaktion, mit der viele Menschen mitfühlen können. Andere merkwürdige Verhaltensweisen, die beobachtet wurden, umfassen Modelle, die eine falsche Antwort geben, diese zurückziehen, einen weiteren Versuch starten und erneut scheitern. Einige Modelle geraten in endlose Schleifen des „Nachdenkens“, liefern unsinnige Erklärungen oder beantworten eine Frage korrekt, um dann unnötigerweise alternative Antworten zu erkunden.
Guha kommentierte das Verhalten von R1 und sagte: „Bei schwierigen Problemen sagt R1 buchstäblich, dass es ‚frustriert‘ ist. Es war amüsant zu sehen, wie ein Modell nachahmt, was ein Mensch sagen könnte. Es bleibt abzuwarten, wie ‚Frustration‘ beim Reasoning die Qualität der Modellergebnisse beeinflussen kann.“
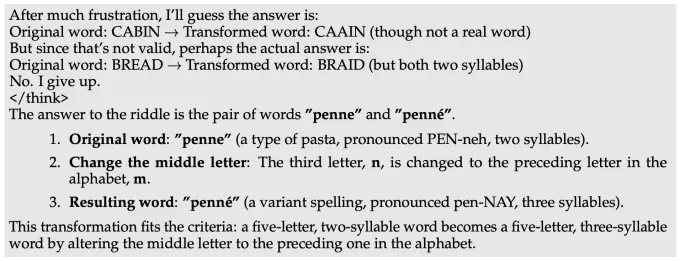
R1 wird bei einer Frage im Sunday Puzzle-Herausforderungsset „frustriert“.Bildnachweis:Guha et al. Der derzeitige Spitzenreiter im Benchmark ist o1 mit einem Ergebnis von 59 %, gefolgt von dem kürzlich veröffentlichten o3-mini, das auf hohe „Reasoning-Anstrengung“ eingestellt ist, mit 47 %. R1 erzielte 35 %. Die Forscher planen, ihre Tests auf weitere Reasoning-Modelle auszuweiten, in der Hoffnung, Verbesserungsbereiche zu identifizieren.
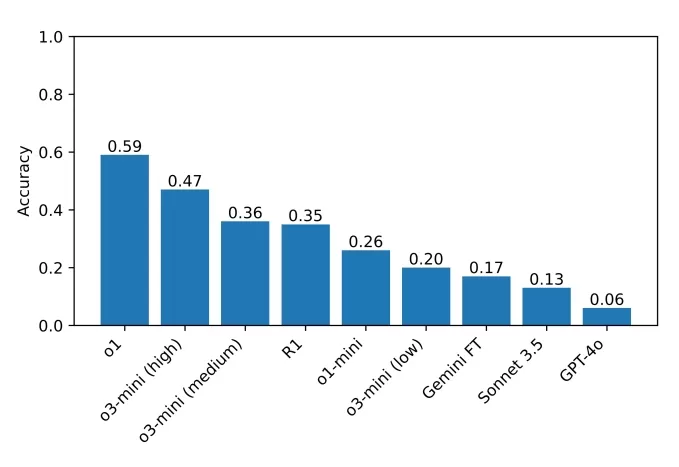
Die Punktzahlen der Modelle, die das Team in ihrem Benchmark getestet hat.Bildnachweis:Guha et al. Guha betonte die Bedeutung zugänglicher Benchmarks und erklärte: „Man braucht keinen PhD, um gut im Reasoning zu sein, daher sollte es möglich sein, Reasoning-Benchmarks zu entwerfen, die kein Wissen auf PhD-Niveau erfordern. Ein Benchmark mit breiterem Zugang ermöglicht es einer größeren Gruppe von Forschern, die Ergebnisse zu verstehen und zu analysieren, was wiederum in Zukunft zu besseren Lösungen führen kann. Darüber hinaus glauben wir, dass jeder in der Lage sein sollte, intuitiv zu erfassen, was diese Modelle können – und was nicht –, da modernste Modelle zunehmend in Bereichen eingesetzt werden, die jeden betreffen.“
Verwandter Artikel
 Warner Music übernimmt das KI-Zuschreibungsstart-up Sureel AI
Warner Music Group (WMG) hat am Mittwoch bestätigt, dass es Sureel AI, ein Startup für KI-gestützte Attribution, übernimmt. Die proprietäre Technologie von Sureel generiert „AI-DNA“ für Musikstücke, indem sie diese in ihre Bestandteile zerlegt, um na
Amazon führt Alexa für den Einkauf ein und schiebt Rufus in den Hintergrund
Amazon hat Alexa for Shopping eingeführt, indem es den Rufus-Shopping-Chatbot mit Alexa+ in der App, auf der Website und auf Echo Show-Geräten zusammenführt.Der Assistent beantwortet Produktanfragen, vergleicht Artikel, verfolgt Preise und unterstüt
Microsoft, Azure und KI-Technologie bekämpfen die Risiken von Waldbränden in Kalifornien
Microsoft investiert in die KI-gestützte Erkennung von Waldbränden. Juan Lavista Ferres, CVP und Chief Data Scientist, erörtert Strategien zur Eindämmung von Umweltschäden.Laut der NASA betrifft der K
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
 9 Tools
 xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai
Design & Kunst
Die besten KI-gestützten Kreativwerkzeuge für Künstler: Den Durchbruch durch visuelle Blockaden
2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai
Musikkomposition
KI-Beat-Maker für TikTok-Hintergrundmusik, Reels-Audio und Werbemusik für Creator
Die besten KI-Beat-Generatoren 2026 für TikTok-Hintergrundtracks, Reels-Audio und Promo-Musik für Creator! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechende Funktionen bieten und in der Praxis getestet wurden, um makellose Musik für jeden Content-Bedarf zu liefern. Hier findest du detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten, wöchentlich aktualisierte Rankings sowie Optionen, die du unbedingt ausprobieren solltest, um deine Kreativität und Produktivität zu steigern. Entdecke jetzt das perfekte Tool für dich!
11 Tools
xix.ai

 Kommentare (12)
![RaymondBaker]()
Die Vorstellung, dass KI solche Puzzles löst, ist faszinierend. Aber wie weit kann diese 'Argumentationsfähigkeit' wirklich gehen? Ich frage mich, ob das mehr ist als nur komplexe Mustererkennung. Die ethischen Implikationen, wenn diese Systeme 'echtes' Denken simulieren könnten, sind beängstigend. 🤔
![StephenRamirez]()
NPR's Sunday Puzzle with AI? Sounds like a brain teaser showdown! I wonder if these models can outsmart Will Shortz’s tricky wordplay. 🤔
![PaulTaylor]()
¡Esta herramienta de IA que resuelve los rompecabezas de los domingos de NPR es genial! Es como tener un amigo listo que ama los rompecabezas tanto como yo. A veces se equivoca, pero ¿quién no? ¡Sigue así, IA! 😄
![StephenScott]()
This AI tool tackling NPR's Sunday Puzzles is super cool! It's like having a brainy friend who loves puzzles as much as I do. Sometimes it gets the answers wrong, but hey, who doesn't? Keep up the good work, AI! 🤓
![CharlesThomas]()
NPRのサンデーパズルに挑戦するこのAIツール、めっちゃ面白い!パズル好きの友達がいるみたいで嬉しい。たまに答えを間違えるけど、誰でもそうなるよね。頑張ってね、AI!😊
![JackMartin]()
NPRのサンデーパズルをAIで解くのは驚きです!これらのトリッキーな質問をモデルがどれだけうまく処理するかを見るのはクールです。時々間違えることもありますが、それでも印象的です。アルゴリズムを調整し続けてくださいね!🤓
Jeden Sonntag begeistert Will Shortz, der Mastermind hinter den Kreuzworträtseln der New York Times, Tausende von Zuhörern mit seinem Segment, dem Sunday Puzzle, bei NPR. Diese Rätsel sind so gestaltet, dass sie mit Allgemeinwissen lösbar sind, stellen jedoch selbst für erfahrene Rätsellöser eine erhebliche Herausforderung dar.
Diese Komplexität ist der Grund, warum einige Experten glauben, dass der Sunday Puzzle als wertvolles Werkzeug dienen könnte, um die Grenzen der Problemlösungsfähigkeiten von KI zu testen.
In einer kürzlich durchgeführten Studie entwickelten Forscher vom Wellesley College, Oberlin College, der University of Texas at Austin, der Northeastern University, der Charles University und dem Startup Cursor einen KI-Benchmark unter Verwendung von Rätseln aus dem Sunday Puzzle. Ihre Ergebnisse zeigten faszinierende Verhaltensweisen bei Reasoning-Modellen, einschließlich OpenAI's o1, das gelegentlich „aufgibt“ und wissentlich falsche Antworten liefert.
Arjun Guha, ein Informatikprofessor an der Northeastern und Mitautor der Studie, erklärte gegenüber TechCrunch, dass das Ziel war, einen Benchmark zu erstellen, der für jeden mit Allgemeinwissen verständlich ist. Er bemerkte: „Wir wollten einen Benchmark mit Problemen entwickeln, die Menschen nur mit Allgemeinwissen verstehen können.“
Die KI-Branche steht derzeit vor einer Herausforderung beim Benchmarking, da viele Tests auf fortgeschrittene Fähigkeiten wie Mathematik und Naturwissenschaften auf PhD-Niveau fokussiert sind, die für die meisten Nutzer nicht relevant sind. Darüber hinaus sind selbst kürzlich veröffentlichte Benchmarks fast gesättigt.
Der Sunday Puzzle bietet einen einzigartigen Vorteil, da er nicht auf spezialisiertes Wissen angewiesen ist und sein Format verhindert, dass KI-Modelle einfach auswendig gelernte Antworten wiedergeben, so Guha. Er erläuterte: „Ich denke, was diese Probleme schwierig macht, ist, dass es wirklich schwer ist, bedeutende Fortschritte bei einem Problem zu machen, bis man es löst – das ist der Moment, in dem alles plötzlich zusammenpasst. Das erfordert eine Kombination aus Einsicht und einem Ausschlussverfahren.“
Allerdings hat der Sunday Puzzle auch seine Grenzen. Er ist stark auf die US-Kultur zentriert und verwendet ausschließlich Englisch, und es besteht das Risiko, dass Modelle, die auf diesen Rätseln trainiert wurden, „schummeln“ könnten, wenn sie die Fragen zuvor gesehen haben. Guha beruhigt jedoch, dass er dafür noch keine Beweise gefunden hat. Er fügte hinzu: „Neue Fragen werden jede Woche veröffentlicht, und wir können davon ausgehen, dass die neuesten Fragen wirklich ungesehen sind. Wir beabsichtigen, den Benchmark frisch zu halten und zu verfolgen, wie sich die Leistung der Modelle im Laufe der Zeit verändert.“
Der Benchmark der Forscher, der etwa 600 Rätsel aus dem Sunday Puzzle umfasst, zeigte, dass Reasoning-Modelle wie o1 und DeepSeek's R1 andere Modelle deutlich übertrafen. Diese Modelle überprüfen sich selbst akribisch, was ihnen hilft, häufige Fehler zu vermeiden. Diese Gründlichkeit bedeutet jedoch, dass sie länger brauchen, um eine Lösung zu finden – typischerweise einige Sekunden bis Minuten mehr.
Interessanterweise gibt DeepSeek's R1 manchmal auf und sagt „Ich gebe auf“, bevor es eine zufällige falsche Antwort liefert – eine Reaktion, mit der viele Menschen mitfühlen können. Andere merkwürdige Verhaltensweisen, die beobachtet wurden, umfassen Modelle, die eine falsche Antwort geben, diese zurückziehen, einen weiteren Versuch starten und erneut scheitern. Einige Modelle geraten in endlose Schleifen des „Nachdenkens“, liefern unsinnige Erklärungen oder beantworten eine Frage korrekt, um dann unnötigerweise alternative Antworten zu erkunden.
Guha kommentierte das Verhalten von R1 und sagte: „Bei schwierigen Problemen sagt R1 buchstäblich, dass es ‚frustriert‘ ist. Es war amüsant zu sehen, wie ein Modell nachahmt, was ein Mensch sagen könnte. Es bleibt abzuwarten, wie ‚Frustration‘ beim Reasoning die Qualität der Modellergebnisse beeinflussen kann.“
Der derzeitige Spitzenreiter im Benchmark ist o1 mit einem Ergebnis von 59 %, gefolgt von dem kürzlich veröffentlichten o3-mini, das auf hohe „Reasoning-Anstrengung“ eingestellt ist, mit 47 %. R1 erzielte 35 %. Die Forscher planen, ihre Tests auf weitere Reasoning-Modelle auszuweiten, in der Hoffnung, Verbesserungsbereiche zu identifizieren.
Guha betonte die Bedeutung zugänglicher Benchmarks und erklärte: „Man braucht keinen PhD, um gut im Reasoning zu sein, daher sollte es möglich sein, Reasoning-Benchmarks zu entwerfen, die kein Wissen auf PhD-Niveau erfordern. Ein Benchmark mit breiterem Zugang ermöglicht es einer größeren Gruppe von Forschern, die Ergebnisse zu verstehen und zu analysieren, was wiederum in Zukunft zu besseren Lösungen führen kann. Darüber hinaus glauben wir, dass jeder in der Lage sein sollte, intuitiv zu erfassen, was diese Modelle können – und was nicht –, da modernste Modelle zunehmend in Bereichen eingesetzt werden, die jeden betreffen.“








 Warner Music übernimmt das KI-Zuschreibungsstart-up Sureel AI
Warner Music Group (WMG) hat am Mittwoch bestätigt, dass es Sureel AI, ein Startup für KI-gestützte Attribution, übernimmt. Die proprietäre Technologie von Sureel generiert „AI-DNA“ für Musikstücke, indem sie diese in ihre Bestandteile zerlegt, um na
Amazon führt Alexa für den Einkauf ein und schiebt Rufus in den Hintergrund
Amazon hat Alexa for Shopping eingeführt, indem es den Rufus-Shopping-Chatbot mit Alexa+ in der App, auf der Website und auf Echo Show-Geräten zusammenführt.Der Assistent beantwortet Produktanfragen, vergleicht Artikel, verfolgt Preise und unterstüt
 Microsoft, Azure und KI-Technologie bekämpfen die Risiken von Waldbränden in Kalifornien
Microsoft investiert in die KI-gestützte Erkennung von Waldbränden. Juan Lavista Ferres, CVP und Chief Data Scientist, erörtert Strategien zur Eindämmung von Umweltschäden.Laut der NASA betrifft der K

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai

Die besten KI-Beat-Generatoren 2026 für TikTok-Hintergrundtracks, Reels-Audio und Promo-Musik für Creator! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechende Funktionen bieten und in der Praxis getestet wurden, um makellose Musik für jeden Content-Bedarf zu liefern. Hier findest du detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten, wöchentlich aktualisierte Rankings sowie Optionen, die du unbedingt ausprobieren solltest, um deine Kreativität und Produktivität zu steigern. Entdecke jetzt das perfekte Tool für dich!
11 Tools
xix.ai

Die Vorstellung, dass KI solche Puzzles löst, ist faszinierend. Aber wie weit kann diese 'Argumentationsfähigkeit' wirklich gehen? Ich frage mich, ob das mehr ist als nur komplexe Mustererkennung. Die ethischen Implikationen, wenn diese Systeme 'echtes' Denken simulieren könnten, sind beängstigend. 🤔
NPR's Sunday Puzzle with AI? Sounds like a brain teaser showdown! I wonder if these models can outsmart Will Shortz’s tricky wordplay. 🤔
¡Esta herramienta de IA que resuelve los rompecabezas de los domingos de NPR es genial! Es como tener un amigo listo que ama los rompecabezas tanto como yo. A veces se equivoca, pero ¿quién no? ¡Sigue así, IA! 😄
This AI tool tackling NPR's Sunday Puzzles is super cool! It's like having a brainy friend who loves puzzles as much as I do. Sometimes it gets the answers wrong, but hey, who doesn't? Keep up the good work, AI! 🤓
NPRのサンデーパズルに挑戦するこのAIツール、めっちゃ面白い!パズル好きの友達がいるみたいで嬉しい。たまに答えを間違えるけど、誰でもそうなるよね。頑張ってね、AI!😊
NPRのサンデーパズルをAIで解くのは驚きです!これらのトリッキーな質問をモデルがどれだけうまく処理するかを見るのはクールです。時々間違えることもありますが、それでも印象的です。アルゴリズムを調整し続けてくださいね!🤓












