


 Heim
Der neue AGI -Test erweist sich als herausfordernd, die Mehrheit der KI -Modelle der Stümpfe
Die Arc Prize Foundation, mitbegründet von dem renommierten KI-Forscher François Chollet, hat kürzlich in einem Blogbeitrag einen neuen Benchmark namens ARC-AGI-2 vorgestellt. Dieser Test zielt darauf ab, die Grenzen der allgemeinen Intelligenz von KI zu erweitern, und bisher erweist er sich für die meisten KI-Modelle als schwer zu knacken.
Laut der Rangliste des Arc Prize erreichen selbst fortschrittliche „denkende“ KI-Modelle wie OpenAI's o1-pro und DeepSeek's R1 nur Werte zwischen 1 % und 1,3 %. Währenddessen liegen leistungsstarke nicht-denkende Modelle wie GPT-4.5, Claude 3.7 Sonnet und Gemini 2.0 Flash bei etwa 1 %.
ARC-AGI-Tests fordern KI-Systeme mit rätselartigen Problemen heraus, bei denen sie visuelle Muster in Gittern aus verschiedenfarbigen Quadraten erkennen und das richtige „Antwort“-Gitter erstellen müssen. Diese Probleme sind darauf ausgelegt, die Fähigkeit einer KI zu testen, sich an neue, unbekannte Herausforderungen anzupassen.
Um eine menschliche Basislinie zu etablieren, ließ die Arc Prize Foundation über 400 Personen den ARC-AGI-2-Test durchführen. Im Durchschnitt erzielten diese „Gremien“ von Menschen eine Erfolgsquote von 60 %, womit sie die KI-Modelle deutlich übertrafen.
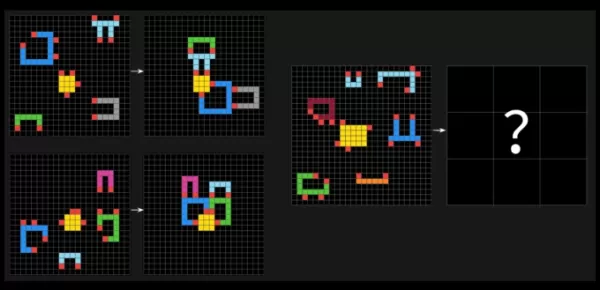
Eine Beispielaufgabe aus ARC-AGI-2. Bildnachweis: Arc Prize François Chollet erklärte auf X, dass ARC-AGI-2 im Vergleich zu seinem Vorgänger, ARC-AGI-1, ein genaueres Maß für die wahre Intelligenz eines KI-Modells ist. Die Tests der Arc Prize Foundation sind darauf ausgelegt, zu prüfen, ob eine KI effizient neue Fähigkeiten jenseits ihrer Trainingsdaten erlernen kann.Chollet betonte, dass ARC-AGI-2 verhindert, dass KI-Modelle Probleme durch „brute force“-Rechenleistung lösen, ein Mangel, den er beim ersten Test eingestand. Um dies zu beheben, führt ARC-AGI-2 eine Effizienzmetrik ein und verlangt, dass Modelle Muster spontan interpretieren, anstatt sich auf Auswendiglernen zu stützen.
In einem Blogbeitrag betonte Greg Kamradt, Mitbegründer der Arc Prize Foundation, dass Intelligenz nicht nur darin besteht, Probleme zu lösen oder hohe Punktzahlen zu erzielen. „Die Effizienz, mit der diese Fähigkeiten erworben und eingesetzt werden, ist eine entscheidende, definierende Komponente“, schrieb er. „Die zentrale Frage ist nicht nur: ‚Kann KI die Fähigkeit erwerben, eine Aufgabe zu lösen?‘, sondern auch: ‚Mit welcher Effizienz oder zu welchen Kosten?‘“
ARC-AGI-1 blieb etwa fünf Jahre lang ungeschlagen, bis im Dezember 2024 OpenAI's fortschrittliches Denkmodell o3 alle anderen KI-Modelle übertraf und die menschliche Leistung erreichte. Allerdings war der Erfolg von o3 bei ARC-AGI-1 mit erheblichen Kosten verbunden. Die Version von OpenAI's o3-Modell, o3 (low), die bei ARC-AGI-1 beeindruckende 75,7 % erzielte, erreichte bei ARC-AGI-2 nur magere 4 %, bei einem Einsatz von 200 US-Dollar Rechenleistung pro Aufgabe.

Vergleich der Leistung von Frontier-KI-Modellen bei ARC-AGI-1 und ARC-AGI-2. Bildnachweis: Arc Prize Die Einführung von ARC-AGI-2 kommt zu einer Zeit, in der viele in der Technologiebranche nach neuen, ungesättigten Benchmarks verlangen, um den Fortschritt von KI zu messen. Thomas Wolf, Mitbegründer von Hugging Face, erklärte kürzlich gegenüber TechCrunch, dass der KI-Branche ausreichende Tests fehlen, um Schlüsselfähigkeiten der künstlichen allgemeinen Intelligenz, wie Kreativität, zu messen.Neben dem neuen Benchmark kündigte die Arc Prize Foundation den Arc Prize 2025-Wettbewerb an, der Entwickler herausfordert, eine Genauigkeit von 85 % beim ARC-AGI-2-Test zu erreichen, während sie nur 0,42 US-Dollar pro Aufgabe ausgeben.
Verwandter Artikel
 RSI wird zum neuen AGI – ebenso schwer zu definieren
Der Begriff „Rekursion“ ist zum neuesten Schlagwort in der künstlichen Intelligenz geworden. Zwei unterschiedliche Start-ups haben ihn als Namen gewählt, und viele andere beziehen sich mittlerweile in
OpenAI skizziert eine KI-Wirtschaft mit öffentlichen Vermögensfonds, Robotersteuern und einer Vier-Tage-Woche
Während Regierungen darum ringen, die wirtschaftlichen Auswirkungen superintelligenter Maschinen zu bewältigen, hat OpenAI eine Reihe von politischen Vorschlägen veröffentlicht, in denen dargelegt wir
Mitbegründer von Databricks kündigt nach dem Gewinn des ACM-Preises das Erscheinen der AGI an
Matei Zaharia, Mitbegründer und CTO von Databricks, hätte die E-Mail, in der ihm die Verleihung des ACM-Preises für Informatik 2026 mitgeteilt wurde, beinahe übersehen. „Das war wirklich eine Überrasc
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (40)
![KeithLopez]()
Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
![DonaldSanchez]()
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
![MarkRoberts]()
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
![RonaldRoberts]()
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
![WillieRoberts]()
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
![GeorgeMiller]()
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!
Die Arc Prize Foundation, mitbegründet von dem renommierten KI-Forscher François Chollet, hat kürzlich in einem Blogbeitrag einen neuen Benchmark namens ARC-AGI-2 vorgestellt. Dieser Test zielt darauf ab, die Grenzen der allgemeinen Intelligenz von KI zu erweitern, und bisher erweist er sich für die meisten KI-Modelle als schwer zu knacken.
Laut der Rangliste des Arc Prize erreichen selbst fortschrittliche „denkende“ KI-Modelle wie OpenAI's o1-pro und DeepSeek's R1 nur Werte zwischen 1 % und 1,3 %. Währenddessen liegen leistungsstarke nicht-denkende Modelle wie GPT-4.5, Claude 3.7 Sonnet und Gemini 2.0 Flash bei etwa 1 %.
ARC-AGI-Tests fordern KI-Systeme mit rätselartigen Problemen heraus, bei denen sie visuelle Muster in Gittern aus verschiedenfarbigen Quadraten erkennen und das richtige „Antwort“-Gitter erstellen müssen. Diese Probleme sind darauf ausgelegt, die Fähigkeit einer KI zu testen, sich an neue, unbekannte Herausforderungen anzupassen.
Um eine menschliche Basislinie zu etablieren, ließ die Arc Prize Foundation über 400 Personen den ARC-AGI-2-Test durchführen. Im Durchschnitt erzielten diese „Gremien“ von Menschen eine Erfolgsquote von 60 %, womit sie die KI-Modelle deutlich übertrafen.
Chollet betonte, dass ARC-AGI-2 verhindert, dass KI-Modelle Probleme durch „brute force“-Rechenleistung lösen, ein Mangel, den er beim ersten Test eingestand. Um dies zu beheben, führt ARC-AGI-2 eine Effizienzmetrik ein und verlangt, dass Modelle Muster spontan interpretieren, anstatt sich auf Auswendiglernen zu stützen.
In einem Blogbeitrag betonte Greg Kamradt, Mitbegründer der Arc Prize Foundation, dass Intelligenz nicht nur darin besteht, Probleme zu lösen oder hohe Punktzahlen zu erzielen. „Die Effizienz, mit der diese Fähigkeiten erworben und eingesetzt werden, ist eine entscheidende, definierende Komponente“, schrieb er. „Die zentrale Frage ist nicht nur: ‚Kann KI die Fähigkeit erwerben, eine Aufgabe zu lösen?‘, sondern auch: ‚Mit welcher Effizienz oder zu welchen Kosten?‘“
ARC-AGI-1 blieb etwa fünf Jahre lang ungeschlagen, bis im Dezember 2024 OpenAI's fortschrittliches Denkmodell o3 alle anderen KI-Modelle übertraf und die menschliche Leistung erreichte. Allerdings war der Erfolg von o3 bei ARC-AGI-1 mit erheblichen Kosten verbunden. Die Version von OpenAI's o3-Modell, o3 (low), die bei ARC-AGI-1 beeindruckende 75,7 % erzielte, erreichte bei ARC-AGI-2 nur magere 4 %, bei einem Einsatz von 200 US-Dollar Rechenleistung pro Aufgabe.
Neben dem neuen Benchmark kündigte die Arc Prize Foundation den Arc Prize 2025-Wettbewerb an, der Entwickler herausfordert, eine Genauigkeit von 85 % beim ARC-AGI-2-Test zu erreichen, während sie nur 0,42 US-Dollar pro Aufgabe ausgeben.








 RSI wird zum neuen AGI – ebenso schwer zu definieren
Der Begriff „Rekursion“ ist zum neuesten Schlagwort in der künstlichen Intelligenz geworden. Zwei unterschiedliche Start-ups haben ihn als Namen gewählt, und viele andere beziehen sich mittlerweile in
 OpenAI skizziert eine KI-Wirtschaft mit öffentlichen Vermögensfonds, Robotersteuern und einer Vier-Tage-Woche
Während Regierungen darum ringen, die wirtschaftlichen Auswirkungen superintelligenter Maschinen zu bewältigen, hat OpenAI eine Reihe von politischen Vorschlägen veröffentlicht, in denen dargelegt wir
 Mitbegründer von Databricks kündigt nach dem Gewinn des ACM-Preises das Erscheinen der AGI an
Matei Zaharia, Mitbegründer und CTO von Databricks, hätte die E-Mail, in der ihm die Verleihung des ACM-Preises für Informatik 2026 mitgeteilt wurde, beinahe übersehen. „Das war wirklich eine Überrasc

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!












