


 집
새로운 AGI 테스트는 도전적인 것으로 판명되고 대다수의 AI 모델
Arc Prize 재단은 유명한 AI 연구자 프랑수아 숄레(François Chollet)가 공동 설립한 기관으로, 최근 블로그 포스트에서 ARC-AGI-2라는 새로운 벤치마크를 공개했습니다. 이 테스트는 AI의 일반 지능의 한계를 확장하는 것을 목표로 하며, 현재까지 대부분의 AI 모델들에게는 풀기 어려운 과제로 입증되고 있습니다.
Arc Prize 리더보드에 따르면, OpenAI의 o1-pro와 DeepSeek의 R1과 같은 고급 "추론" AI 모델들조차 1%에서 1.3% 사이의 점수만을 기록하고 있습니다. 한편, GPT-4.5, Claude 3.7 Sonnet, Gemini 2.0 Flash와 같은 강력한 비추론 모델들은 약 1% 정도의 점수를 유지하고 있습니다.
ARC-AGI 테스트는 AI 시스템이 다양한 색상의 사각형 격자에서 시각적 패턴을 식별하고 올바른 "답변" 격자를 생성하도록 요구하는 퍼즐과 같은 문제를 통해 도전합니다. 이러한 문제들은 AI가 새로운, 이전에 보지 못한 도전에 적응하는 능력을 테스트하도록 설계되었습니다.
인간의 기준선을 설정하기 위해 Arc Prize 재단은 400명 이상의 사람들에게 ARC-AGI-2 테스트를 치르게 했습니다. 평균적으로 이 "패널"들은 60%의 성공률을 달성하여 AI 모델들을 크게 앞질렀습니다.
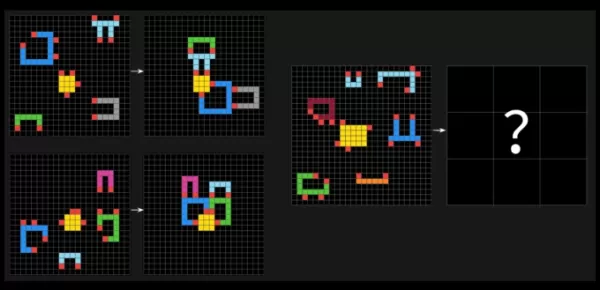
ARC-AGI-2의 샘플 질문. 이미지 출처: Arc Prize 프랑수아 숄레(François Chollet)는 X에서 ARC-AGI-2가 이전 버전인 ARC-AGI-1에 비해 AI 모델의 진정한 지능을 더 정확히 측정한다고 주장했습니다. Arc Prize 재단의 테스트는 AI가 훈련 데이터 너머의 새로운 기술을 효율적으로 학습할 수 있는지를 평가하도록 설계되었습니다.숄레는 ARC-AGI-2가 AI 모델이 "무차별 대입" 컴퓨팅 파워에 의존하여 문제를 해결하는 것을 방지한다고 강조했으며, 이는 첫 번째 테스트에서 인정한 결함이었습니다. 이를 해결하기 위해 ARC-AGI-2는 효율성 지표를 도입하고 모델이 기억에 의존하기보다는 즉석에서 패턴을 해석하도록 요구합니다.
블로그 포스트에서 Arc Prize 재단의 공동 설립자 그렉 캠라트(Greg Kamradt)는 지능이 단순히 문제를 해결하거나 높은 점수를 얻는 것만이 아니라고 강조했습니다. 그는 "그 능력이 획득되고 배포되는 효율성이 중요한 정의적 구성 요소"라고 썼습니다. "핵심 질문은 단순히 'AI가 작업을 해결하기 위한 기술을 획득할 수 있는가?'가 아니라, '어떤 효율성이나 비용으로?'입니다."
ARC-AGI-1은 약 5년 동안 무패로 남아 있었으나, 2024년 12월 OpenAI의 고급 추론 모델인 o3가 다른 모든 AI 모델을 능가하고 인간의 성능을 따라잡았습니다. 그러나 o3의 ARC-AGI-1에서의 성공은 상당한 비용을 초래했습니다. ARC-AGI-1에서 75.7%라는 인상적인 점수를 기록한 OpenAI의 o3 모델, o3 (low)는 ARC-AGI-2에서는 태스크당 200달러의 컴퓨팅 파워를 사용하며 겨우 4%를 기록했습니다.

ARC-AGI-1과 ARC-AGI-2에서 프론티어 AI 모델 성능 비교. 이미지 출처: Arc Prize ARC-AGI-2의 도입은 기술 산업에서 많은 이들이 AI 발전을 측정하기 위해 새로운, 포화되지 않은 벤치마크를 요구하는 시점에 이루어졌습니다. Hugging Face의 공동 설립자 토마스 울프(Thomas Wolf)는 최근 TechCrunch에 AI 산업이 인공지능 일반의 핵심 특성, 예를 들어 창의성을 측정할 충분한 테스트가 부족하다고 말했습니다.새로운 벤치마크와 함께 Arc Prize 재단은 Arc Prize 2025 대회를 발표했으며, 개발자들에게 ARC-AGI-2 테스트에서 85% 정확도를 달성하면서 태스크당 0.42달러만을 사용하도록 도전했습니다.
관련 기사
 RSI는 새로운 AGI가 되었으며, 정의하기 마찬가지로 애매모호하다
“재귀(recursion)”라는 용어는 인공지능 분야에서 최신 유행어로 자리 잡았다. 두 개의 서로 다른 스타트업이 이를 회사명으로 채택했으며, 수많은 다른 기업들도 이제 개발 계획에서 ‘재귀적 자기 개선(Recursive Self-Improvement, RSI)’을 언급하고 있다. 이전의 AGI와 마찬가지로, RSI는 정확한 정의에 대해 여전히 논란이 있
오픈AI, 공공 부유 기금, 로봇세, 주 4일 근무제를 통해 AI 경제 구상 제시
각국 정부가 초지능 기계가 초래할 경제적 영향을 관리하기 위해 고심하는 가운데, 오픈AI는 ‘지능 시대’에 부와 일자리가 어떻게 재편될 수 있을지 제시하는 일련의 정책 제안을 발표했다. 이 제안들은 공공 부유 기금이나 사회 안전망 확충과 같은 전통적인 진보적 방안들을 근본적으로 자본주의적이고 시장 주도적인 경제 체계와 결합하고 있다.오픈AI의 제안은 본질적
데이터브릭스 공동 창업자, ACM 상 수상 후 AGI 도래 주장
Databricks의 공동 창립자이자 CTO인 마테이 자하리아는 자신이 2026년 ACM 컴퓨팅 상을 수상했다는 소식을 알리는 이메일을 거의 놓칠 뻔했다. 그는 테크크런치와의 인터뷰에서 “정말 뜻밖이었다”고 말했다.2009년, 자하리아가 UC 버클리에서 저명한 이온 스토이카(Ion Stoica) 교수의 지도 아래 박사 과정 중 개발한 기술이 데이터브릭스에
관련 특별 주제 추천
데이터 분석
 수익 대시보드, 퍼널 분석, 그리고 제품 지표를 위한 AI SQL 코파일럿
2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
 9 도구
 xix.ai
음악 작곡
노래 초안을 위한 최고의 AI 멜로디 작곡 도구
2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai
챗봇
면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai
만화 창작
시각적 스토리텔링을 위한 최고의 AI 대화 풍선 도구
2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai
회의 도우미
최고의 AI 회의 요약 도구: 의사 결정 사항과 후속 조치를 명확하게 추적하세요
2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai

 의견 (40)
0/500
![KeithLopez]()
Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
![DonaldSanchez]()
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
![MarkRoberts]()
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
![RonaldRoberts]()
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
![WillieRoberts]()
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
![GeorgeMiller]()
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!
Arc Prize 재단은 유명한 AI 연구자 프랑수아 숄레(François Chollet)가 공동 설립한 기관으로, 최근 블로그 포스트에서 ARC-AGI-2라는 새로운 벤치마크를 공개했습니다. 이 테스트는 AI의 일반 지능의 한계를 확장하는 것을 목표로 하며, 현재까지 대부분의 AI 모델들에게는 풀기 어려운 과제로 입증되고 있습니다.
Arc Prize 리더보드에 따르면, OpenAI의 o1-pro와 DeepSeek의 R1과 같은 고급 "추론" AI 모델들조차 1%에서 1.3% 사이의 점수만을 기록하고 있습니다. 한편, GPT-4.5, Claude 3.7 Sonnet, Gemini 2.0 Flash와 같은 강력한 비추론 모델들은 약 1% 정도의 점수를 유지하고 있습니다.
ARC-AGI 테스트는 AI 시스템이 다양한 색상의 사각형 격자에서 시각적 패턴을 식별하고 올바른 "답변" 격자를 생성하도록 요구하는 퍼즐과 같은 문제를 통해 도전합니다. 이러한 문제들은 AI가 새로운, 이전에 보지 못한 도전에 적응하는 능력을 테스트하도록 설계되었습니다.
인간의 기준선을 설정하기 위해 Arc Prize 재단은 400명 이상의 사람들에게 ARC-AGI-2 테스트를 치르게 했습니다. 평균적으로 이 "패널"들은 60%의 성공률을 달성하여 AI 모델들을 크게 앞질렀습니다.
숄레는 ARC-AGI-2가 AI 모델이 "무차별 대입" 컴퓨팅 파워에 의존하여 문제를 해결하는 것을 방지한다고 강조했으며, 이는 첫 번째 테스트에서 인정한 결함이었습니다. 이를 해결하기 위해 ARC-AGI-2는 효율성 지표를 도입하고 모델이 기억에 의존하기보다는 즉석에서 패턴을 해석하도록 요구합니다.
블로그 포스트에서 Arc Prize 재단의 공동 설립자 그렉 캠라트(Greg Kamradt)는 지능이 단순히 문제를 해결하거나 높은 점수를 얻는 것만이 아니라고 강조했습니다. 그는 "그 능력이 획득되고 배포되는 효율성이 중요한 정의적 구성 요소"라고 썼습니다. "핵심 질문은 단순히 'AI가 작업을 해결하기 위한 기술을 획득할 수 있는가?'가 아니라, '어떤 효율성이나 비용으로?'입니다."
ARC-AGI-1은 약 5년 동안 무패로 남아 있었으나, 2024년 12월 OpenAI의 고급 추론 모델인 o3가 다른 모든 AI 모델을 능가하고 인간의 성능을 따라잡았습니다. 그러나 o3의 ARC-AGI-1에서의 성공은 상당한 비용을 초래했습니다. ARC-AGI-1에서 75.7%라는 인상적인 점수를 기록한 OpenAI의 o3 모델, o3 (low)는 ARC-AGI-2에서는 태스크당 200달러의 컴퓨팅 파워를 사용하며 겨우 4%를 기록했습니다.
새로운 벤치마크와 함께 Arc Prize 재단은 Arc Prize 2025 대회를 발표했으며, 개발자들에게 ARC-AGI-2 테스트에서 85% 정확도를 달성하면서 태스크당 0.42달러만을 사용하도록 도전했습니다.








 RSI는 새로운 AGI가 되었으며, 정의하기 마찬가지로 애매모호하다
“재귀(recursion)”라는 용어는 인공지능 분야에서 최신 유행어로 자리 잡았다. 두 개의 서로 다른 스타트업이 이를 회사명으로 채택했으며, 수많은 다른 기업들도 이제 개발 계획에서 ‘재귀적 자기 개선(Recursive Self-Improvement, RSI)’을 언급하고 있다. 이전의 AGI와 마찬가지로, RSI는 정확한 정의에 대해 여전히 논란이 있
 오픈AI, 공공 부유 기금, 로봇세, 주 4일 근무제를 통해 AI 경제 구상 제시
각국 정부가 초지능 기계가 초래할 경제적 영향을 관리하기 위해 고심하는 가운데, 오픈AI는 ‘지능 시대’에 부와 일자리가 어떻게 재편될 수 있을지 제시하는 일련의 정책 제안을 발표했다. 이 제안들은 공공 부유 기금이나 사회 안전망 확충과 같은 전통적인 진보적 방안들을 근본적으로 자본주의적이고 시장 주도적인 경제 체계와 결합하고 있다.오픈AI의 제안은 본질적
 데이터브릭스 공동 창업자, ACM 상 수상 후 AGI 도래 주장
Databricks의 공동 창립자이자 CTO인 마테이 자하리아는 자신이 2026년 ACM 컴퓨팅 상을 수상했다는 소식을 알리는 이메일을 거의 놓칠 뻔했다. 그는 테크크런치와의 인터뷰에서 “정말 뜻밖이었다”고 말했다.2009년, 자하리아가 UC 버클리에서 저명한 이온 스토이카(Ion Stoica) 교수의 지도 아래 박사 과정 중 개발한 기술이 데이터브릭스에

2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai

2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai

Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!












