


 家
新しいAGIテストは挑戦的であり、AIモデルの大部分を切り株します
アーク賞財団は、著名なAI研究者フランソワ・ショレが共同設立者として参加し、最近のブログ投稿でARC-AGI-2という新たなベンチマークを発表しました。このテストはAIの一般知能の限界を押し広げることを目指しており、これまでのところ、ほとんどのAIモデルにとって難題であることが証明されています。
アーク賞のリーダーボードによると、OpenAIのo1-proやDeepSeekのR1のような高度な「推論」AIモデルでさえ、スコアは1%から1.3%の間に留まっています。一方、GPT-4.5、Claude 3.7 Sonnet、Gemini 2.0 Flashといった強力な非推論モデルは、1%前後のスコアにとどまっています。
ARC-AGIテストは、AIシステムに対して異なる色の四角形のグリッドで視覚的パターンを識別し、正しい「答え」のグリッドを生成することを求めるパズルのような問題で挑戦します。これらの問題は、AIが新しい、未見の課題に適応する能力をテストするために設計されています。
人間の基準を確立するため、アーク賞財団は400人以上にARC-AGI-2テストを受けさせました。平均して、これらの「パネル」の人間は60%の成功率を達成し、AIモデルを大きく上回りました。
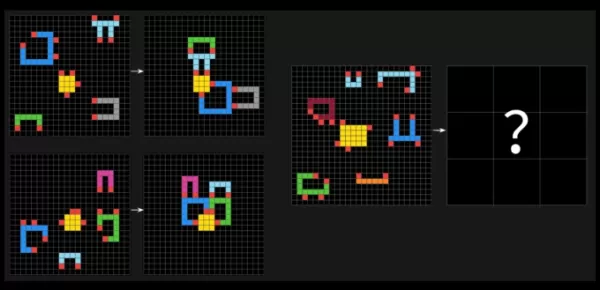
ARC-AGI-2からのサンプル問題。画像提供:Arc Prize フランソワ・ショレはXで、ARC-AGI-2は前身のARC-AGI-1と比較して、AIモデルの真の知能をより正確に測定すると主張しました。アーク賞財団のテストは、AIがトレーニングデータ以外の新しいスキルを効率的に学習できるかどうかを評価するために設計されています。ショレは、ARC-AGI-2がAIモデルが「力ずく」の計算能力に頼って問題を解決することを防ぐと強調し、最初のテストで認められた欠点を修正しました。これに対処するため、ARC-AGI-2は効率メトリックを導入し、モデルが記憶に頼るのではなく、その場でパターンを解釈することを要求します。
ブログ投稿で、アーク賞財団の共同設立者グレッグ・カムラットは、知能は単に問題を解決したり高スコアを達成することだけではないと強調しました。「それらの能力が取得され、展開される効率は、決定的な重要な要素です」と彼は書いています。「問われている核心的な質問は、『AIがタスクを解決するスキルを獲得できるか?』だけでなく、『どの程度の効率またはコストで?』でもあります」
ARC-AGI-1は約5年間無敗でしたが、2024年12月にOpenAIの高度な推論モデルo3が他のすべてのAIモデルを上回り、人間のパフォーマンスに匹敵しました。しかし、ARC-AGI-1でのo3の成功は大きなコストを伴いました。ARC-AGI-1で75.7%の印象的なスコアを達成したOpenAIのo3モデル(o3 (low))は、ARC-AGI-2ではタスクごとに200ドルの計算能力を使用して、わずか4%しか達成できませんでした。

ARC-AGI-1およびARC-AGI-2でのフロンティアAIモデルのパフォーマンス比較。画像提供:Arc Prize ARC-AGI-2の導入は、技術業界の多くの人々がAIの進歩を測定するための新しい、未飽和のベンチマークを求めている時期に起こりました。Hugging Faceの共同設立者トーマス・ウルフは最近、TechCrunchに対し、AI業界には人工知能の重要な特性、例えば創造性を測定する十分なテストが不足していると語りました。新しいベンチマークとともに、アーク賞財団はArc Prize 2025コンテストを発表し、開発者に対してARC-AGI-2テストで85%の精度を達成しながら、タスクごとに0.42ドルしか使わないよう挑戦しました。
関連記事
 RSIは新たなAGIとなり、その定義も同様に捉えどころのないものとなった
「再帰(recursion)」という言葉は、人工知能分野における最新の流行語となっている。 2つの異なるスタートアップ企業が社名にこの言葉を採用しており、他にも多くの企業が開発計画の中で「再帰的自己改善(RSI)」に言及している。かつてのAGIと同様に、RSIはAIにおける劇的なブレークスルーを表す3文字の略語となっている――その正確な定義については依然として議論の余地があるものの。本質的に、RS
OpenAIは、公的基金、ロボット税、週4日勤務制を柱とするAI経済の構想を提示した
各国政府が超知能機械による経済的影響への対応に苦慮する中、OpenAIは「知能の時代」において富と労働がどのように再構築されるべきかを概説した一連の政策提言を発表した。その構想は、公的資産基金や社会安全網の拡充といった伝統的な左派的な仕組みと、根本的に資本主義的で市場主導型の経済枠組みとを融合させたものである。OpenAIの提案は本質的に「要望リスト」に相当し、人工知能が労働と経済を変革する中で、
Databricksの共同創業者、ACM賞受賞後にAGIの実現を主張
Databricksの共同創業者兼CTOであるマテイ・ザハリア氏は、自身が2026年ACMコンピューティング賞を受賞したことを知らせるメールを、見落とすところだった。「本当に驚きでした」と彼はTechCrunchに語った。2009年、ザハリアがカリフォルニア大学バークレー校(UCバークレー)の博士課程在籍中に、著名なイオン・ストイカ教授の指導の下で開発した技術が、Databricksに組み込まれた
関連特集おすすめ
チャットボット
 面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
 12 ツール
 xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
データ分析
最強のAIデータクリーニングツール:欠損値や重複データを迅速に修正
2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai
デザインとアート
アーティストのための最高のAIクリエイティブアイディエーションツール:ビジュアルブロックを打破する
2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

 コメント (40)
0/500
![KeithLopez]()
Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
![DonaldSanchez]()
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
![MarkRoberts]()
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
![RonaldRoberts]()
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
![WillieRoberts]()
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
![GeorgeMiller]()
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!
アーク賞財団は、著名なAI研究者フランソワ・ショレが共同設立者として参加し、最近のブログ投稿でARC-AGI-2という新たなベンチマークを発表しました。このテストはAIの一般知能の限界を押し広げることを目指しており、これまでのところ、ほとんどのAIモデルにとって難題であることが証明されています。
アーク賞のリーダーボードによると、OpenAIのo1-proやDeepSeekのR1のような高度な「推論」AIモデルでさえ、スコアは1%から1.3%の間に留まっています。一方、GPT-4.5、Claude 3.7 Sonnet、Gemini 2.0 Flashといった強力な非推論モデルは、1%前後のスコアにとどまっています。
ARC-AGIテストは、AIシステムに対して異なる色の四角形のグリッドで視覚的パターンを識別し、正しい「答え」のグリッドを生成することを求めるパズルのような問題で挑戦します。これらの問題は、AIが新しい、未見の課題に適応する能力をテストするために設計されています。
人間の基準を確立するため、アーク賞財団は400人以上にARC-AGI-2テストを受けさせました。平均して、これらの「パネル」の人間は60%の成功率を達成し、AIモデルを大きく上回りました。
ショレは、ARC-AGI-2がAIモデルが「力ずく」の計算能力に頼って問題を解決することを防ぐと強調し、最初のテストで認められた欠点を修正しました。これに対処するため、ARC-AGI-2は効率メトリックを導入し、モデルが記憶に頼るのではなく、その場でパターンを解釈することを要求します。
ブログ投稿で、アーク賞財団の共同設立者グレッグ・カムラットは、知能は単に問題を解決したり高スコアを達成することだけではないと強調しました。「それらの能力が取得され、展開される効率は、決定的な重要な要素です」と彼は書いています。「問われている核心的な質問は、『AIがタスクを解決するスキルを獲得できるか?』だけでなく、『どの程度の効率またはコストで?』でもあります」
ARC-AGI-1は約5年間無敗でしたが、2024年12月にOpenAIの高度な推論モデルo3が他のすべてのAIモデルを上回り、人間のパフォーマンスに匹敵しました。しかし、ARC-AGI-1でのo3の成功は大きなコストを伴いました。ARC-AGI-1で75.7%の印象的なスコアを達成したOpenAIのo3モデル(o3 (low))は、ARC-AGI-2ではタスクごとに200ドルの計算能力を使用して、わずか4%しか達成できませんでした。
新しいベンチマークとともに、アーク賞財団はArc Prize 2025コンテストを発表し、開発者に対してARC-AGI-2テストで85%の精度を達成しながら、タスクごとに0.42ドルしか使わないよう挑戦しました。








 RSIは新たなAGIとなり、その定義も同様に捉えどころのないものとなった
「再帰(recursion)」という言葉は、人工知能分野における最新の流行語となっている。 2つの異なるスタートアップ企業が社名にこの言葉を採用しており、他にも多くの企業が開発計画の中で「再帰的自己改善(RSI)」に言及している。かつてのAGIと同様に、RSIはAIにおける劇的なブレークスルーを表す3文字の略語となっている――その正確な定義については依然として議論の余地があるものの。本質的に、RS
 OpenAIは、公的基金、ロボット税、週4日勤務制を柱とするAI経済の構想を提示した
各国政府が超知能機械による経済的影響への対応に苦慮する中、OpenAIは「知能の時代」において富と労働がどのように再構築されるべきかを概説した一連の政策提言を発表した。その構想は、公的資産基金や社会安全網の拡充といった伝統的な左派的な仕組みと、根本的に資本主義的で市場主導型の経済枠組みとを融合させたものである。OpenAIの提案は本質的に「要望リスト」に相当し、人工知能が労働と経済を変革する中で、
 Databricksの共同創業者、ACM賞受賞後にAGIの実現を主張
Databricksの共同創業者兼CTOであるマテイ・ザハリア氏は、自身が2026年ACMコンピューティング賞を受賞したことを知らせるメールを、見落とすところだった。「本当に驚きでした」と彼はTechCrunchに語った。2009年、ザハリアがカリフォルニア大学バークレー校(UCバークレー)の博士課程在籍中に、著名なイオン・ストイカ教授の指導の下で開発した技術が、Databricksに組み込まれた

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!












