


 Дом
Новый тест AGI оказывается сложным, пензирует большинство моделей искусственного интеллекта
Фонд Arc Prize, соучредителем которого является известный исследователь ИИ Франсуа Шолле, недавно представил новый тест под названием ARC-AGI-2 в публикации в блоге. Этот тест направлен на расширение границ общего интеллекта ИИ, и пока он оказывается сложной задачей для большинства моделей ИИ.
Согласно таблице лидеров Arc Prize, даже продвинутые модели ИИ с функцией "рассуждения", такие как o1-pro от OpenAI и R1 от DeepSeek, достигают результатов лишь в диапазоне от 1% до 1.3%. В то же время мощные модели без функции рассуждений, такие как GPT-4.5, Claude 3.7 Sonnet и Gemini 2.0 Flash, показывают результаты около 1%.
Тесты ARC-AGI бросают вызов системам ИИ с задачами-головоломками, требующими определения визуальных узоров в сетках из разноцветных квадратов и создания правильной "ответной" сетки. Эти задачи разработаны для проверки способности ИИ адаптироваться к новым, ранее не виданным вызовам.
Для установления человеческого базового уровня Фонд Arc Prize привлек более 400 человек к прохождению теста ARC-AGI-2. В среднем эти "панели" людей достигли 60% успеха, значительно опережая модели ИИ.
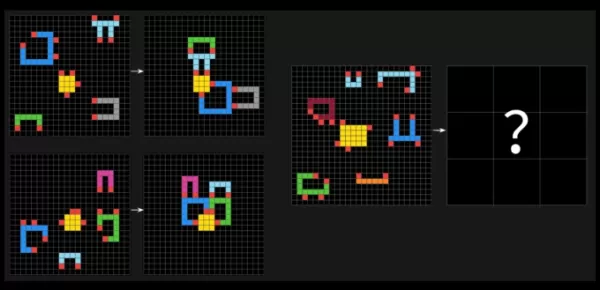
Пример вопроса из ARC-AGI-2. Источник изображения: Arc Prize Франсуа Шолле заявил на X, что ARC-AGI-2 является более точной мерой истинного интеллекта модели ИИ по сравнению с его предшественником, ARC-AGI-1. Тесты Фонда Arc Prize разработаны для оценки способности ИИ эффективно обучаться новым навыкам за пределами обучающих данных.Шолле подчеркнул, что ARC-AGI-2 предотвращает использование моделями ИИ "грубой силы" вычислительной мощности для решения задач, что было недостатком первого теста. Для этого ARC-AGI-2 вводит метрику эффективности и требует от моделей интерпретации узоров на лету, а не полагаться на запоминание.
В публикации в блоге соучредитель Фонда Arc Prize Грег Камрадт подчеркнул, что интеллект — это не только решение задач или достижение высоких результатов. "Эффективность, с которой эти способности приобретаются и применяются, является решающим, определяющим компонентом," — написал он. "Основной вопрос заключается не только в том, 'Может ли ИИ приобрести навык для решения задачи?', но и 'С какой эффективностью или стоимостью?'"
ARC-AGI-1 оставался непревзойденным около пяти лет до декабря 2024 года, когда продвинутая модель рассуждений OpenAI, o3, превзошла все другие модели ИИ и сравнялась с человеческими результатами. Однако успех o3 на ARC-AGI-1 обошелся дорого. Версия модели OpenAI o3 (low), которая набрала впечатляющие 75.7% на ARC-AGI-1, показала лишь 4% на ARC-AGI-2, используя вычислительную мощность стоимостью 200 долларов на задачу.

Сравнение производительности передовых моделей ИИ на ARC-AGI-1 и ARC-AGI-2. Источник изображения: Arc Prize Введение ARC-AGI-2 происходит в момент, когда многие в технологической индустрии призывают к новым, ненасыщенным тестам для измерения прогресса ИИ. Томас Вольф, соучредитель Hugging Face, недавно сообщил TechCrunch, что индустрии ИИ не хватает достаточных тестов для измерения ключевых черт искусственного общего интеллекта, таких как креативность.Наряду с новым тестом Фонд Arc Prize объявил о конкурсе Arc Prize 2025, побуждая разработчиков достичь 85% точности на тесте ARC-AGI-2, тратя при этом всего 0.42 доллара на задачу.
Связанная статья
 RSI становится новым AGI, который так же трудно определить
Термин «рекурсия» стал новым модным словом в сфере искусственного интеллекта. Два разных стартапа взяли его в качестве названия, а многие другие теперь упоминают «рекурсивное самосовершенствование» (R
OpenAI описывает экономику искусственного интеллекта с участием государственных инвестиционных фондов, налогами на роботов и четырехдневной рабочей неделей
В то время как правительства пытаются справиться с экономическими последствиями появления сверхинтеллектуальных машин, компания OpenAI опубликовала ряд предложений по формированию политики, в которых
Соучредитель Databricks заявил о появлении AGI после получения премии ACM
Соучредитель и технический директор Databricks Матей Захария едва не пропустил письмо, в котором ему сообщалось о присуждении премии ACM в области вычислительной техники за 2026 год. «Это было, безусл
Рекомендации по связанным специальным темам
чат-бот
 Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
 12 инструментов
 xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai
Помощник по встречам
Лучшие инструменты для составления отчетов о встречах с использованием ИИ: четкое отслеживание решений и последующих действий
2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai
Анализ данных
Лучшие инструменты для очистки данных с использованием ИИ: быстрое устранение пропущенных значений и дубликатов
2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для творческого мышления на основе ИИ для художников: преодоление визуальных блоков
В 2026 году лучшие и наиболее популярные инструменты для творческого мышления с использованием ИИ для художников были отобраны XIX.AI, чтобы помочь создателям преодолеть визуальные блоки и мгновенно повысить креативность. Эти мощные инструменты, меняющие правила игры, предлагают реальные тесты, подробное сравнение бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите идеальный инструмент для ускорения создания контента и откройте свой ИИ-преимущество уже сегодня. Исследуйте сейчас!
14 инструментов
xix.ai

 Комментарии (40)
![KeithLopez]()
Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
![DonaldSanchez]()
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
![MarkRoberts]()
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
![RonaldRoberts]()
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
![WillieRoberts]()
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
![GeorgeMiller]()
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!
Фонд Arc Prize, соучредителем которого является известный исследователь ИИ Франсуа Шолле, недавно представил новый тест под названием ARC-AGI-2 в публикации в блоге. Этот тест направлен на расширение границ общего интеллекта ИИ, и пока он оказывается сложной задачей для большинства моделей ИИ.
Согласно таблице лидеров Arc Prize, даже продвинутые модели ИИ с функцией "рассуждения", такие как o1-pro от OpenAI и R1 от DeepSeek, достигают результатов лишь в диапазоне от 1% до 1.3%. В то же время мощные модели без функции рассуждений, такие как GPT-4.5, Claude 3.7 Sonnet и Gemini 2.0 Flash, показывают результаты около 1%.
Тесты ARC-AGI бросают вызов системам ИИ с задачами-головоломками, требующими определения визуальных узоров в сетках из разноцветных квадратов и создания правильной "ответной" сетки. Эти задачи разработаны для проверки способности ИИ адаптироваться к новым, ранее не виданным вызовам.
Для установления человеческого базового уровня Фонд Arc Prize привлек более 400 человек к прохождению теста ARC-AGI-2. В среднем эти "панели" людей достигли 60% успеха, значительно опережая модели ИИ.
Шолле подчеркнул, что ARC-AGI-2 предотвращает использование моделями ИИ "грубой силы" вычислительной мощности для решения задач, что было недостатком первого теста. Для этого ARC-AGI-2 вводит метрику эффективности и требует от моделей интерпретации узоров на лету, а не полагаться на запоминание.
В публикации в блоге соучредитель Фонда Arc Prize Грег Камрадт подчеркнул, что интеллект — это не только решение задач или достижение высоких результатов. "Эффективность, с которой эти способности приобретаются и применяются, является решающим, определяющим компонентом," — написал он. "Основной вопрос заключается не только в том, 'Может ли ИИ приобрести навык для решения задачи?', но и 'С какой эффективностью или стоимостью?'"
ARC-AGI-1 оставался непревзойденным около пяти лет до декабря 2024 года, когда продвинутая модель рассуждений OpenAI, o3, превзошла все другие модели ИИ и сравнялась с человеческими результатами. Однако успех o3 на ARC-AGI-1 обошелся дорого. Версия модели OpenAI o3 (low), которая набрала впечатляющие 75.7% на ARC-AGI-1, показала лишь 4% на ARC-AGI-2, используя вычислительную мощность стоимостью 200 долларов на задачу.
Наряду с новым тестом Фонд Arc Prize объявил о конкурсе Arc Prize 2025, побуждая разработчиков достичь 85% точности на тесте ARC-AGI-2, тратя при этом всего 0.42 доллара на задачу.








 RSI становится новым AGI, который так же трудно определить
Термин «рекурсия» стал новым модным словом в сфере искусственного интеллекта. Два разных стартапа взяли его в качестве названия, а многие другие теперь упоминают «рекурсивное самосовершенствование» (R
 OpenAI описывает экономику искусственного интеллекта с участием государственных инвестиционных фондов, налогами на роботов и четырехдневной рабочей неделей
В то время как правительства пытаются справиться с экономическими последствиями появления сверхинтеллектуальных машин, компания OpenAI опубликовала ряд предложений по формированию политики, в которых
 Соучредитель Databricks заявил о появлении AGI после получения премии ACM
Соучредитель и технический директор Databricks Матей Захария едва не пропустил письмо, в котором ему сообщалось о присуждении премии ACM в области вычислительной техники за 2026 год. «Это было, безусл

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai

В 2026 году лучшие и наиболее популярные инструменты для творческого мышления с использованием ИИ для художников были отобраны XIX.AI, чтобы помочь создателям преодолеть визуальные блоки и мгновенно повысить креативность. Эти мощные инструменты, меняющие правила игры, предлагают реальные тесты, подробное сравнение бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите идеальный инструмент для ускорения создания контента и откройте свой ИИ-преимущество уже сегодня. Исследуйте сейчас!
14 инструментов
xix.ai

Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!












