


 Lar
Novos testes da AGI prova desafiadores, toca a maioria dos modelos de IA
A Fundação Arc Prize, co-fundada pelo renomado pesquisador de IA François Chollet, revelou recentemente um novo benchmark chamado ARC-AGI-2 em um post de blog. Este teste visa expandir os limites da inteligência geral de IA, e até agora, está se mostrando um desafio difícil para a maioria dos modelos de IA.
De acordo com o ranking da Arc Prize, até mesmo modelos avançados de IA de "raciocínio" como o o1-pro da OpenAI e o R1 da DeepSeek estão obtendo pontuações entre 1% e 1,3%. Enquanto isso, modelos poderosos sem raciocínio, como GPT-4.5, Claude 3.7 Sonnet e Gemini 2.0 Flash, estão na faixa de 1%.
Os testes ARC-AGI desafiam sistemas de IA com problemas semelhantes a quebra-cabeças, exigindo que identifiquem padrões visuais em grades de quadrados coloridos e gerem a grade "resposta" correta. Esses problemas são projetados para testar a capacidade de uma IA de se adaptar a novos desafios nunca vistos.
Para estabelecer uma linha de base humana, a Fundação Arc Prize fez com que mais de 400 pessoas realizassem o teste ARC-AGI-2. Em média, esses "painéis" de humanos alcançaram uma taxa de sucesso de 60%, superando significativamente os modelos de IA.
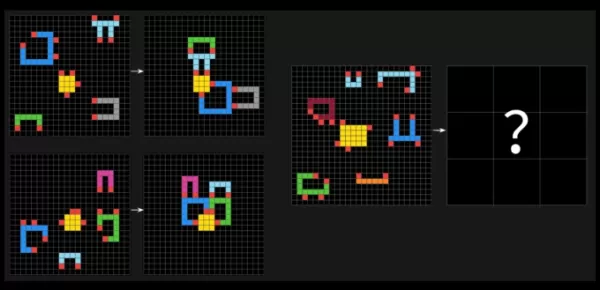
Uma questão de exemplo do ARC-AGI-2. Créditos da imagem: Arc Prize François Chollet foi ao X afirmar que o ARC-AGI-2 é uma medida mais precisa da verdadeira inteligência de um modelo de IA em comparação com seu antecessor, ARC-AGI-1. Os testes da Fundação Arc Prize são projetados para avaliar se uma IA pode aprender novas habilidades de forma eficiente além de seus dados de treinamento.Chollet enfatizou que o ARC-AGI-2 impede que os modelos de IA dependam de poder computacional de "força bruta" para resolver problemas, uma falha que ele reconheceu no primeiro teste. Para abordar isso, o ARC-AGI-2 introduz uma métrica de eficiência e exige que os modelos interpretem padrões no momento, em vez de dependerem de memorização.
Em um post de blog, o co-fundador da Fundação Arc Prize, Greg Kamradt, destacou que a inteligência não se trata apenas de resolver problemas ou alcançar altas pontuações. "A eficiência com que essas capacidades são adquiridas e implementadas é um componente crucial e definidor", ele escreveu. "A questão central não é apenas, 'A IA pode adquirir a habilidade para resolver uma tarefa?', mas também, 'Com que eficiência ou custo?'"
O ARC-AGI-1 permaneceu imbatível por cerca de cinco anos até dezembro de 2024, quando o modelo avançado de raciocínio da OpenAI, o3, superou todos os outros modelos de IA e igualou o desempenho humano. No entanto, o sucesso do o3 no ARC-AGI-1 teve um custo significativo. A versão do modelo o3 da OpenAI, o3 (low), que obteve impressionantes 75,7% no ARC-AGI-1, conseguiu apenas 4% no ARC-AGI-2, usando $200 de poder computacional por tarefa.

Comparação do desempenho de modelos de IA de ponta no ARC-AGI-1 e ARC-AGI-2. Créditos da imagem: Arc Prize A introdução do ARC-AGI-2 ocorre em um momento em que muitos na indústria de tecnologia estão pedindo novos benchmarks não saturados para medir o progresso da IA. Thomas Wolf, co-fundador da Hugging Face, disse recentemente à TechCrunch que a indústria de IA carece de testes suficientes para medir características-chave da inteligência geral artificial, como a criatividade.Junto com o novo benchmark, a Fundação Arc Prize anunciou o concurso Arc Prize 2025, desafiando desenvolvedores a alcançar 85% de precisão no teste ARC-AGI-2 gastando apenas $0,42 por tarefa.
Artigo relacionado
 O RSI passa a ser o novo AGI, igualmente difícil de definir
O termo “recursão” tornou-se a palavra da moda no campo da inteligência artificial. Duas startups distintas adotaram esse termo como nome, e muitas outras agora fazem referência ao Autoaperfeiçoamento
A OpenAI traça os contornos da economia da IA com fundos de riqueza pública, impostos sobre robôs e a semana de quatro dias
Enquanto os governos lutam para lidar com o impacto econômico das máquinas superinteligentes, a OpenAI divulgou um conjunto de propostas de políticas que delineiam como a riqueza e o trabalho poderiam
Co-fundador da Databricks afirma que a IA geral está chegando após receber o prêmio da ACM
Matei Zaharia, cofundador e diretor de tecnologia (CTO) da Databricks, quase deixou passar despercebido o e-mail que o informava de que havia sido agraciado com o Prêmio ACM de Computação de 2026. “Fo
Recomendações de tópicos especiais relacionados
Composição musical
 Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
 8 ferramentas
 xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de limpeza de dados com IA: corrija valores faltantes e duplicatas rapidamente
2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

 Comentários (40)
![KeithLopez]()
Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
![DonaldSanchez]()
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
![MarkRoberts]()
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
![RonaldRoberts]()
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
![WillieRoberts]()
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
![GeorgeMiller]()
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!
A Fundação Arc Prize, co-fundada pelo renomado pesquisador de IA François Chollet, revelou recentemente um novo benchmark chamado ARC-AGI-2 em um post de blog. Este teste visa expandir os limites da inteligência geral de IA, e até agora, está se mostrando um desafio difícil para a maioria dos modelos de IA.
De acordo com o ranking da Arc Prize, até mesmo modelos avançados de IA de "raciocínio" como o o1-pro da OpenAI e o R1 da DeepSeek estão obtendo pontuações entre 1% e 1,3%. Enquanto isso, modelos poderosos sem raciocínio, como GPT-4.5, Claude 3.7 Sonnet e Gemini 2.0 Flash, estão na faixa de 1%.
Os testes ARC-AGI desafiam sistemas de IA com problemas semelhantes a quebra-cabeças, exigindo que identifiquem padrões visuais em grades de quadrados coloridos e gerem a grade "resposta" correta. Esses problemas são projetados para testar a capacidade de uma IA de se adaptar a novos desafios nunca vistos.
Para estabelecer uma linha de base humana, a Fundação Arc Prize fez com que mais de 400 pessoas realizassem o teste ARC-AGI-2. Em média, esses "painéis" de humanos alcançaram uma taxa de sucesso de 60%, superando significativamente os modelos de IA.
Chollet enfatizou que o ARC-AGI-2 impede que os modelos de IA dependam de poder computacional de "força bruta" para resolver problemas, uma falha que ele reconheceu no primeiro teste. Para abordar isso, o ARC-AGI-2 introduz uma métrica de eficiência e exige que os modelos interpretem padrões no momento, em vez de dependerem de memorização.
Em um post de blog, o co-fundador da Fundação Arc Prize, Greg Kamradt, destacou que a inteligência não se trata apenas de resolver problemas ou alcançar altas pontuações. "A eficiência com que essas capacidades são adquiridas e implementadas é um componente crucial e definidor", ele escreveu. "A questão central não é apenas, 'A IA pode adquirir a habilidade para resolver uma tarefa?', mas também, 'Com que eficiência ou custo?'"
O ARC-AGI-1 permaneceu imbatível por cerca de cinco anos até dezembro de 2024, quando o modelo avançado de raciocínio da OpenAI, o3, superou todos os outros modelos de IA e igualou o desempenho humano. No entanto, o sucesso do o3 no ARC-AGI-1 teve um custo significativo. A versão do modelo o3 da OpenAI, o3 (low), que obteve impressionantes 75,7% no ARC-AGI-1, conseguiu apenas 4% no ARC-AGI-2, usando $200 de poder computacional por tarefa.
Junto com o novo benchmark, a Fundação Arc Prize anunciou o concurso Arc Prize 2025, desafiando desenvolvedores a alcançar 85% de precisão no teste ARC-AGI-2 gastando apenas $0,42 por tarefa.








 O RSI passa a ser o novo AGI, igualmente difícil de definir
O termo “recursão” tornou-se a palavra da moda no campo da inteligência artificial. Duas startups distintas adotaram esse termo como nome, e muitas outras agora fazem referência ao Autoaperfeiçoamento
 A OpenAI traça os contornos da economia da IA com fundos de riqueza pública, impostos sobre robôs e a semana de quatro dias
Enquanto os governos lutam para lidar com o impacto econômico das máquinas superinteligentes, a OpenAI divulgou um conjunto de propostas de políticas que delineiam como a riqueza e o trabalho poderiam
 Co-fundador da Databricks afirma que a IA geral está chegando após receber o prêmio da ACM
Matei Zaharia, cofundador e diretor de tecnologia (CTO) da Databricks, quase deixou passar despercebido o e-mail que o informava de que havia sido agraciado com o Prêmio ACM de Computação de 2026. “Fo

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!












