


 Hogar
La nueva prueba AGI demuestra que los modelos de IA desafiantes y desafiantes
La Fundación Arc Prize, cofundada por el reconocido investigador de IA François Chollet, presentó recientemente un nuevo estándar llamado ARC-AGI-2 en una publicación de blog. Esta prueba busca ampliar los límites de la inteligencia general de la IA, y hasta ahora, está resultando ser un desafío difícil de superar para la mayoría de los modelos de IA.
Según la tabla de clasificación de Arc Prize, incluso los modelos avanzados de IA de "razonamiento" como o1-pro de OpenAI y R1 de DeepSeek solo logran puntajes entre el 1% y el 1.3%. Mientras tanto, modelos potentes sin razonamiento como GPT-4.5, Claude 3.7 Sonnet y Gemini 2.0 Flash están rondando la marca del 1%.
Las pruebas ARC-AGI desafían a los sistemas de IA con problemas similares a rompecabezas, requiriendo que identifiquen patrones visuales en cuadrículas de cuadrados de diferentes colores y generen la cuadrícula de "respuesta" correcta. Estos problemas están diseñados para evaluar la capacidad de una IA para adaptarse a nuevos desafíos no vistos.
Para establecer una línea base humana, la Fundación Arc Prize hizo que más de 400 personas realizaran la prueba ARC-AGI-2. En promedio, estos "paneles" de humanos lograron una tasa de éxito del 60%, superando significativamente a los modelos de IA.
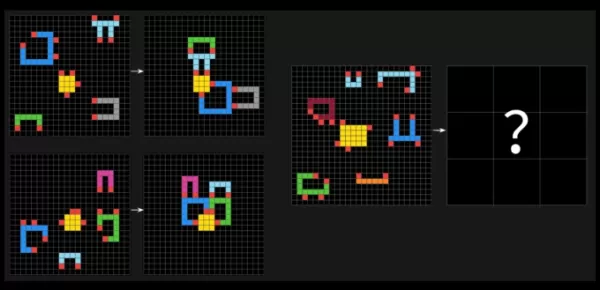
Una pregunta de muestra de ARC-AGI-2. Créditos de la imagen: Arc Prize François Chollet acudió a X para afirmar que ARC-AGI-2 es una medida más precisa de la verdadera inteligencia de un modelo de IA en comparación con su predecesor, ARC-AGI-1. Las pruebas de la Fundación Arc Prize están diseñadas para evaluar si una IA puede aprender eficientemente nuevas habilidades más allá de sus datos de entrenamiento.Chollet enfatizó que ARC-AGI-2 evita que los modelos de IA dependan de la potencia de cálculo de "fuerza bruta" para resolver problemas, un defecto que reconoció en la primera prueba. Para abordar esto, ARC-AGI-2 introduce una métrica de eficiencia y requiere que los modelos interpreten patrones sobre la marcha en lugar de depender de la memorización.
En una publicación de blog, el cofundador de la Fundación Arc Prize, Greg Kamradt, destacó que la inteligencia no se trata solo de resolver problemas o lograr puntajes altos. "La eficiencia con la que se adquieren y despliegan esas capacidades es un componente crucial y definitorio", escribió. "La pregunta central que se plantea no es solo, '¿Puede la IA adquirir la habilidad para resolver una tarea?', sino también, '¿Con qué eficiencia o costo?'"
ARC-AGI-1 permaneció imbatido durante aproximadamente cinco años hasta diciembre de 2024, cuando el modelo avanzado de razonamiento de OpenAI, o3, superó a todos los demás modelos de IA y igualó el rendimiento humano. Sin embargo, el éxito de o3 en ARC-AGI-1 tuvo un costo significativo. La versión del modelo o3 de OpenAI, o3 (bajo), que obtuvo un impresionante 75.7% en ARC-AGI-1, solo logró un escaso 4% en ARC-AGI-2, utilizando $200 de potencia de cálculo por tarea.

Comparación del rendimiento de modelos de IA de vanguardia en ARC-AGI-1 y ARC-AGI-2. Créditos de la imagen: Arc Prize La introducción de ARC-AGI-2 llega en un momento en que muchos en la industria tecnológica están pidiendo nuevos puntos de referencia no saturados para medir el progreso de la IA. Thomas Wolf, cofundador de Hugging Face, recientemente le dijo a TechCrunch que la industria de la IA carece de pruebas suficientes para medir rasgos clave de la inteligencia general artificial, como la creatividad.Junto con el nuevo estándar, la Fundación Arc Prize anunció el concurso Arc Prize 2025, desafiando a los desarrolladores a lograr una precisión del 85% en la prueba ARC-AGI-2 mientras gastan solo $0.42 por tarea.
Artículo relacionado
 El RSI se convierte en el nuevo AGI, igual de difícil de definir
El término «recursión» se ha convertido en la última palabra de moda en el ámbito de la inteligencia artificial. Dos startups distintas lo han adoptado como nombre, y muchas otras hacen ahora referenc
OpenAI esboza la economía de la IA con fondos de riqueza pública, impuestos sobre los robots y la semana laboral de cuatro días
Mientras los gobiernos se esfuerzan por gestionar el impacto económico de las máquinas superinteligentes, OpenAI ha publicado una serie de propuestas políticas en las que se esboza cómo podrían reconf
El cofundador de Databricks afirma que la IA general está al caer tras ganar el premio ACM
Matei Zaharia, cofundador y director técnico de Databricks, estuvo a punto de pasar por alto el correo electrónico en el que se le comunicaba que había sido galardonado con el Premio ACM de Informátic
Recomendaciones de temas especiales relacionados
Creación de vídeos
 Generadores de ganchos para vídeos cortos basados en IA, para Reels, Shorts y campañas de lanzamiento de productos
¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
 11 herramientas
 xix.ai
escribiendo
Herramientas de IA para la estructura de artículos en la redacción de textos extensos
¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai
chatbot
Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

 comentario (40)
0/500
![KeithLopez]()
Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
![DonaldSanchez]()
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
![MarkRoberts]()
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
![RonaldRoberts]()
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
![WillieRoberts]()
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
![GeorgeMiller]()
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!
La Fundación Arc Prize, cofundada por el reconocido investigador de IA François Chollet, presentó recientemente un nuevo estándar llamado ARC-AGI-2 en una publicación de blog. Esta prueba busca ampliar los límites de la inteligencia general de la IA, y hasta ahora, está resultando ser un desafío difícil de superar para la mayoría de los modelos de IA.
Según la tabla de clasificación de Arc Prize, incluso los modelos avanzados de IA de "razonamiento" como o1-pro de OpenAI y R1 de DeepSeek solo logran puntajes entre el 1% y el 1.3%. Mientras tanto, modelos potentes sin razonamiento como GPT-4.5, Claude 3.7 Sonnet y Gemini 2.0 Flash están rondando la marca del 1%.
Las pruebas ARC-AGI desafían a los sistemas de IA con problemas similares a rompecabezas, requiriendo que identifiquen patrones visuales en cuadrículas de cuadrados de diferentes colores y generen la cuadrícula de "respuesta" correcta. Estos problemas están diseñados para evaluar la capacidad de una IA para adaptarse a nuevos desafíos no vistos.
Para establecer una línea base humana, la Fundación Arc Prize hizo que más de 400 personas realizaran la prueba ARC-AGI-2. En promedio, estos "paneles" de humanos lograron una tasa de éxito del 60%, superando significativamente a los modelos de IA.
Chollet enfatizó que ARC-AGI-2 evita que los modelos de IA dependan de la potencia de cálculo de "fuerza bruta" para resolver problemas, un defecto que reconoció en la primera prueba. Para abordar esto, ARC-AGI-2 introduce una métrica de eficiencia y requiere que los modelos interpreten patrones sobre la marcha en lugar de depender de la memorización.
En una publicación de blog, el cofundador de la Fundación Arc Prize, Greg Kamradt, destacó que la inteligencia no se trata solo de resolver problemas o lograr puntajes altos. "La eficiencia con la que se adquieren y despliegan esas capacidades es un componente crucial y definitorio", escribió. "La pregunta central que se plantea no es solo, '¿Puede la IA adquirir la habilidad para resolver una tarea?', sino también, '¿Con qué eficiencia o costo?'"
ARC-AGI-1 permaneció imbatido durante aproximadamente cinco años hasta diciembre de 2024, cuando el modelo avanzado de razonamiento de OpenAI, o3, superó a todos los demás modelos de IA y igualó el rendimiento humano. Sin embargo, el éxito de o3 en ARC-AGI-1 tuvo un costo significativo. La versión del modelo o3 de OpenAI, o3 (bajo), que obtuvo un impresionante 75.7% en ARC-AGI-1, solo logró un escaso 4% en ARC-AGI-2, utilizando $200 de potencia de cálculo por tarea.
Junto con el nuevo estándar, la Fundación Arc Prize anunció el concurso Arc Prize 2025, desafiando a los desarrolladores a lograr una precisión del 85% en la prueba ARC-AGI-2 mientras gastan solo $0.42 por tarea.








 El RSI se convierte en el nuevo AGI, igual de difícil de definir
El término «recursión» se ha convertido en la última palabra de moda en el ámbito de la inteligencia artificial. Dos startups distintas lo han adoptado como nombre, y muchas otras hacen ahora referenc
 OpenAI esboza la economía de la IA con fondos de riqueza pública, impuestos sobre los robots y la semana laboral de cuatro días
Mientras los gobiernos se esfuerzan por gestionar el impacto económico de las máquinas superinteligentes, OpenAI ha publicado una serie de propuestas políticas en las que se esboza cómo podrían reconf
 El cofundador de Databricks afirma que la IA general está al caer tras ganar el premio ACM
Matei Zaharia, cofundador y director técnico de Databricks, estuvo a punto de pasar por alto el correo electrónico en el que se le comunicaba que había sido galardonado con el Premio ACM de Informátic

¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai

¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

Finally a benchmark that shows how far AI still has to go! The ARC-AGI-2 is no joke, and it's humbling to see even the best models fail. 😮
이 새로운 벤치마크, 진짜 어렵네요. 🤯 요새 AI가 다들 잘하는 줄 알았는데 ARC-AGI-2에서 고전 중이라는 소식에 좀 놀랐어요. François Chollet가 만든거라니... 어쩌면 지능의 본질에 더 가까운 테스트일지도? 정말 일반 지능을 측정할 수 있을까 궁금해집니다. 논문 나오면 좀 더 알아봐야겠어요.
¿Un test que la mayoría de las IA no superan? Esto demuestra lo lejos que estamos de la AGI real. Me pregunto si estos benchmarks realmente miden la 'inteligencia' o solo la capacidad de resolver puzzles específicos. 🧩 Parece más un juego para investigadores que un avance práctico.
Новый тест ARC-AGI-2 выглядит как серьёзный вызов для ИИ! 😅 Интересно, насколько близко мы подошли к настоящему общему интеллекту, если даже продвинутые модели справляются с трудом. Может, ключ в комбинации логики и творческого подхода?
This ARC-AGI-2 test sounds brutal! Most AI models are getting crushed, which makes me wonder if we’re hyping AI too much. 🤔 Cool to see Chollet shaking things up though!
Este test ARC-AGI-2 es realmente difícil. Lo probé con varios modelos de IA y todos se quedaron atascados. Es genial ver cómo desafía los límites, pero es frustrante cuando ni siquiera los modelos top pueden resolverlo. Quizás sea hora de un nuevo enfoque en el desarrollo de IA. ¡Sigan empujando los límites, pero no olviden celebrar las pequeñas victorias también!












