


 Дом
Gaia представляет новый эталон в поисках истинного интеллекта за пределами Arc-Agi
Интеллект повсюду, но его точное измерение похоже на попытку поймать облако голыми руками. Мы используем тесты и эталоны, такие как вступительные экзамены в колледж, чтобы получить общее представление. Каждый год студенты готовятся к этим тестам, иногда даже набирая идеальные 100%. Но означает ли этот идеальный результат, что все они обладают одинаковым уровнем интеллекта или что они достигли пика своих умственных способностей? Конечно, нет. Эти эталоны — лишь приблизительные оценки, а не точные индикаторы истинных способностей человека.
В мире генеративного ИИ эталоны, такие как MMLU (Массивное многоцелевое понимание языка), стали основным инструментом для оценки моделей с помощью вопросов с множественным выбором по различным академическим дисциплинам. Хотя они позволяют легко сравнивать, они не охватывают полный спектр интеллектуальных возможностей.
Возьмем, к примеру, Claude 3.5 Sonnet и GPT-4.5. Они могут показать схожие результаты на MMLU, что говорит о том, что они на одном уровне. Но любой, кто действительно использовал эти модели, знает, что их реальная производительность может сильно различаться.
Что значит измерять «интеллект» в ИИ?
С недавним запуском эталона ARC-AGI, предназначенного для тестирования моделей на общее рассуждение и творческое решение проблем, началась новая волна обсуждений о том, что означает измерение «интеллекта» в ИИ. Не все еще успели изучить ARC-AGI, но в индустрии активно обсуждают этот и другие новые подходы к тестированию. Каждый эталон имеет свое место, и ARC-AGI — это шаг в правильном направлении.
Еще одно захватывающее событие — это «Последний экзамен человечества», комплексный эталон с 3000 рецензируемыми многоэтапными вопросами, охватывающими различные дисциплины. Это амбициозная попытка подтолкнуть системы ИИ к рассуждениям на уровне экспертов. Ранние результаты показывают быстрый прогресс: сообщается, что OpenAI достигла результата 26,6% всего через месяц после выпуска. Но, как и другие эталоны, он в основном сосредоточен на знаниях и рассуждениях в вакууме, а не на практических навыках использования инструментов, которые жизненно важны для реальных приложений ИИ.
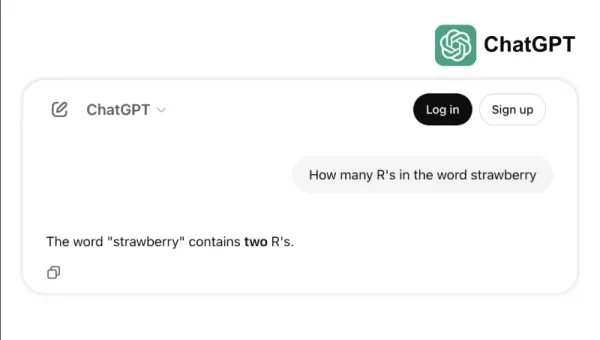
Возьмем, например, как некоторые ведущие модели с трудом справляются с простыми задачами, такими как подсчет букв «р» в слове «клубника» или сравнение чисел 3,8 и 3,1111. Эти ошибки, которых даже ребенок или простой калькулятор могли бы избежать, подчеркивают разрыв между успехом на эталонах и надежностью в реальном мире. Это напоминание о том, что интеллект — это не только успешное прохождение тестов, но и умение легко справляться с повседневной логикой.
Новый стандарт для измерения возможностей ИИ
По мере развития моделей ИИ ограничения традиционных эталонов становятся все более очевидными. Например, GPT-4, оснащенный инструментами, набирает всего около 15% на более сложных задачах реального мира в эталоне GAIA, несмотря на высокие результаты в тестах с множественным выбором.
Это несоответствие между производительностью на эталонах и практическими возможностями становится все более проблематичным по мере перехода систем ИИ из исследовательских лабораторий в бизнес-приложения. Традиционные эталоны тестируют, насколько хорошо модель может вспомнить информацию, но часто упускают ключевые аспекты интеллекта, такие как способность собирать данные, выполнять код, анализировать информацию и создавать решения в различных областях.
Появился GAIA, новый эталон, который знаменует значительный сдвиг в оценке ИИ. Разработанный в сотрудничестве между командами Meta-FAIR, Meta-GenAI, HuggingFace и AutoGPT, GAIA включает 466 тщательно разработанных вопросов на трех уровнях сложности. Эти вопросы тестируют широкий спектр навыков, необходимых для реальных приложений ИИ, включая веб-поиск, мультимодальное понимание, выполнение кода, работу с файлами и сложные рассуждения.
Вопросы уровня 1 обычно требуют около 5 шагов и одного инструмента для решения человеком. Вопросы уровня 2 требуют от 5 до 10 шагов и нескольких инструментов, а вопросы уровня 3 могут потребовать до 50 шагов и любого количества инструментов. Эта структура отражает сложность реальных бизнес-проблем, где решения часто включают множество действий и инструментов.
Сосредоточившись на гибкости, а не только на сложности, одна модель ИИ достигла точности 75% на GAIA, превзойдя лидеров отрасли, таких как Microsoft Magnetic-1 (38%) и Google Langfun Agent (49%). Этот успех достигнут благодаря использованию комбинации специализированных моделей для аудиовизуального понимания и рассуждений, с Anthropic Sonnet 3.5 в качестве основной модели.
Этот сдвиг в оценке ИИ отражает более широкую тенденцию в индустрии: мы отходим от автономных SaaS-приложений к агентам ИИ, которые могут управлять несколькими инструментами и рабочими процессами. По мере того как бизнес все больше полагается на ИИ для решения сложных многоэтапных задач, эталоны, такие как GAIA, предлагают более релевантную меру возможностей, чем традиционные тесты с множественным выбором.
Будущее оценки ИИ — это не изолированные тесты знаний; это комплексные оценки способности решать проблемы. GAIA устанавливает новый эталон для измерения возможностей ИИ — тот, который лучше соответствует реальным вызовам и возможностям внедрения ИИ.
Сри Амбати — основатель и генеральный директор H2O.ai.
Связанная статья
 ИИ раскрывает скрытые мотивы в новостном контенте
Модели в стиле ChatGPT сейчас обучаются выявлять основную точку зрения новостной статьи — даже если эта точка зрения скрыта за цитатами, формулировками или фасадом (иногда неискренней) нейтральности.
Claude 4.1 от Anthropic превосходит GPT-5 по результатам тестов на кодирование перед запуском GPT-5
В понедельник компания Anthropic представила усовершенствованную версию своей ведущей модели искусственного интеллекта, установив новый стандарт производительности в области программного обеспечения.
Nvidia представила модель искусственного интеллекта Nemotron-Nano-9B-v2 с открытым исходным кодом и возможностью отключаемого рассуждения
Небольшие языковые модели набирают популярность. После дебюта модели искусственного зрения размером со смарт-часы от Liquid AI, созданной на базе технологий MIT, и предложения Google для смартфонов, N
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
 8 инструментов
 xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

 Комментарии (4)
![SamuelRamirez]()
Interesting benchmark! But I wonder if focusing too much on benchmarks might lead to AI that's just good at passing tests, not truly understanding the world. Reminds me of students who ace exams but struggle with real-life problems. 🤔
![ThomasLewis]()
このGAIAベンチマークは確かに面白いですね。AIの知性を測る方法はもっと多様なはず。人間だってテストだけでは測れないんだから、AIにも同様に自分たちの理解できる尺度が適しているのかな?実は市場競争ばかり意識すると、基準が歪んでしまうんじゃないかと心配😅
![BillyAdams]()
This GAIA benchmark sounds intriguing! Makes me wonder if we’re finally getting closer to measuring true intelligence or just chasing fancier numbers. 🤔 What’s next, AI acing philosophy exams?
![GaryThomas]()
This GAIA benchmark sounds intriguing! 🤔 It’s like trying to measure a rainbow with a ruler—cool concept, but can it really capture true intelligence? I wonder how it compares to ARC-AGI in practical applications.
Интеллект повсюду, но его точное измерение похоже на попытку поймать облако голыми руками. Мы используем тесты и эталоны, такие как вступительные экзамены в колледж, чтобы получить общее представление. Каждый год студенты готовятся к этим тестам, иногда даже набирая идеальные 100%. Но означает ли этот идеальный результат, что все они обладают одинаковым уровнем интеллекта или что они достигли пика своих умственных способностей? Конечно, нет. Эти эталоны — лишь приблизительные оценки, а не точные индикаторы истинных способностей человека.
В мире генеративного ИИ эталоны, такие как MMLU (Массивное многоцелевое понимание языка), стали основным инструментом для оценки моделей с помощью вопросов с множественным выбором по различным академическим дисциплинам. Хотя они позволяют легко сравнивать, они не охватывают полный спектр интеллектуальных возможностей.
Возьмем, к примеру, Claude 3.5 Sonnet и GPT-4.5. Они могут показать схожие результаты на MMLU, что говорит о том, что они на одном уровне. Но любой, кто действительно использовал эти модели, знает, что их реальная производительность может сильно различаться.
Что значит измерять «интеллект» в ИИ?
С недавним запуском эталона ARC-AGI, предназначенного для тестирования моделей на общее рассуждение и творческое решение проблем, началась новая волна обсуждений о том, что означает измерение «интеллекта» в ИИ. Не все еще успели изучить ARC-AGI, но в индустрии активно обсуждают этот и другие новые подходы к тестированию. Каждый эталон имеет свое место, и ARC-AGI — это шаг в правильном направлении.
Еще одно захватывающее событие — это «Последний экзамен человечества», комплексный эталон с 3000 рецензируемыми многоэтапными вопросами, охватывающими различные дисциплины. Это амбициозная попытка подтолкнуть системы ИИ к рассуждениям на уровне экспертов. Ранние результаты показывают быстрый прогресс: сообщается, что OpenAI достигла результата 26,6% всего через месяц после выпуска. Но, как и другие эталоны, он в основном сосредоточен на знаниях и рассуждениях в вакууме, а не на практических навыках использования инструментов, которые жизненно важны для реальных приложений ИИ.
Возьмем, например, как некоторые ведущие модели с трудом справляются с простыми задачами, такими как подсчет букв «р» в слове «клубника» или сравнение чисел 3,8 и 3,1111. Эти ошибки, которых даже ребенок или простой калькулятор могли бы избежать, подчеркивают разрыв между успехом на эталонах и надежностью в реальном мире. Это напоминание о том, что интеллект — это не только успешное прохождение тестов, но и умение легко справляться с повседневной логикой.
Новый стандарт для измерения возможностей ИИ
По мере развития моделей ИИ ограничения традиционных эталонов становятся все более очевидными. Например, GPT-4, оснащенный инструментами, набирает всего около 15% на более сложных задачах реального мира в эталоне GAIA, несмотря на высокие результаты в тестах с множественным выбором.
Это несоответствие между производительностью на эталонах и практическими возможностями становится все более проблематичным по мере перехода систем ИИ из исследовательских лабораторий в бизнес-приложения. Традиционные эталоны тестируют, насколько хорошо модель может вспомнить информацию, но часто упускают ключевые аспекты интеллекта, такие как способность собирать данные, выполнять код, анализировать информацию и создавать решения в различных областях.
Появился GAIA, новый эталон, который знаменует значительный сдвиг в оценке ИИ. Разработанный в сотрудничестве между командами Meta-FAIR, Meta-GenAI, HuggingFace и AutoGPT, GAIA включает 466 тщательно разработанных вопросов на трех уровнях сложности. Эти вопросы тестируют широкий спектр навыков, необходимых для реальных приложений ИИ, включая веб-поиск, мультимодальное понимание, выполнение кода, работу с файлами и сложные рассуждения.
Вопросы уровня 1 обычно требуют около 5 шагов и одного инструмента для решения человеком. Вопросы уровня 2 требуют от 5 до 10 шагов и нескольких инструментов, а вопросы уровня 3 могут потребовать до 50 шагов и любого количества инструментов. Эта структура отражает сложность реальных бизнес-проблем, где решения часто включают множество действий и инструментов.
Сосредоточившись на гибкости, а не только на сложности, одна модель ИИ достигла точности 75% на GAIA, превзойдя лидеров отрасли, таких как Microsoft Magnetic-1 (38%) и Google Langfun Agent (49%). Этот успех достигнут благодаря использованию комбинации специализированных моделей для аудиовизуального понимания и рассуждений, с Anthropic Sonnet 3.5 в качестве основной модели.
Этот сдвиг в оценке ИИ отражает более широкую тенденцию в индустрии: мы отходим от автономных SaaS-приложений к агентам ИИ, которые могут управлять несколькими инструментами и рабочими процессами. По мере того как бизнес все больше полагается на ИИ для решения сложных многоэтапных задач, эталоны, такие как GAIA, предлагают более релевантную меру возможностей, чем традиционные тесты с множественным выбором.
Будущее оценки ИИ — это не изолированные тесты знаний; это комплексные оценки способности решать проблемы. GAIA устанавливает новый эталон для измерения возможностей ИИ — тот, который лучше соответствует реальным вызовам и возможностям внедрения ИИ.
Сри Амбати — основатель и генеральный директор H2O.ai.








 ИИ раскрывает скрытые мотивы в новостном контенте
Модели в стиле ChatGPT сейчас обучаются выявлять основную точку зрения новостной статьи — даже если эта точка зрения скрыта за цитатами, формулировками или фасадом (иногда неискренней) нейтральности.
 Claude 4.1 от Anthropic превосходит GPT-5 по результатам тестов на кодирование перед запуском GPT-5
В понедельник компания Anthropic представила усовершенствованную версию своей ведущей модели искусственного интеллекта, установив новый стандарт производительности в области программного обеспечения.
 Nvidia представила модель искусственного интеллекта Nemotron-Nano-9B-v2 с открытым исходным кодом и возможностью отключаемого рассуждения
Небольшие языковые модели набирают популярность. После дебюта модели искусственного зрения размером со смарт-часы от Liquid AI, созданной на базе технологий MIT, и предложения Google для смартфонов, N

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

Interesting benchmark! But I wonder if focusing too much on benchmarks might lead to AI that's just good at passing tests, not truly understanding the world. Reminds me of students who ace exams but struggle with real-life problems. 🤔
このGAIAベンチマークは確かに面白いですね。AIの知性を測る方法はもっと多様なはず。人間だってテストだけでは測れないんだから、AIにも同様に自分たちの理解できる尺度が適しているのかな?実は市場競争ばかり意識すると、基準が歪んでしまうんじゃないかと心配😅
This GAIA benchmark sounds intriguing! Makes me wonder if we’re finally getting closer to measuring true intelligence or just chasing fancier numbers. 🤔 What’s next, AI acing philosophy exams?
This GAIA benchmark sounds intriguing! 🤔 It’s like trying to measure a rainbow with a ruler—cool concept, but can it really capture true intelligence? I wonder how it compares to ARC-AGI in practical applications.












