


 家
ガイアは、Arc-Agiを超えた真の知性を求めて新しいベンチマークを紹介します
知性はどこにでも存在しますが、それを正確に測定するのは、素手で雲をつかむようなものです。私たちは大学入試のようなテストやベンチマークを使って大まかな見当をつけます。毎年、学生たちはこれらのテストのために詰め込み勉強をし、時には100%の完璧なスコアを獲得します。しかし、その完璧なスコアは、彼らがみな同じレベルの知性を持っていること、あるいは彼らの精神的潜在能力のピークに達したことを意味するのでしょうか?もちろん違います。これらのベンチマークは、誰かの本当の能力を正確に示すものではなく、粗い推定にすぎません。
生成AIの世界では、MMLU(Massive Multitask Language Understanding)のようなベンチマークが、さまざまな学術分野にわたる多肢選択問題を通じてモデルを評価するための標準でした。これらは簡単な比較を可能にしますが、知的能力の全範囲を本当に捉えているわけではありません。
たとえば、Claude 3.5 SonnetとGPT-4.5を取り上げてみましょう。MMLUでのスコアが似ているため、同等の性能を持つように見えます。しかし、これらのモデルを実際に使ったことがある人なら、実世界でのパフォーマンスがかなり異なることを知っています。
AIにおける「知性」の測定とは何か?
最近、ARC-AGIベンチマークが開始され、一般的な推論や創造的な問題解決をテストするために設計されたことで、AIにおける「知性」の測定とは何かをめぐる新たな議論が巻き起こっています。まだ誰もがARC-AGIに深く取り組んだわけではありませんが、業界はこの新しいテストアプローチや他の新しい方法について盛り上がっています。すべてのベンチマークにはそれぞれの役割があり、ARC-AGIは正しい方向への一歩です。
もう一つのエキサイティングな進展は、「Humanity's Last Exam」です。これは、さまざまな分野にわたる3,000の査読済み多段階質問からなる包括的なベンチマークです。AIシステムを専門家レベルの推論に挑戦させる野心的な試みです。初期の結果は急速な進歩を示しており、OpenAIはリリースからわずか1か月で26.6%のスコアを記録したとされています。しかし、他のベンチマークと同様に、これは主に知識と真空状態での推論に焦点を当てており、実世界のAIアプリケーションに不可欠な実際のツール使用スキルには焦点を当てていません。
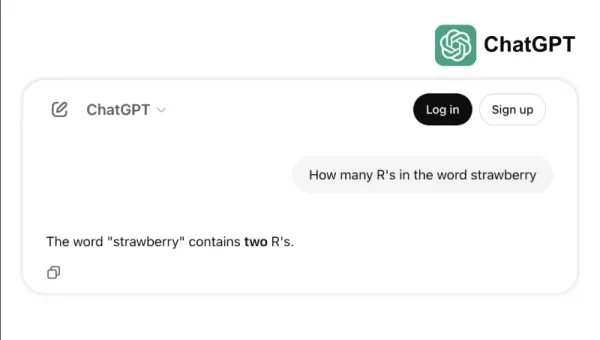
たとえば、トップモデルの一部が「strawberry」の「r」の数を数えるような簡単なタスクや、3.8と3.1111の比較で苦戦する様子を見てみましょう。これらのエラーは、子供や基本的な電卓でも避けられるものであり、ベンチマークの成功と実世界の信頼性の間のギャップを浮き彫りにします。知性とは、テストで高得点を出すことだけでなく、日常の論理を容易に操ることであるということを思い出させます。
AI能力を測定する新しい基準
AIモデルが進化するにつれて、従来のベンチマークの限界がより明らかになってきました。たとえば、ツールを備えたGPT-4は、多肢選択テストで高得点を記録しているにもかかわらず、GAIAベンチマークのより複雑な実世界のタスクでは約15%しかスコアを獲得できません。
ベンチマークのパフォーマンスと実際の能力の間のこの乖離は、AIシステムが研究室からビジネスアプリケーションに移行するにつれてますます問題となっています。従来のベンチマークは、モデルが情報をどれだけ正確に思い出すかをテストしますが、データを収集し、コードを実行し、情報を分析し、さまざまな領域でソリューションを作成する能力など、知性の重要な側面をしばしば見落とします。
そこで登場するのがGAIAです。これはAI評価における大きな変化を示す新しいベンチマークです。Meta-FAIR、Meta-GenAI、HuggingFace、AutoGPTのチームによる協力で開発されたGAIAは、3つの難易度レベルにわたる466の慎重に作成された質問を含んでいます。これらの質問は、ウェブブラウジング、マルチモーダル理解、コード実行、ファイル処理、複雑な推論など、実世界のAIアプリケーションに不可欠な幅広いスキルをテストします。
レベル1の質問は通常、5ステップと1つのツールで人間が解決する必要があります。レベル2の質問は5~10ステップと複数のツールが必要で、レベル3の質問は最大50ステップと任意の数のツールを要求する可能性があります。この構造は、実際のビジネス問題の複雑さを反映しており、解決策にはしばしば複数のアクションとツールが関与します。
複雑さだけでなく柔軟性に焦点を当てることで、あるAIモデルはGAIAで75%の正確率を達成し、MicrosoftのMagnetic-1(38%)やGoogleのLangfun Agent(49%)などの業界リーダーを上回りました。この成功は、オーディオビジュアル理解と推論のための専門モデルの組み合わせを使用し、AnthropicのSonnet 3.5を主要モデルとして採用した結果です。
AI評価のこの変化は、業界全体のより大きなトレンドを反映しています。スタンドアローンのSaaSアプリケーションから、複数のツールとワークフローを管理できるAIエージェントへと移行しています。ビジネスが複雑な多段階タスクを処理するためにAIにますます依存する中、GAIAのようなベンチマークは、従来の多肢選択テストよりも関連性の高い能力の尺度を提供します。
AI評価の未来は、孤立した知識テストではなく、問題解決能力の包括的な評価に関するものです。GAIAは、AI能力を測定するための新しい基準を設定し、AI展開の実世界の課題と機会により良く適合します。
Sri AmbatiはH2O.aiの創設者兼CEOです。
関連記事
 AIがニュースコンテンツに潜む隠された意図を明らかにする
ChatGPTスタイルのモデルは現在、ニュース記事の根底にある視点を解明するよう訓練されている——たとえその視点が引用文やフレームワーク、あるいは(時に不誠実な)中立性の覆いの下に隠されていても。見出し、リード文、引用文といったセグメントに記事を分割することで、新たなシステムは長文のプロフェッショナルなジャーナリズムにおいても偏りを識別することを学習する。 執筆者や発言者の真の立場を把握する能力—
AnthropicのClaude 4.1、GPT-5発表前にコーディングベンチマークで優れた性能を発揮
アンソロピックは月曜日、主力AIモデルの強化版を発表し、ソフトウェアエンジニアリングタスクにおける性能の新たな基準を打ち立てた。この展開により、AIスタートアップは収益性の高いコーディング分野での強固な地位を防衛する態勢を整え、OpenAIからの新たな競争を予期している。新モデル「Claude Opus 4.1」は、AIシステムの現実的なソフトウェア課題解決能力を評価する主要ベンチマーク「SWE-
Nvidia、トグル可能な推論機能を備えたオープンソースAIモデル「Nemotron-Nano-9B-v2」を発表
小型言語モデルが注目を集めている。 MITスピンオフ企業Liquid AIのスマートウォッチサイズ視覚モデルやGoogleのスマートフォン対応モデルの登場に続き、Nvidiaも独自の軽量モデル「Nemotron-Nano-9B-V2」で参入した。この新モデルは主要ベンチマークで同クラスをリードし、AIの「推論」機能(最終回答前の自己チェックプロセス)をユーザーが有効/無効にできる独自機能を導入して
関連特集おすすめ
チャットボット
 面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
 12 ツール
 xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
データ分析
最強のAIデータクリーニングツール:欠損値や重複データを迅速に修正
2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai
デザインとアート
アーティストのための最高のAIクリエイティブアイディエーションツール:ビジュアルブロックを打破する
2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

 コメント (4)
0/500
![SamuelRamirez]()
Interesting benchmark! But I wonder if focusing too much on benchmarks might lead to AI that's just good at passing tests, not truly understanding the world. Reminds me of students who ace exams but struggle with real-life problems. 🤔
![ThomasLewis]()
このGAIAベンチマークは確かに面白いですね。AIの知性を測る方法はもっと多様なはず。人間だってテストだけでは測れないんだから、AIにも同様に自分たちの理解できる尺度が適しているのかな?実は市場競争ばかり意識すると、基準が歪んでしまうんじゃないかと心配😅
![BillyAdams]()
This GAIA benchmark sounds intriguing! Makes me wonder if we’re finally getting closer to measuring true intelligence or just chasing fancier numbers. 🤔 What’s next, AI acing philosophy exams?
![GaryThomas]()
This GAIA benchmark sounds intriguing! 🤔 It’s like trying to measure a rainbow with a ruler—cool concept, but can it really capture true intelligence? I wonder how it compares to ARC-AGI in practical applications.
知性はどこにでも存在しますが、それを正確に測定するのは、素手で雲をつかむようなものです。私たちは大学入試のようなテストやベンチマークを使って大まかな見当をつけます。毎年、学生たちはこれらのテストのために詰め込み勉強をし、時には100%の完璧なスコアを獲得します。しかし、その完璧なスコアは、彼らがみな同じレベルの知性を持っていること、あるいは彼らの精神的潜在能力のピークに達したことを意味するのでしょうか?もちろん違います。これらのベンチマークは、誰かの本当の能力を正確に示すものではなく、粗い推定にすぎません。
生成AIの世界では、MMLU(Massive Multitask Language Understanding)のようなベンチマークが、さまざまな学術分野にわたる多肢選択問題を通じてモデルを評価するための標準でした。これらは簡単な比較を可能にしますが、知的能力の全範囲を本当に捉えているわけではありません。
たとえば、Claude 3.5 SonnetとGPT-4.5を取り上げてみましょう。MMLUでのスコアが似ているため、同等の性能を持つように見えます。しかし、これらのモデルを実際に使ったことがある人なら、実世界でのパフォーマンスがかなり異なることを知っています。
AIにおける「知性」の測定とは何か?
最近、ARC-AGIベンチマークが開始され、一般的な推論や創造的な問題解決をテストするために設計されたことで、AIにおける「知性」の測定とは何かをめぐる新たな議論が巻き起こっています。まだ誰もがARC-AGIに深く取り組んだわけではありませんが、業界はこの新しいテストアプローチや他の新しい方法について盛り上がっています。すべてのベンチマークにはそれぞれの役割があり、ARC-AGIは正しい方向への一歩です。
もう一つのエキサイティングな進展は、「Humanity's Last Exam」です。これは、さまざまな分野にわたる3,000の査読済み多段階質問からなる包括的なベンチマークです。AIシステムを専門家レベルの推論に挑戦させる野心的な試みです。初期の結果は急速な進歩を示しており、OpenAIはリリースからわずか1か月で26.6%のスコアを記録したとされています。しかし、他のベンチマークと同様に、これは主に知識と真空状態での推論に焦点を当てており、実世界のAIアプリケーションに不可欠な実際のツール使用スキルには焦点を当てていません。
たとえば、トップモデルの一部が「strawberry」の「r」の数を数えるような簡単なタスクや、3.8と3.1111の比較で苦戦する様子を見てみましょう。これらのエラーは、子供や基本的な電卓でも避けられるものであり、ベンチマークの成功と実世界の信頼性の間のギャップを浮き彫りにします。知性とは、テストで高得点を出すことだけでなく、日常の論理を容易に操ることであるということを思い出させます。
AI能力を測定する新しい基準
AIモデルが進化するにつれて、従来のベンチマークの限界がより明らかになってきました。たとえば、ツールを備えたGPT-4は、多肢選択テストで高得点を記録しているにもかかわらず、GAIAベンチマークのより複雑な実世界のタスクでは約15%しかスコアを獲得できません。
ベンチマークのパフォーマンスと実際の能力の間のこの乖離は、AIシステムが研究室からビジネスアプリケーションに移行するにつれてますます問題となっています。従来のベンチマークは、モデルが情報をどれだけ正確に思い出すかをテストしますが、データを収集し、コードを実行し、情報を分析し、さまざまな領域でソリューションを作成する能力など、知性の重要な側面をしばしば見落とします。
そこで登場するのがGAIAです。これはAI評価における大きな変化を示す新しいベンチマークです。Meta-FAIR、Meta-GenAI、HuggingFace、AutoGPTのチームによる協力で開発されたGAIAは、3つの難易度レベルにわたる466の慎重に作成された質問を含んでいます。これらの質問は、ウェブブラウジング、マルチモーダル理解、コード実行、ファイル処理、複雑な推論など、実世界のAIアプリケーションに不可欠な幅広いスキルをテストします。
レベル1の質問は通常、5ステップと1つのツールで人間が解決する必要があります。レベル2の質問は5~10ステップと複数のツールが必要で、レベル3の質問は最大50ステップと任意の数のツールを要求する可能性があります。この構造は、実際のビジネス問題の複雑さを反映しており、解決策にはしばしば複数のアクションとツールが関与します。
複雑さだけでなく柔軟性に焦点を当てることで、あるAIモデルはGAIAで75%の正確率を達成し、MicrosoftのMagnetic-1(38%)やGoogleのLangfun Agent(49%)などの業界リーダーを上回りました。この成功は、オーディオビジュアル理解と推論のための専門モデルの組み合わせを使用し、AnthropicのSonnet 3.5を主要モデルとして採用した結果です。
AI評価のこの変化は、業界全体のより大きなトレンドを反映しています。スタンドアローンのSaaSアプリケーションから、複数のツールとワークフローを管理できるAIエージェントへと移行しています。ビジネスが複雑な多段階タスクを処理するためにAIにますます依存する中、GAIAのようなベンチマークは、従来の多肢選択テストよりも関連性の高い能力の尺度を提供します。
AI評価の未来は、孤立した知識テストではなく、問題解決能力の包括的な評価に関するものです。GAIAは、AI能力を測定するための新しい基準を設定し、AI展開の実世界の課題と機会により良く適合します。
Sri AmbatiはH2O.aiの創設者兼CEOです。








 AIがニュースコンテンツに潜む隠された意図を明らかにする
ChatGPTスタイルのモデルは現在、ニュース記事の根底にある視点を解明するよう訓練されている——たとえその視点が引用文やフレームワーク、あるいは(時に不誠実な)中立性の覆いの下に隠されていても。見出し、リード文、引用文といったセグメントに記事を分割することで、新たなシステムは長文のプロフェッショナルなジャーナリズムにおいても偏りを識別することを学習する。 執筆者や発言者の真の立場を把握する能力—
 AnthropicのClaude 4.1、GPT-5発表前にコーディングベンチマークで優れた性能を発揮
アンソロピックは月曜日、主力AIモデルの強化版を発表し、ソフトウェアエンジニアリングタスクにおける性能の新たな基準を打ち立てた。この展開により、AIスタートアップは収益性の高いコーディング分野での強固な地位を防衛する態勢を整え、OpenAIからの新たな競争を予期している。新モデル「Claude Opus 4.1」は、AIシステムの現実的なソフトウェア課題解決能力を評価する主要ベンチマーク「SWE-
 Nvidia、トグル可能な推論機能を備えたオープンソースAIモデル「Nemotron-Nano-9B-v2」を発表
小型言語モデルが注目を集めている。 MITスピンオフ企業Liquid AIのスマートウォッチサイズ視覚モデルやGoogleのスマートフォン対応モデルの登場に続き、Nvidiaも独自の軽量モデル「Nemotron-Nano-9B-V2」で参入した。この新モデルは主要ベンチマークで同クラスをリードし、AIの「推論」機能(最終回答前の自己チェックプロセス)をユーザーが有効/無効にできる独自機能を導入して

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

Interesting benchmark! But I wonder if focusing too much on benchmarks might lead to AI that's just good at passing tests, not truly understanding the world. Reminds me of students who ace exams but struggle with real-life problems. 🤔
このGAIAベンチマークは確かに面白いですね。AIの知性を測る方法はもっと多様なはず。人間だってテストだけでは測れないんだから、AIにも同様に自分たちの理解できる尺度が適しているのかな?実は市場競争ばかり意識すると、基準が歪んでしまうんじゃないかと心配😅
This GAIA benchmark sounds intriguing! Makes me wonder if we’re finally getting closer to measuring true intelligence or just chasing fancier numbers. 🤔 What’s next, AI acing philosophy exams?
This GAIA benchmark sounds intriguing! 🤔 It’s like trying to measure a rainbow with a ruler—cool concept, but can it really capture true intelligence? I wonder how it compares to ARC-AGI in practical applications.












