


 집
Gaia는 Arc-agi 이상의 True Intelligence를 찾기 위해 새로운 벤치 마크를 소개합니다.
지능은 어디에나 존재하지만, 그것을 정확히 측정하는 것은 맨손으로 구름을 잡으려는 것처럼 느껴집니다. 우리는 대학 입시와 같은 테스트와 벤치마크를 사용해 대략적인 아이디어를 얻습니다. 매년 학생들은 이러한 테스트를 위해 벼락치기를 하고, 때로는 100% 완벽한 점수를 받기도 합니다. 하지만 그 완벽한 점수가 그들이 모두 같은 수준의 지능을 가지고 있거나, 그들의 정신적 잠재력의 정점에 도달했음을 의미할까요? 물론 아닙니다. 이러한 벤치마크는 대략적인 추정치일 뿐, 누군가의 진정한 능력을 정확히 나타내는 지표는 아닙니다.
생성 AI의 세계에서는 MMLU(Massive Multitask Language Understanding)와 같은 벤치마크가 다양한 학문 분야에 걸친 다지선다 질문을 통해 모델을 평가하는 데 주로 사용되었습니다. 이는 쉬운 비교를 가능하게 하지만, 지능적 능력의 전체 스펙트럼을 완전히 포착하지는 못합니다.
예를 들어, Claude 3.5 Sonnet과 GPT-4.5를 살펴보면, 그들은 MMLU에서 비슷한 점수를 받을 수 있어 비슷한 수준으로 보일 수 있습니다. 하지만 이 모델들을 실제로 사용해본 사람은 그들의 실세계 성능이 상당히 다를 수 있다는 것을 압니다.
AI에서 '지능'을 측정한다는 것은 무엇을 의미할까?
최근 ARC-AGI 벤치마크가 출시되면서, 일반적 추론과 창의적 문제 해결을 테스트하기 위해 설계된 이 벤치마크는 AI에서 "지능"을 측정하는 것이 무엇을 의미하는지에 대한 새로운 논의를 불러일으켰습니다. 아직 모두가 ARC-AGI를 깊이 탐구할 기회는 없었지만, 업계는 이와 다른 새로운 테스트 접근법에 대해 떠들썩합니다. 모든 벤치마크는 제자리를 가지고 있으며, ARC-AGI는 올바른 방향으로 나아가는 한 걸음입니다.
또 다른 흥미로운 발전은 3,000개의 동료 검토를 거친 다단계 질문으로 구성된 포괄적인 벤치마크인 'Humanity's Last Exam'입니다. 이는 AI 시스템을 전문가 수준의 추론으로 밀어붙이려는 야심찬 노력입니다. 초기 결과는 빠른 진전을 보여주며, OpenAI는 출시 한 달 만에 26.6%의 점수를 기록했다고 전해집니다. 하지만 다른 벤치마크와 마찬가지로, 이는 주로 지식과 추론에 초점을 맞추며, 실세계 AI 응용에 필수적인 실용적이고 도구를 사용하는 기술에는 집중하지 않습니다.
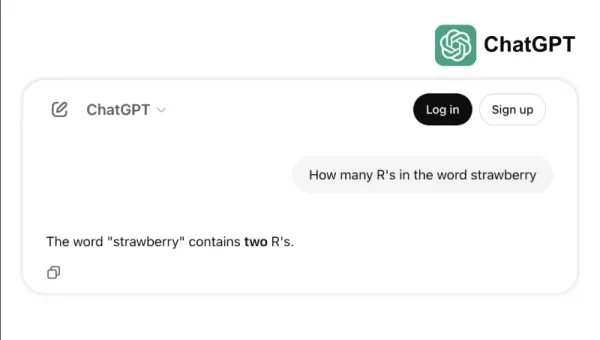
예를 들어, 일부 최고 모델들이 "strawberry"에서 "r"의 개수를 세는 것과 같은 간단한 작업이나 3.8과 3.1111을 비교하는 데 어려움을 겪는 경우를 생각해보세요. 이러한 오류는 어린이나 기본 계산기조차 피할 수 있는 것인데, 이는 벤치마크 성공과 실세계 신뢰성 사이의 간극을 보여줍니다. 이는 지능이 단순히 테스트를 잘 치는 것뿐만 아니라, 일상적인 논리를 쉽게 탐색하는 것에 관한 것임을 상기시킵니다.
AI 능력 측정을 위한 새로운 표준
AI 모델이 발전함에 따라 전통적인 벤치마크의 한계가 더욱 명확해졌습니다. 예를 들어, GPT-4는 도구를 사용할 때 GAIA 벤치마크의 더 복잡한 실세계 작업에서 약 15%의 점수만을 기록하며, 다지선다 테스트에서의 높은 점수에도 불구하고 한계를 드러냅니다.
벤치마크 성능과 실제 능력 간의 이러한 불일치는 AI 시스템이 연구실에서 비즈니스 응용으로 전환됨에 따라 점점 더 문제가 됩니다. 전통적인 벤치마크는 모델이 정보를 얼마나 잘 회상하는지를 테스트하지만, 데이터를 수집하고, 코드를 실행하고, 정보를 분석하고, 다양한 도메인에서 솔루션을 만드는 등의 핵심 지능 요소는 종종 간과됩니다.
GAIA는 AI 평가에 있어 중대한 변화를 가져오는 새로운 벤치마크입니다. Meta-FAIR, Meta-GenAI, HuggingFace, AutoGPT 팀의 협력을 통해 개발된 GAIA는 466개의 세심하게 제작된 질문을 세 가지 난이도 수준으로 포함합니다. 이러한 질문들은 웹 브라우징, 다중 모달 이해, 코드 실행, 파일 처리, 복잡한 추론 등 실세계 AI 응용에 필수적인 다양한 기술을 테스트합니다.
레벨 1 질문은 일반적으로 인간이 해결하는 데 약 5단계와 하나의 도구를 필요로 합니다. 레벨 2 질문은 5~10단계와 여러 도구를 요구하며, 레벨 3 질문은 최대 50단계와 다양한 도구를 요구할 수 있습니다. 이 구조는 실제 비즈니스 문제의 복잡성을 반영하며, 솔루션은 종종 여러 행동과 도구를 포함합니다.
복잡성뿐만 아니라 유연성에 초점을 맞춤으로써, 한 AI 모델은 GAIA에서 75%의 정확도를 달성하며 Microsoft의 Magnetic-1(38%)과 Google의 Langfun Agent(49%)와 같은 업계 리더를 능가했습니다. 이 성공은 오디오-비주얼 이해와 추론을 위한 특화된 모델을 혼합하고, Anthropic의 Sonnet 3.5를 메인 모델로 사용한 결과입니다.
AI 평가의 이러한 변화는 업계의 더 넓은 트렌드를 반영합니다: 우리는 독립형 SaaS 애플리케이션에서 여러 도구와 워크플로우를 관리할 수 있는 AI 에이전트로 이동하고 있습니다. 비즈니스가 복잡한 다단계 작업을 처리하기 위해 AI에 점점 더 의존함에 따라, GAIA와 같은 벤치마크는 전통적인 다지선다 테스트보다 더 적절한 능력 측정 기준을 제공합니다.
AI 평가의 미래는 고립된 지식 테스트에 관한 것이 아니라, 문제 해결 능력에 대한 포괄적인 평가에 관한 것입니다. GAIA는 AI 능력을 측정하는 새로운 벤치마크를 설정하며, 이는 AI 배포의 실세계 도전과 기회에 더 잘 맞는 기준입니다.
Sri Ambati는 H2O.ai의 창립자이자 CEO입니다.
관련 기사
 인공지능이 뉴스 콘텐츠 속 숨겨진 의도를 밝혀내다
ChatGPT 스타일 모델들은 이제 뉴스 기사의 근본적인 관점을 밝혀내기 위해 훈련되고 있다. 심지어 그 관점이 인용문, 프레임, 또는 (때로는 진정성 없는) 중립성의 외관 아래 숨겨져 있을 때조차도 말이다. 기사를 헤드라인, 리드문, 인용문 등의 단편으로 분할함으로써, 새로운 시스템은 장문의 전문 저널리즘에서도 편향을 식별하는 법을 학습한다. 학술 문헌에
Anthropic의 Claude 4.1, GPT-5 출시 앞두고 코딩 벤치마크에서 우수한 성능 발휘
앤트로픽은 월요일 자사 주력 AI 모델의 향상된 버전을 공개하며 소프트웨어 엔지니어링 작업 수행 능력에 새로운 기준을 제시했다. 이번 출시로 이 AI 스타트업은 수익성이 높은 코딩 분야에서의 우위를 지키고, 오픈AI로부터 예상되는 새로운 경쟁에 대비할 수 있게 됐다.신규 '클로드 오푸스 4.1(Claude Opus 4.1)' 모델은 실제 소프트웨어 문제를
엔비디아, 토글 가능한 추론 기능을 갖춘 오픈 소스 AI 모델 네모트론-나노-9B-v2 공개
소형 언어 모델이 주목받고 있다. MIT 스핀오프 기업 리퀴드 AI의 스마트워치 크기 비전 모델과 구글의 스마트폰용 모델에 이어, 엔비디아도 자체 경량화 모델인 네모트론-나노-9B-V2로 시장에 진출한다. 이 신형 모델은 주요 벤치마크에서 동급 최상위를 기록하며, 사용자가 AI의 '추론' 기능(최종 답변 제공 전 자체 점검 과정)을 활성화
관련 특별 주제 추천
음악 작곡
 리믹스 제작, 샘플링 준비, 카라오케 마스터 파일 제작을 위한 AI 스템 분리 도구
2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
 8 도구
 xix.ai
데이터 분석
수익 대시보드, 퍼널 분석, 그리고 제품 지표를 위한 AI SQL 코파일럿
2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai
음악 작곡
노래 초안을 위한 최고의 AI 멜로디 작곡 도구
2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai
챗봇
면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai
만화 창작
시각적 스토리텔링을 위한 최고의 AI 대화 풍선 도구
2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

 의견 (4)
0/500
![SamuelRamirez]()
Interesting benchmark! But I wonder if focusing too much on benchmarks might lead to AI that's just good at passing tests, not truly understanding the world. Reminds me of students who ace exams but struggle with real-life problems. 🤔
![ThomasLewis]()
このGAIAベンチマークは確かに面白いですね。AIの知性を測る方法はもっと多様なはず。人間だってテストだけでは測れないんだから、AIにも同様に自分たちの理解できる尺度が適しているのかな?実は市場競争ばかり意識すると、基準が歪んでしまうんじゃないかと心配😅
![BillyAdams]()
This GAIA benchmark sounds intriguing! Makes me wonder if we’re finally getting closer to measuring true intelligence or just chasing fancier numbers. 🤔 What’s next, AI acing philosophy exams?
![GaryThomas]()
This GAIA benchmark sounds intriguing! 🤔 It’s like trying to measure a rainbow with a ruler—cool concept, but can it really capture true intelligence? I wonder how it compares to ARC-AGI in practical applications.
지능은 어디에나 존재하지만, 그것을 정확히 측정하는 것은 맨손으로 구름을 잡으려는 것처럼 느껴집니다. 우리는 대학 입시와 같은 테스트와 벤치마크를 사용해 대략적인 아이디어를 얻습니다. 매년 학생들은 이러한 테스트를 위해 벼락치기를 하고, 때로는 100% 완벽한 점수를 받기도 합니다. 하지만 그 완벽한 점수가 그들이 모두 같은 수준의 지능을 가지고 있거나, 그들의 정신적 잠재력의 정점에 도달했음을 의미할까요? 물론 아닙니다. 이러한 벤치마크는 대략적인 추정치일 뿐, 누군가의 진정한 능력을 정확히 나타내는 지표는 아닙니다.
생성 AI의 세계에서는 MMLU(Massive Multitask Language Understanding)와 같은 벤치마크가 다양한 학문 분야에 걸친 다지선다 질문을 통해 모델을 평가하는 데 주로 사용되었습니다. 이는 쉬운 비교를 가능하게 하지만, 지능적 능력의 전체 스펙트럼을 완전히 포착하지는 못합니다.
예를 들어, Claude 3.5 Sonnet과 GPT-4.5를 살펴보면, 그들은 MMLU에서 비슷한 점수를 받을 수 있어 비슷한 수준으로 보일 수 있습니다. 하지만 이 모델들을 실제로 사용해본 사람은 그들의 실세계 성능이 상당히 다를 수 있다는 것을 압니다.
AI에서 '지능'을 측정한다는 것은 무엇을 의미할까?
최근 ARC-AGI 벤치마크가 출시되면서, 일반적 추론과 창의적 문제 해결을 테스트하기 위해 설계된 이 벤치마크는 AI에서 "지능"을 측정하는 것이 무엇을 의미하는지에 대한 새로운 논의를 불러일으켰습니다. 아직 모두가 ARC-AGI를 깊이 탐구할 기회는 없었지만, 업계는 이와 다른 새로운 테스트 접근법에 대해 떠들썩합니다. 모든 벤치마크는 제자리를 가지고 있으며, ARC-AGI는 올바른 방향으로 나아가는 한 걸음입니다.
또 다른 흥미로운 발전은 3,000개의 동료 검토를 거친 다단계 질문으로 구성된 포괄적인 벤치마크인 'Humanity's Last Exam'입니다. 이는 AI 시스템을 전문가 수준의 추론으로 밀어붙이려는 야심찬 노력입니다. 초기 결과는 빠른 진전을 보여주며, OpenAI는 출시 한 달 만에 26.6%의 점수를 기록했다고 전해집니다. 하지만 다른 벤치마크와 마찬가지로, 이는 주로 지식과 추론에 초점을 맞추며, 실세계 AI 응용에 필수적인 실용적이고 도구를 사용하는 기술에는 집중하지 않습니다.
예를 들어, 일부 최고 모델들이 "strawberry"에서 "r"의 개수를 세는 것과 같은 간단한 작업이나 3.8과 3.1111을 비교하는 데 어려움을 겪는 경우를 생각해보세요. 이러한 오류는 어린이나 기본 계산기조차 피할 수 있는 것인데, 이는 벤치마크 성공과 실세계 신뢰성 사이의 간극을 보여줍니다. 이는 지능이 단순히 테스트를 잘 치는 것뿐만 아니라, 일상적인 논리를 쉽게 탐색하는 것에 관한 것임을 상기시킵니다.
AI 능력 측정을 위한 새로운 표준
AI 모델이 발전함에 따라 전통적인 벤치마크의 한계가 더욱 명확해졌습니다. 예를 들어, GPT-4는 도구를 사용할 때 GAIA 벤치마크의 더 복잡한 실세계 작업에서 약 15%의 점수만을 기록하며, 다지선다 테스트에서의 높은 점수에도 불구하고 한계를 드러냅니다.
벤치마크 성능과 실제 능력 간의 이러한 불일치는 AI 시스템이 연구실에서 비즈니스 응용으로 전환됨에 따라 점점 더 문제가 됩니다. 전통적인 벤치마크는 모델이 정보를 얼마나 잘 회상하는지를 테스트하지만, 데이터를 수집하고, 코드를 실행하고, 정보를 분석하고, 다양한 도메인에서 솔루션을 만드는 등의 핵심 지능 요소는 종종 간과됩니다.
GAIA는 AI 평가에 있어 중대한 변화를 가져오는 새로운 벤치마크입니다. Meta-FAIR, Meta-GenAI, HuggingFace, AutoGPT 팀의 협력을 통해 개발된 GAIA는 466개의 세심하게 제작된 질문을 세 가지 난이도 수준으로 포함합니다. 이러한 질문들은 웹 브라우징, 다중 모달 이해, 코드 실행, 파일 처리, 복잡한 추론 등 실세계 AI 응용에 필수적인 다양한 기술을 테스트합니다.
레벨 1 질문은 일반적으로 인간이 해결하는 데 약 5단계와 하나의 도구를 필요로 합니다. 레벨 2 질문은 5~10단계와 여러 도구를 요구하며, 레벨 3 질문은 최대 50단계와 다양한 도구를 요구할 수 있습니다. 이 구조는 실제 비즈니스 문제의 복잡성을 반영하며, 솔루션은 종종 여러 행동과 도구를 포함합니다.
복잡성뿐만 아니라 유연성에 초점을 맞춤으로써, 한 AI 모델은 GAIA에서 75%의 정확도를 달성하며 Microsoft의 Magnetic-1(38%)과 Google의 Langfun Agent(49%)와 같은 업계 리더를 능가했습니다. 이 성공은 오디오-비주얼 이해와 추론을 위한 특화된 모델을 혼합하고, Anthropic의 Sonnet 3.5를 메인 모델로 사용한 결과입니다.
AI 평가의 이러한 변화는 업계의 더 넓은 트렌드를 반영합니다: 우리는 독립형 SaaS 애플리케이션에서 여러 도구와 워크플로우를 관리할 수 있는 AI 에이전트로 이동하고 있습니다. 비즈니스가 복잡한 다단계 작업을 처리하기 위해 AI에 점점 더 의존함에 따라, GAIA와 같은 벤치마크는 전통적인 다지선다 테스트보다 더 적절한 능력 측정 기준을 제공합니다.
AI 평가의 미래는 고립된 지식 테스트에 관한 것이 아니라, 문제 해결 능력에 대한 포괄적인 평가에 관한 것입니다. GAIA는 AI 능력을 측정하는 새로운 벤치마크를 설정하며, 이는 AI 배포의 실세계 도전과 기회에 더 잘 맞는 기준입니다.
Sri Ambati는 H2O.ai의 창립자이자 CEO입니다.








 인공지능이 뉴스 콘텐츠 속 숨겨진 의도를 밝혀내다
ChatGPT 스타일 모델들은 이제 뉴스 기사의 근본적인 관점을 밝혀내기 위해 훈련되고 있다. 심지어 그 관점이 인용문, 프레임, 또는 (때로는 진정성 없는) 중립성의 외관 아래 숨겨져 있을 때조차도 말이다. 기사를 헤드라인, 리드문, 인용문 등의 단편으로 분할함으로써, 새로운 시스템은 장문의 전문 저널리즘에서도 편향을 식별하는 법을 학습한다. 학술 문헌에
 Anthropic의 Claude 4.1, GPT-5 출시 앞두고 코딩 벤치마크에서 우수한 성능 발휘
앤트로픽은 월요일 자사 주력 AI 모델의 향상된 버전을 공개하며 소프트웨어 엔지니어링 작업 수행 능력에 새로운 기준을 제시했다. 이번 출시로 이 AI 스타트업은 수익성이 높은 코딩 분야에서의 우위를 지키고, 오픈AI로부터 예상되는 새로운 경쟁에 대비할 수 있게 됐다.신규 '클로드 오푸스 4.1(Claude Opus 4.1)' 모델은 실제 소프트웨어 문제를
 엔비디아, 토글 가능한 추론 기능을 갖춘 오픈 소스 AI 모델 네모트론-나노-9B-v2 공개
소형 언어 모델이 주목받고 있다. MIT 스핀오프 기업 리퀴드 AI의 스마트워치 크기 비전 모델과 구글의 스마트폰용 모델에 이어, 엔비디아도 자체 경량화 모델인 네모트론-나노-9B-V2로 시장에 진출한다. 이 신형 모델은 주요 벤치마크에서 동급 최상위를 기록하며, 사용자가 AI의 '추론' 기능(최종 답변 제공 전 자체 점검 과정)을 활성화

2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
8 도구
xix.ai

2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai

2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

Interesting benchmark! But I wonder if focusing too much on benchmarks might lead to AI that's just good at passing tests, not truly understanding the world. Reminds me of students who ace exams but struggle with real-life problems. 🤔
このGAIAベンチマークは確かに面白いですね。AIの知性を測る方法はもっと多様なはず。人間だってテストだけでは測れないんだから、AIにも同様に自分たちの理解できる尺度が適しているのかな?実は市場競争ばかり意識すると、基準が歪んでしまうんじゃないかと心配😅
This GAIA benchmark sounds intriguing! Makes me wonder if we’re finally getting closer to measuring true intelligence or just chasing fancier numbers. 🤔 What’s next, AI acing philosophy exams?
This GAIA benchmark sounds intriguing! 🤔 It’s like trying to measure a rainbow with a ruler—cool concept, but can it really capture true intelligence? I wonder how it compares to ARC-AGI in practical applications.












