


 Heim
Gaia führt einen neuen Benchmark in der Suche nach wahrer Intelligenz jenseits von Arc-Agi ein
Intelligenz ist überall, doch sie präzise zu messen, fühlt sich an, als wolle man mit bloßen Händen eine Wolke fangen. Wir verwenden Tests und Benchmarks, wie Hochschulaufnahmeprüfungen, um eine grobe Vorstellung zu bekommen. Jedes Jahr lernen Schüler intensiv für diese Tests und erzielen manchmal sogar perfekte 100 %. Aber bedeutet dieser perfekte Score, dass sie alle das gleiche Intelligenzniveau haben oder ihr geistiges Potenzial vollständig ausgeschöpft haben? Natürlich nicht. Diese Benchmarks sind nur grobe Schätzungen, keine präzisen Indikatoren für die wahren Fähigkeiten einer Person.
In der Welt der generativen KI sind Benchmarks wie MMLU (Massive Multitask Language Understanding) die Standardmethode, um Modelle durch Multiple-Choice-Fragen in verschiedenen akademischen Bereichen zu bewerten. Sie ermöglichen einfache Vergleiche, erfassen jedoch nicht das volle Spektrum intelligenter Fähigkeiten.
Nehmen wir zum Beispiel Claude 3.5 Sonnet und GPT-4.5. Sie könnten bei MMLU ähnliche Werte erzielen, was nahelegt, dass sie gleichwertig sind. Doch jeder, der diese Modelle tatsächlich genutzt hat, weiß, dass ihre Leistung in der realen Welt ganz unterschiedlich sein kann.
Was bedeutet es, "Intelligenz" in KI zu messen?
Mit der kürzlichen Einführung des ARC-AGI-Benchmarks, der darauf ausgelegt ist, Modelle in allgemeinem Denken und kreativer Problemlösung zu testen, gibt es eine neue Welle der Diskussion darüber, was es bedeutet, "Intelligenz" in KI zu messen. Noch nicht jeder hatte die Gelegenheit, ARC-AGI auszuprobieren, aber die Branche spricht lebhaft über diesen und andere neue Testansätze. Jeder Benchmark hat seinen Platz, und ARC-AGI ist ein Schritt in die richtige Richtung.
Eine weitere spannende Entwicklung ist "Humanity's Last Exam", ein umfassender Benchmark mit 3.000 von Experten begutachteten, mehrstufigen Fragen aus verschiedenen Disziplinen. Es ist ein ambitionierter Versuch, KI-Systeme zu expertenniveauartigem Denken zu pushen. Erste Ergebnisse zeigen schnelle Fortschritte, wobei OpenAI angeblich einen Monat nach Veröffentlichung 26,6 % erreicht hat. Doch wie andere Benchmarks konzentriert er sich hauptsächlich auf Wissen und Denken im Vakuum, nicht auf praktische, werkzeugbasierte Fähigkeiten, die für reale KI-Anwendungen entscheidend sind.
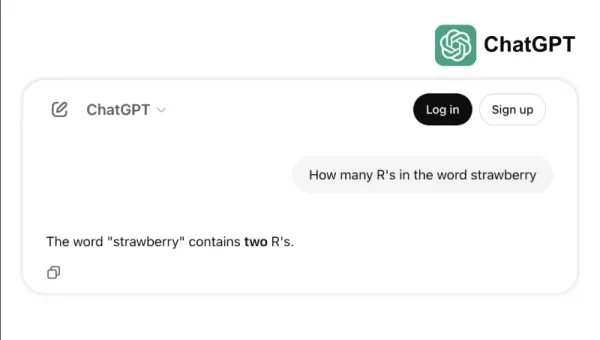
Nehmen wir zum Beispiel, wie einige Top-Modelle bei einfachen Aufgaben wie dem Zählen der "r"s in "strawberry" oder dem Vergleich von 3,8 zu 3,1111 scheitern. Diese Fehler, die selbst ein Kind oder ein einfacher Taschenrechner vermeiden könnte, verdeutlichen die Kluft zwischen Benchmark-Erfolg und realer Zuverlässigkeit. Es erinnert daran, dass Intelligenz nicht nur darin besteht, Tests zu bestehen, sondern alltägliche Logik mühelos zu meistern.
Der neue Standard zur Messung von KI-Fähigkeiten
Mit der Weiterentwicklung von KI-Modellen sind die Grenzen traditioneller Benchmarks immer offensichtlicher geworden. Zum Beispiel erreicht GPT-4, wenn es mit Werkzeugen ausgestattet ist, nur etwa 15 % bei komplexeren, realen Aufgaben im GAIA-Benchmark, trotz hoher Punktzahlen bei Multiple-Choice-Tests.
Diese Diskrepanz zwischen Benchmark-Leistung und praktischer Fähigkeit wird zunehmend problematisch, da KI-Systeme von Forschungslaboren zu Geschäftsanwendungen übergehen. Traditionelle Benchmarks testen, wie gut ein Modell Informationen abrufen kann, übersehen jedoch oft Schlüsselaspekte der Intelligenz, wie die Fähigkeit, Daten zu sammeln, Code auszuführen, Informationen zu analysieren und Lösungen in verschiedenen Bereichen zu entwickeln.
Hier kommt GAIA ins Spiel, ein neuer Benchmark, der einen bedeutenden Wandel in der KI-Bewertung markiert. Entwickelt durch eine Zusammenarbeit von Teams aus Meta-FAIR, Meta-GenAI, HuggingFace und AutoGPT, umfasst GAIA 466 sorgfältig gestaltete Fragen auf drei Schwierigkeitsstufen. Diese Fragen testen eine Vielzahl von Fähigkeiten, die für reale KI-Anwendungen entscheidend sind, einschließlich Webbrowsing, multimodalem Verständnis, Codeausführung, Dateihandling und komplexem Denken.
Fragen der Stufe 1 erfordern typischerweise etwa 5 Schritte und ein Werkzeug, um von Menschen gelöst zu werden. Fragen der Stufe 2 benötigen 5 bis 10 Schritte und mehrere Werkzeuge, während Fragen der Stufe 3 bis zu 50 Schritte und beliebig viele Werkzeuge verlangen können. Diese Struktur spiegelt die Komplexität realer Geschäftsprobleme wider, bei denen Lösungen oft mehrere Aktionen und Werkzeuge umfassen.
Indem ein KI-Modell mit Fokus auf Flexibilität statt nur Komplexität eine Genauigkeitsrate von 75 % auf GAIA erreichte, übertraf es Branchenführer wie Microsofts Magnetic-1 (38 %) und Googles Langfun Agent (49 %). Dieser Erfolg resultiert aus der Nutzung einer Mischung aus spezialisierten Modellen für audiovisuelles Verständnis und Denken, mit Anthropics Sonnet 3.5 als Hauptmodell.
Dieser Wandel in der KI-Bewertung spiegelt einen breiteren Trend in der Branche wider: Wir bewegen uns weg von eigenständigen SaaS-Anwendungen hin zu KI-Agenten, die mehrere Werkzeuge und Arbeitsabläufe verwalten können. Da Unternehmen zunehmend auf KI angewiesen sind, um komplexe, mehrstufige Aufgaben zu bewältigen, bieten Benchmarks wie GAIA eine relevantere Messgröße für Fähigkeiten als traditionelle Multiple-Choice-Tests.
Die Zukunft der KI-Bewertung dreht sich nicht um isolierte Wissenstests; es geht um umfassende Bewertungen der Problemlösungsfähigkeit. GAIA setzt einen neuen Maßstab für die Messung von KI-Fähigkeiten – einen, der besser mit den realen Herausforderungen und Möglichkeiten der KI-Einführung übereinstimmt.
Sri Ambati ist der Gründer und CEO von H2O.ai.
Verwandter Artikel
 KI deckt versteckte Absichten in Nachrichteninhalten auf
Modelle im Stil von ChatGPT werden derzeit darauf trainiert, die zugrunde liegende Perspektive eines Nachrichtenartikels aufzudecken – selbst wenn diese Sichtweise hinter Zitaten, Framing oder einer F
Anthropics Claude 4.1 übertrifft GPT-5 bei Coding-Benchmarks vor dessen Markteinführung
Anthropic hat am Montag eine verbesserte Version seines führenden KI-Modells vorgestellt und damit einen neuen Maßstab für die Leistung bei Softwareentwicklungsaufgaben gesetzt. Mit dieser Einführung
Nvidia stellt Open-Source-KI-Modell Nemotron-Nano-9B-v2 mit umschaltbarem Denkvermögen vor
Kleine Sprachmodelle sorgen für Aufsehen. Nach der Vorstellung des Smartwatch-großen Bildverarbeitungsmodells von Liquid AI, einem Spin-off des MIT, und des Smartphone-fähigen Modells von Google betri
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (4)
![SamuelRamirez]()
Interesting benchmark! But I wonder if focusing too much on benchmarks might lead to AI that's just good at passing tests, not truly understanding the world. Reminds me of students who ace exams but struggle with real-life problems. 🤔
![ThomasLewis]()
このGAIAベンチマークは確かに面白いですね。AIの知性を測る方法はもっと多様なはず。人間だってテストだけでは測れないんだから、AIにも同様に自分たちの理解できる尺度が適しているのかな?実は市場競争ばかり意識すると、基準が歪んでしまうんじゃないかと心配😅
![BillyAdams]()
This GAIA benchmark sounds intriguing! Makes me wonder if we’re finally getting closer to measuring true intelligence or just chasing fancier numbers. 🤔 What’s next, AI acing philosophy exams?
![GaryThomas]()
This GAIA benchmark sounds intriguing! 🤔 It’s like trying to measure a rainbow with a ruler—cool concept, but can it really capture true intelligence? I wonder how it compares to ARC-AGI in practical applications.
Intelligenz ist überall, doch sie präzise zu messen, fühlt sich an, als wolle man mit bloßen Händen eine Wolke fangen. Wir verwenden Tests und Benchmarks, wie Hochschulaufnahmeprüfungen, um eine grobe Vorstellung zu bekommen. Jedes Jahr lernen Schüler intensiv für diese Tests und erzielen manchmal sogar perfekte 100 %. Aber bedeutet dieser perfekte Score, dass sie alle das gleiche Intelligenzniveau haben oder ihr geistiges Potenzial vollständig ausgeschöpft haben? Natürlich nicht. Diese Benchmarks sind nur grobe Schätzungen, keine präzisen Indikatoren für die wahren Fähigkeiten einer Person.
In der Welt der generativen KI sind Benchmarks wie MMLU (Massive Multitask Language Understanding) die Standardmethode, um Modelle durch Multiple-Choice-Fragen in verschiedenen akademischen Bereichen zu bewerten. Sie ermöglichen einfache Vergleiche, erfassen jedoch nicht das volle Spektrum intelligenter Fähigkeiten.
Nehmen wir zum Beispiel Claude 3.5 Sonnet und GPT-4.5. Sie könnten bei MMLU ähnliche Werte erzielen, was nahelegt, dass sie gleichwertig sind. Doch jeder, der diese Modelle tatsächlich genutzt hat, weiß, dass ihre Leistung in der realen Welt ganz unterschiedlich sein kann.
Was bedeutet es, "Intelligenz" in KI zu messen?
Mit der kürzlichen Einführung des ARC-AGI-Benchmarks, der darauf ausgelegt ist, Modelle in allgemeinem Denken und kreativer Problemlösung zu testen, gibt es eine neue Welle der Diskussion darüber, was es bedeutet, "Intelligenz" in KI zu messen. Noch nicht jeder hatte die Gelegenheit, ARC-AGI auszuprobieren, aber die Branche spricht lebhaft über diesen und andere neue Testansätze. Jeder Benchmark hat seinen Platz, und ARC-AGI ist ein Schritt in die richtige Richtung.
Eine weitere spannende Entwicklung ist "Humanity's Last Exam", ein umfassender Benchmark mit 3.000 von Experten begutachteten, mehrstufigen Fragen aus verschiedenen Disziplinen. Es ist ein ambitionierter Versuch, KI-Systeme zu expertenniveauartigem Denken zu pushen. Erste Ergebnisse zeigen schnelle Fortschritte, wobei OpenAI angeblich einen Monat nach Veröffentlichung 26,6 % erreicht hat. Doch wie andere Benchmarks konzentriert er sich hauptsächlich auf Wissen und Denken im Vakuum, nicht auf praktische, werkzeugbasierte Fähigkeiten, die für reale KI-Anwendungen entscheidend sind.
Nehmen wir zum Beispiel, wie einige Top-Modelle bei einfachen Aufgaben wie dem Zählen der "r"s in "strawberry" oder dem Vergleich von 3,8 zu 3,1111 scheitern. Diese Fehler, die selbst ein Kind oder ein einfacher Taschenrechner vermeiden könnte, verdeutlichen die Kluft zwischen Benchmark-Erfolg und realer Zuverlässigkeit. Es erinnert daran, dass Intelligenz nicht nur darin besteht, Tests zu bestehen, sondern alltägliche Logik mühelos zu meistern.
Der neue Standard zur Messung von KI-Fähigkeiten
Mit der Weiterentwicklung von KI-Modellen sind die Grenzen traditioneller Benchmarks immer offensichtlicher geworden. Zum Beispiel erreicht GPT-4, wenn es mit Werkzeugen ausgestattet ist, nur etwa 15 % bei komplexeren, realen Aufgaben im GAIA-Benchmark, trotz hoher Punktzahlen bei Multiple-Choice-Tests.
Diese Diskrepanz zwischen Benchmark-Leistung und praktischer Fähigkeit wird zunehmend problematisch, da KI-Systeme von Forschungslaboren zu Geschäftsanwendungen übergehen. Traditionelle Benchmarks testen, wie gut ein Modell Informationen abrufen kann, übersehen jedoch oft Schlüsselaspekte der Intelligenz, wie die Fähigkeit, Daten zu sammeln, Code auszuführen, Informationen zu analysieren und Lösungen in verschiedenen Bereichen zu entwickeln.
Hier kommt GAIA ins Spiel, ein neuer Benchmark, der einen bedeutenden Wandel in der KI-Bewertung markiert. Entwickelt durch eine Zusammenarbeit von Teams aus Meta-FAIR, Meta-GenAI, HuggingFace und AutoGPT, umfasst GAIA 466 sorgfältig gestaltete Fragen auf drei Schwierigkeitsstufen. Diese Fragen testen eine Vielzahl von Fähigkeiten, die für reale KI-Anwendungen entscheidend sind, einschließlich Webbrowsing, multimodalem Verständnis, Codeausführung, Dateihandling und komplexem Denken.
Fragen der Stufe 1 erfordern typischerweise etwa 5 Schritte und ein Werkzeug, um von Menschen gelöst zu werden. Fragen der Stufe 2 benötigen 5 bis 10 Schritte und mehrere Werkzeuge, während Fragen der Stufe 3 bis zu 50 Schritte und beliebig viele Werkzeuge verlangen können. Diese Struktur spiegelt die Komplexität realer Geschäftsprobleme wider, bei denen Lösungen oft mehrere Aktionen und Werkzeuge umfassen.
Indem ein KI-Modell mit Fokus auf Flexibilität statt nur Komplexität eine Genauigkeitsrate von 75 % auf GAIA erreichte, übertraf es Branchenführer wie Microsofts Magnetic-1 (38 %) und Googles Langfun Agent (49 %). Dieser Erfolg resultiert aus der Nutzung einer Mischung aus spezialisierten Modellen für audiovisuelles Verständnis und Denken, mit Anthropics Sonnet 3.5 als Hauptmodell.
Dieser Wandel in der KI-Bewertung spiegelt einen breiteren Trend in der Branche wider: Wir bewegen uns weg von eigenständigen SaaS-Anwendungen hin zu KI-Agenten, die mehrere Werkzeuge und Arbeitsabläufe verwalten können. Da Unternehmen zunehmend auf KI angewiesen sind, um komplexe, mehrstufige Aufgaben zu bewältigen, bieten Benchmarks wie GAIA eine relevantere Messgröße für Fähigkeiten als traditionelle Multiple-Choice-Tests.
Die Zukunft der KI-Bewertung dreht sich nicht um isolierte Wissenstests; es geht um umfassende Bewertungen der Problemlösungsfähigkeit. GAIA setzt einen neuen Maßstab für die Messung von KI-Fähigkeiten – einen, der besser mit den realen Herausforderungen und Möglichkeiten der KI-Einführung übereinstimmt.
Sri Ambati ist der Gründer und CEO von H2O.ai.








 KI deckt versteckte Absichten in Nachrichteninhalten auf
Modelle im Stil von ChatGPT werden derzeit darauf trainiert, die zugrunde liegende Perspektive eines Nachrichtenartikels aufzudecken – selbst wenn diese Sichtweise hinter Zitaten, Framing oder einer F
 Anthropics Claude 4.1 übertrifft GPT-5 bei Coding-Benchmarks vor dessen Markteinführung
Anthropic hat am Montag eine verbesserte Version seines führenden KI-Modells vorgestellt und damit einen neuen Maßstab für die Leistung bei Softwareentwicklungsaufgaben gesetzt. Mit dieser Einführung
 Nvidia stellt Open-Source-KI-Modell Nemotron-Nano-9B-v2 mit umschaltbarem Denkvermögen vor
Kleine Sprachmodelle sorgen für Aufsehen. Nach der Vorstellung des Smartwatch-großen Bildverarbeitungsmodells von Liquid AI, einem Spin-off des MIT, und des Smartphone-fähigen Modells von Google betri

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

Interesting benchmark! But I wonder if focusing too much on benchmarks might lead to AI that's just good at passing tests, not truly understanding the world. Reminds me of students who ace exams but struggle with real-life problems. 🤔
このGAIAベンチマークは確かに面白いですね。AIの知性を測る方法はもっと多様なはず。人間だってテストだけでは測れないんだから、AIにも同様に自分たちの理解できる尺度が適しているのかな?実は市場競争ばかり意識すると、基準が歪んでしまうんじゃないかと心配😅
This GAIA benchmark sounds intriguing! Makes me wonder if we’re finally getting closer to measuring true intelligence or just chasing fancier numbers. 🤔 What’s next, AI acing philosophy exams?
This GAIA benchmark sounds intriguing! 🤔 It’s like trying to measure a rainbow with a ruler—cool concept, but can it really capture true intelligence? I wonder how it compares to ARC-AGI in practical applications.












