


 首页
Meta揭开了长篇小说侦察兵和特立独行的模型,2T参数庞然大物即将推出!
2025年1月,人工智能界掀起波澜,一家鲜为人知的中国特色人工智能初创公司DeepSeek推出了其开创性的开源语言推理模型DeepSeek R1。该模型不仅性能超越了Meta等公司,而且成本仅为传闻中的几百万美元。相比之下,Meta可能仅在几位人工智能团队领导者身上就花费了这么多!这一消息让Meta有些慌乱,尤其是因为他们上个月刚发布的最新Llama模型3.3版已经显得有些过时。
快进到今天,Meta的创始人兼首席执行官马克·扎克伯格在Instagram上宣布推出新的Llama 4系列。该系列包括4000亿参数的Llama 4 Maverick和1090亿参数的Llama 4 Scout,开发者可立即在llama.com和Hugging Face上下载并开始使用。此外,还有一个正在训练中的庞大2万亿参数模型Llama 4 Behemoth的预览,尚未确定发布日期。
多模态和长上下文能力
这些新模型的突出特点是其多模态特性。它们不仅限于文本,还能处理视频和图像。它们的上下文窗口极长——Maverick为100万令牌,Scout更是高达1000万令牌。换句话说,这相当于一次性处理1500页和15000页的文本!想象一下,这对医学、科学或文学等领域处理和生成大量信息的可能性。
专家混合架构
所有三个Llama 4模型都采用了“专家混合(MoE)”架构,这种技术由OpenAI和Mistral等公司推广,备受关注。该方法将多个较小的专业模型组合成一个更大、更高效的模型。每个Llama 4模型由128个不同的专家组成,这意味着每个令牌仅由必要的专家和一个共享专家处理,使模型更具成本效益且运行更快。Meta宣称Llama 4 Maverick可在单个Nvidia H100 DGX主机上运行,部署非常简便。
成本效益和可访问性
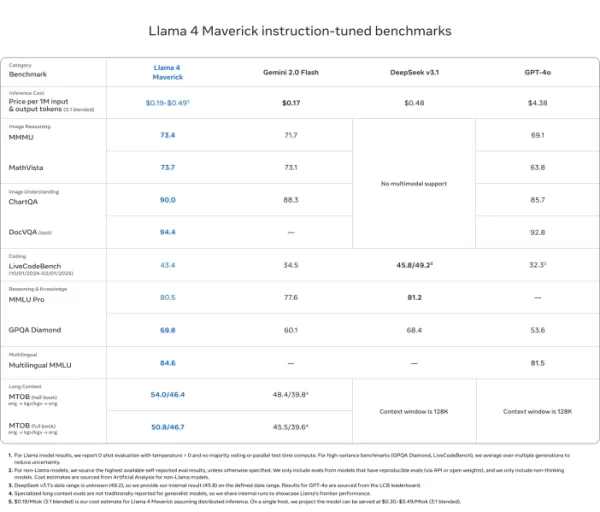
Meta致力于让这些模型易于获取。Scout和Maverick均可用于自托管,他们甚至分享了一些诱人的成本估算。例如,Llama 4 Maverick的推理成本在每百万令牌0.19美元至0.49美元之间,相比其他专有模型如GPT-4o,这非常划算。如果您有兴趣通过云提供商使用这些模型,Groq已经提供了具有竞争力的定价。
增强推理和MetaP
这些模型专为推理、编码和问题解决而设计。Meta在训练中采用了一些巧妙技术来提升这些能力,例如移除简单提示并使用持续强化学习,逐步增加提示难度。他们还引入了MetaP,一种新技术,允许在一个模型上设置超参数并将其应用于其他模型,从而节省时间和成本。这对训练像Behemoth这样使用32K GPU并处理超过30万亿令牌的巨型模型尤为重要。
性能与比较
那么,这些模型表现如何?扎克伯格明确表示,他希望开源人工智能引领潮流,Llama 4是朝着这个方向迈出的一大步。虽然它们可能不会在所有方面都创下新的性能记录,但无疑名列前茅。例如,Llama 4 Behemoth在某些基准测试中超越了一些重量级选手,尽管在其他方面仍需追赶DeepSeek R1和OpenAI的o1系列。
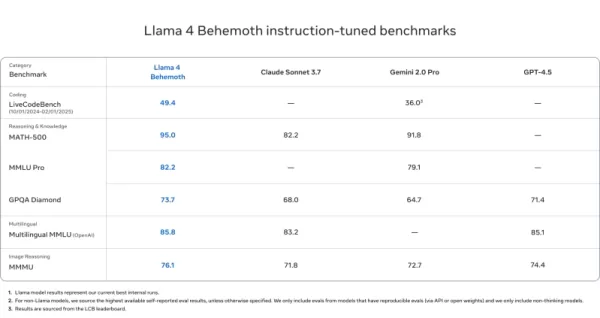
Llama 4 Behemoth
- 在MATH-500(95.0)、GPQA Diamond(73.7)和MMLU Pro(82.2)上超越GPT-4.5、Gemini 2.0 Pro和Claude Sonnet 3.7
Llama 4 Maverick
- 在ChartQA、DocVQA、MathVista和MMMU等大多数多模态推理基准测试中击败GPT-4o和Gemini 2.0 Flash
- 与DeepSeek v3.1竞争,同时使用的活跃参数不到其一半
- 基准测试得分:ChartQA(90.0)、DocVQA(94.4)、MMLU Pro(80.5)
Llama 4 Scout
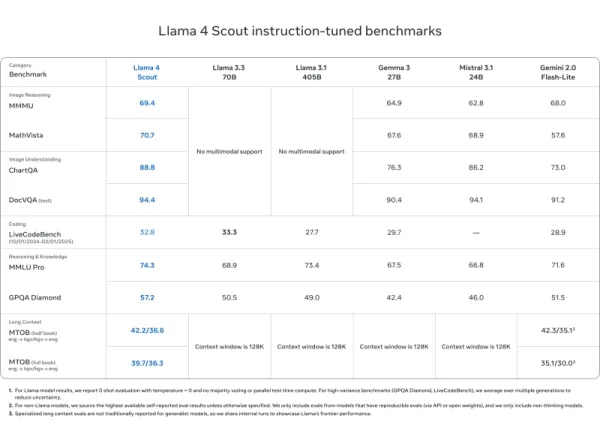
- 在DocVQA(94.4)、MMLU Pro(74.3)和MathVista(70.7)上匹配或超越Mistral 3.1、Gemini 2.0 Flash-Lite和Gemma 3等模型
- 无与伦比的1000万令牌上下文长度——非常适合长文档和代码库
与DeepSeek R1的比较
在顶级竞争中,Llama 4 Behemoth表现出色,但尚未完全超越DeepSeek R1或OpenAI的o1系列。它在MATH-500和MMLU上略逊一筹,但在GPQA Diamond上领先。即便如此,Llama 4显然是推理领域的强劲竞争者。
基准测试 Llama 4 Behemoth DeepSeek R1 OpenAI o1-1217 MATH-500 95.0 97.3 96.4 GPQA Diamond 73.7 71.5 75.7 MMLU 82.2 90.8 91.8
安全性和政治中立性
Meta也没有忽视安全性。他们推出了Llama Guard、Prompt Guard和CyberSecEval等工具以确保安全。他们还强调减少政治偏见,致力于更平衡的方法,特别是在扎克伯格在2024年选举后表示支持共和党政治之后。
Llama 4的未来
通过Llama 4,Meta正在推动人工智能的效率、开放性和性能的边界。无论您是想构建企业级人工智能助手还是深入研究人工智能,Llama 4都提供了强大而灵活的选择,优先考虑推理能力。显然,Meta致力于让人工智能对每个人更易获取且更具影响力。
相关文章
 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
马克·扎克伯格真的相信人工智能是面向每个人的吗?
正在加载播放器…Meta 本周推出了 Glimmer,这是一个开源权重的 AI 模型,任何人都可以下载并在个人硬件上运行——这与该公司更强大的模型 Muse Spark 形成了鲜明对比,后者仍锁定在其自有 API 之后。此次发布伴随着马克·扎克伯格(Mark Zuckerberg)的一封公开信,他在信中主张人工智能应向所有人开放,而非由少数几家实验室控制。但正如 Equity 节目主持人所指出的那样,这一愿景附带了几个重要的限制条件。在本期 TechCrunch 的 Equity 播客中,K
相关专题推荐
视频创作
 适用于 Reels、Shorts 及产品发布活动的 AI 短视频吸睛点生成器
2026年最新最全的AI短视频开场白生成器,适用于Reels、Shorts及产品发布活动!XIX.AI精选了经过实际测试、效果惊人且必试的顶级工具,这些工具将彻底改变游戏规则。本页面每周更新,提供免费与付费版本的对比排名,助您找到提升内容创意和生产力的完美解决方案。 立即探索,释放您的AI优势!
 11 个工具
 xix.ai
写作
适用于长篇写作的AI文章大纲工具
2026年最新最佳、评分最高的人工智能文章大纲工具,专为长文写作打造!这份精心挑选的合集收录了功能强大、具有革命性意义的工具,它们能生成准确、结构清晰的大纲,并经过实际测试验证,可显著提升写作效率。XIX.AI 便是这份精英精选中的成员之一。 获取免费版与付费版的对比指南,助您选择最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
聊天机器人
用于语言练习、面试准备和日常流利度的最佳 AI 角色扮演聊天应用
2026 年最新最佳顶级评分 AI 角色扮演聊天应用,用于语言练习、面试准备和日常流利度!XIX.AI 精心策划了一个强大的变革性合集,提供免费与付费对比、真实世界测试以及每周更新的排名。这些必试工具可帮助您提升写作技能,克服流利度挑战,并提高所有日常场景下的沟通效率。立即探索,发现您语言成长的完美工具!
10 个工具
xix.ai
音乐创作
用于混音制作、采样准备及卡拉OK母带处理的 AI 声部分离工具
2026年最新、最优秀且评分最高的AI音轨分离工具汇总,专为混音制作、采样准备以及卡拉OK音频处理而设计。这些功能强大的创新工具经过实际测试,能够实现精准的音频分离,显著提升工作效率。XIX.AI每周都会更新免费的付费产品对比指南,帮助您找到最适合自身需求的工具。立即探索,发挥您的AI优势。
8 个工具
xix.ai
数据分析
用于收入看板、转化漏斗分析及产品指标分析的 AI SQL 助手
2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
9 个工具
xix.ai
音乐创作
最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

 评论 (30)
0/500
![MichaelThomas]()
A 2 trillion parameter model? The environmental footprint of training these behemoths is starting to overshadow the hype for me. Meta's scale race is impressive, but I hope the next headline is about efficiency breakthroughs, not just size. 🌍💔
![LarryWilliams]()
Honnêtement, l'IA est en train de devenir une course aux armements écologique... Meta sort un modèle de 2T paramètres, mais on ne parle jamais de l'énergie nécessaire pour l'entraîner. DeepSeek R1 montre qu'on peut être efficace sans monstre énergivore. Un peu de sobriété, peut-être ? 🌱
![CarlGonzalez]()
Ладно, Meta выпускает Llama 4 с 2 триллионами параметров... Но я до сих пор не могу заставить свою предыдущую модель правильно переводить рецепт борща! 😅 Интересно, эти «революционные» модели когда-нибудь действительно поймут культурные нюансы или просто станут мастерами генерации клише?
![BruceRoberts]()
Meta qui continue la course aux armements avec ces modèles à 2T paramètres... mais franchement, c'est pas un peu excessif ? En janvier on avait déjà DeepSeek R1 qui montrait qu'on pouvait faire mieux avec moins. J'ai l'impression qu'ils cherchent juste à impressionner avec des chiffres gigantesques 🤔
![OwenLewis]()
Llama 4 sounds like a beast! That 10M token context window is wild—imagine analyzing entire books in one go. But can Meta keep up with DeepSeek’s efficiency? Excited for Behemoth, though! 🚀
![RogerSanchez]()
Llama 4 정말 대단해요! 긴 문맥 스카우트와 마버릭 모델은 놀랍네요. 2T 파라미터의 괴물이 나올 걸 기대하고 있어요. 다만, 설정하는 게 좀 복잡해요. 그래도, AI의 미래가 밝아 보이네요! 🚀
2025年1月,人工智能界掀起波澜,一家鲜为人知的中国特色人工智能初创公司DeepSeek推出了其开创性的开源语言推理模型DeepSeek R1。该模型不仅性能超越了Meta等公司,而且成本仅为传闻中的几百万美元。相比之下,Meta可能仅在几位人工智能团队领导者身上就花费了这么多!这一消息让Meta有些慌乱,尤其是因为他们上个月刚发布的最新Llama模型3.3版已经显得有些过时。
快进到今天,Meta的创始人兼首席执行官马克·扎克伯格在Instagram上宣布推出新的Llama 4系列。该系列包括4000亿参数的Llama 4 Maverick和1090亿参数的Llama 4 Scout,开发者可立即在llama.com和Hugging Face上下载并开始使用。此外,还有一个正在训练中的庞大2万亿参数模型Llama 4 Behemoth的预览,尚未确定发布日期。
多模态和长上下文能力
这些新模型的突出特点是其多模态特性。它们不仅限于文本,还能处理视频和图像。它们的上下文窗口极长——Maverick为100万令牌,Scout更是高达1000万令牌。换句话说,这相当于一次性处理1500页和15000页的文本!想象一下,这对医学、科学或文学等领域处理和生成大量信息的可能性。
专家混合架构
所有三个Llama 4模型都采用了“专家混合(MoE)”架构,这种技术由OpenAI和Mistral等公司推广,备受关注。该方法将多个较小的专业模型组合成一个更大、更高效的模型。每个Llama 4模型由128个不同的专家组成,这意味着每个令牌仅由必要的专家和一个共享专家处理,使模型更具成本效益且运行更快。Meta宣称Llama 4 Maverick可在单个Nvidia H100 DGX主机上运行,部署非常简便。
成本效益和可访问性
Meta致力于让这些模型易于获取。Scout和Maverick均可用于自托管,他们甚至分享了一些诱人的成本估算。例如,Llama 4 Maverick的推理成本在每百万令牌0.19美元至0.49美元之间,相比其他专有模型如GPT-4o,这非常划算。如果您有兴趣通过云提供商使用这些模型,Groq已经提供了具有竞争力的定价。
增强推理和MetaP
这些模型专为推理、编码和问题解决而设计。Meta在训练中采用了一些巧妙技术来提升这些能力,例如移除简单提示并使用持续强化学习,逐步增加提示难度。他们还引入了MetaP,一种新技术,允许在一个模型上设置超参数并将其应用于其他模型,从而节省时间和成本。这对训练像Behemoth这样使用32K GPU并处理超过30万亿令牌的巨型模型尤为重要。
性能与比较
那么,这些模型表现如何?扎克伯格明确表示,他希望开源人工智能引领潮流,Llama 4是朝着这个方向迈出的一大步。虽然它们可能不会在所有方面都创下新的性能记录,但无疑名列前茅。例如,Llama 4 Behemoth在某些基准测试中超越了一些重量级选手,尽管在其他方面仍需追赶DeepSeek R1和OpenAI的o1系列。
Llama 4 Behemoth
- 在MATH-500(95.0)、GPQA Diamond(73.7)和MMLU Pro(82.2)上超越GPT-4.5、Gemini 2.0 Pro和Claude Sonnet 3.7
Llama 4 Maverick
- 在ChartQA、DocVQA、MathVista和MMMU等大多数多模态推理基准测试中击败GPT-4o和Gemini 2.0 Flash
- 与DeepSeek v3.1竞争,同时使用的活跃参数不到其一半
- 基准测试得分:ChartQA(90.0)、DocVQA(94.4)、MMLU Pro(80.5)
Llama 4 Scout
- 在DocVQA(94.4)、MMLU Pro(74.3)和MathVista(70.7)上匹配或超越Mistral 3.1、Gemini 2.0 Flash-Lite和Gemma 3等模型
- 无与伦比的1000万令牌上下文长度——非常适合长文档和代码库
与DeepSeek R1的比较
在顶级竞争中,Llama 4 Behemoth表现出色,但尚未完全超越DeepSeek R1或OpenAI的o1系列。它在MATH-500和MMLU上略逊一筹,但在GPQA Diamond上领先。即便如此,Llama 4显然是推理领域的强劲竞争者。
| 基准测试 | Llama 4 Behemoth | DeepSeek R1 | OpenAI o1-1217 |
|---|---|---|---|
| MATH-500 | 95.0 | 97.3 | 96.4 |
| GPQA Diamond | 73.7 | 71.5 | 75.7 |
| MMLU | 82.2 | 90.8 | 91.8 |
安全性和政治中立性
Meta也没有忽视安全性。他们推出了Llama Guard、Prompt Guard和CyberSecEval等工具以确保安全。他们还强调减少政治偏见,致力于更平衡的方法,特别是在扎克伯格在2024年选举后表示支持共和党政治之后。
Llama 4的未来
通过Llama 4,Meta正在推动人工智能的效率、开放性和性能的边界。无论您是想构建企业级人工智能助手还是深入研究人工智能,Llama 4都提供了强大而灵活的选择,优先考虑推理能力。显然,Meta致力于让人工智能对每个人更易获取且更具影响力。








 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
 Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
 马克·扎克伯格真的相信人工智能是面向每个人的吗?
正在加载播放器…Meta 本周推出了 Glimmer,这是一个开源权重的 AI 模型,任何人都可以下载并在个人硬件上运行——这与该公司更强大的模型 Muse Spark 形成了鲜明对比,后者仍锁定在其自有 API 之后。此次发布伴随着马克·扎克伯格(Mark Zuckerberg)的一封公开信,他在信中主张人工智能应向所有人开放,而非由少数几家实验室控制。但正如 Equity 节目主持人所指出的那样,这一愿景附带了几个重要的限制条件。在本期 TechCrunch 的 Equity 播客中,K
2026年最新最全的AI短视频开场白生成器,适用于Reels、Shorts及产品发布活动!XIX.AI精选了经过实际测试、效果惊人且必试的顶级工具,这些工具将彻底改变游戏规则。本页面每周更新,提供免费与付费版本的对比排名,助您找到提升内容创意和生产力的完美解决方案。 立即探索,释放您的AI优势!
11 个工具
xix.ai
2026年最新最佳、评分最高的人工智能文章大纲工具,专为长文写作打造!这份精心挑选的合集收录了功能强大、具有革命性意义的工具,它们能生成准确、结构清晰的大纲,并经过实际测试验证,可显著提升写作效率。XIX.AI 便是这份精英精选中的成员之一。 获取免费版与付费版的对比指南,助您选择最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
2026 年最新最佳顶级评分 AI 角色扮演聊天应用,用于语言练习、面试准备和日常流利度!XIX.AI 精心策划了一个强大的变革性合集,提供免费与付费对比、真实世界测试以及每周更新的排名。这些必试工具可帮助您提升写作技能,克服流利度挑战,并提高所有日常场景下的沟通效率。立即探索,发现您语言成长的完美工具!
10 个工具
xix.ai
2026年最新、最优秀且评分最高的AI音轨分离工具汇总,专为混音制作、采样准备以及卡拉OK音频处理而设计。这些功能强大的创新工具经过实际测试,能够实现精准的音频分离,显著提升工作效率。XIX.AI每周都会更新免费的付费产品对比指南,帮助您找到最适合自身需求的工具。立即探索,发挥您的AI优势。
8 个工具
xix.ai

2026年最新最优秀的AI SQL辅助工具排名揭晓!XIX.AI精心挑选了一系列功能强大的工具,这些工具会定期更新,并通过真实的场景测试来验证其性能。使用这些值得尝试的工具,您可以快速生成精准的收入分析报表、分析销售流程,并追踪产品各项指标,从而大幅提升工作效率。立即探索,找到最适合您的数据驱动决策工具!238个字符
9 个工具
xix.ai

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

A 2 trillion parameter model? The environmental footprint of training these behemoths is starting to overshadow the hype for me. Meta's scale race is impressive, but I hope the next headline is about efficiency breakthroughs, not just size. 🌍💔
Honnêtement, l'IA est en train de devenir une course aux armements écologique... Meta sort un modèle de 2T paramètres, mais on ne parle jamais de l'énergie nécessaire pour l'entraîner. DeepSeek R1 montre qu'on peut être efficace sans monstre énergivore. Un peu de sobriété, peut-être ? 🌱
Ладно, Meta выпускает Llama 4 с 2 триллионами параметров... Но я до сих пор не могу заставить свою предыдущую модель правильно переводить рецепт борща! 😅 Интересно, эти «революционные» модели когда-нибудь действительно поймут культурные нюансы или просто станут мастерами генерации клише?
Meta qui continue la course aux armements avec ces modèles à 2T paramètres... mais franchement, c'est pas un peu excessif ? En janvier on avait déjà DeepSeek R1 qui montrait qu'on pouvait faire mieux avec moins. J'ai l'impression qu'ils cherchent juste à impressionner avec des chiffres gigantesques 🤔
Llama 4 sounds like a beast! That 10M token context window is wild—imagine analyzing entire books in one go. But can Meta keep up with DeepSeek’s efficiency? Excited for Behemoth, though! 🚀
Llama 4 정말 대단해요! 긴 문맥 스카우트와 마버릭 모델은 놀랍네요. 2T 파라미터의 괴물이 나올 걸 기대하고 있어요. 다만, 설정하는 게 좀 복잡해요. 그래도, AI의 미래가 밝아 보이네요! 🚀












