


 首頁
Meta揭開了長篇小說偵察兵和特立獨行的模型,2T參數龐然大物即將推出!
2025年1月,人工智能界因一家相對鮮為人知的中國AI新創公司DeepSeek推出了開創性的開源語言推理模型DeepSeek R1而震驚。此模型不僅超越了Meta等巨頭的表現,且成本僅為傳聞中的數百萬美元。這金額大概只夠Meta支付其AI團隊幾位領袖的薪水!此消息讓Meta陷入一陣慌亂,特別是因為他們前一個月剛發布的Llama 3.3版本已顯得有些過時。
時至今日,Meta的創始人兼執行長馬克·祖克柏(Mark Zuckerberg)在Instagram上宣布推出全新的Llama 4系列。該系列包括4000億參數的Llama 4 Maverick和1090億參數的Llama 4 Scout,兩者皆可供開發者在llama.com和Hugging Face上立即下載並開始使用。此外,還有一個仍在訓練中的巨型2兆參數模型Llama 4 Behemoth搶先曝光,但尚未有發布日期。
多模態與長上下文能力
這些新模型的突出特點是其多模態性質。它們不僅限於文字,還能處理影片和圖像。並且它們擁有極長的上下文窗口—Maverick為100萬個token,Scout更是高達1000萬個token。換句話說,這相當於一次處理1500頁和15000頁的文字!想像一下,這對於需要處理和生成大量資訊的領域,如醫學、科學或文學,將帶來無限可能。
專家混合架構
所有三款Llama 4模型均採用「專家混合(MoE)」架構,這是一種由OpenAI和Mistral等公司推廣的技術,近年來頗受矚目。此方法將多個較小的專精模型整合成一個更大、更高效的模型。每個Llama 4模型由128個不同專家組成,這意味著每個token僅由必要的專家和一個共享專家處理,使模型更具成本效益且運行更快。Meta宣稱Llama 4 Maverick可在一台Nvidia H100 DGX主機上運行,部署輕鬆無比。
成本效益與可及性
Meta致力於讓這些模型更易於使用。Scout和Maverick均可供自行托管,他們甚至分享了一些誘人的成本估算。例如,Llama 4 Maverick的推理成本每百萬token介於0.19美元至0.49美元,與GPT-4o等專有模型相比,真是物超所值。如果你想透過雲端供應商使用這些模型,Groq已提供具競爭力的價格。
增強推理與MetaP
這些模型專為推理、編碼和問題解決而設計。Meta在訓練中採用了一些巧妙技術來提升這些能力,例如移除簡單提示並使用連續強化學習,搭配逐漸增加難度的提示。他們還引入了MetaP,這是一種允許在一個模型上設置超參數並應用到其他模型的新技術,節省時間和金錢。這對訓練像Behemoth這樣使用32K GPU並處理超過30兆token的巨型模型尤為重要,堪稱遊戲規則改變者。
性能與比較
那麼,這些模型表現如何?祖克柏清楚表明他對開源AI領軍的願景,Llama 4是朝此方向邁出的一大步。雖然它們可能未在所有領域創下新紀錄,但無疑名列前茅。例如,Llama 4 Behemoth在某些基準測試上超越了一些重量級對手,儘管在其他方面仍需追趕DeepSeek R1和OpenAI的o1系列。
Llama 4 Behemoth
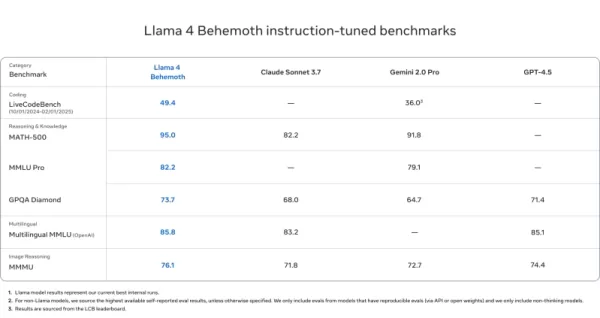
- 在MATH-500(95.0)、GPQA Diamond(73.7)和MMLU Pro(82.2)上超越GPT-4.5、Gemini 2.0 Pro和Claude Sonnet 3.7
Llama 4 Maverick
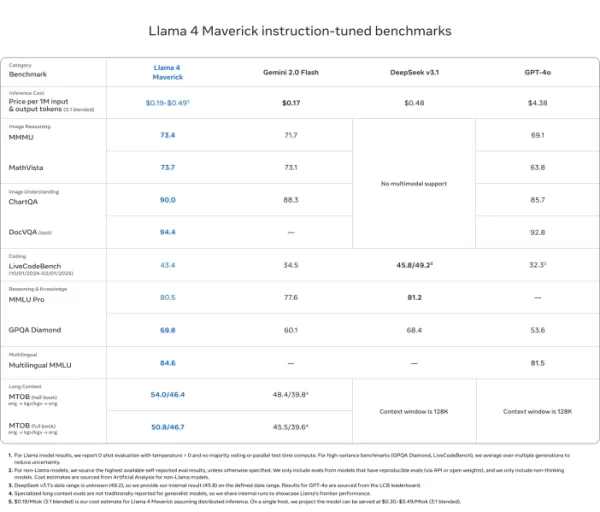
- 在ChartQA、DocVQA、MathVista和MMMU等多模態推理基準測試中擊敗GPT-4o和Gemini 2.0 Flash
- 與DeepSeek v3.1競爭,同時使用不到一半的活躍參數
- 基準分數:ChartQA(90.0)、DocVQA(94.4)、MMLU Pro(80.5)
Llama 4 Scout
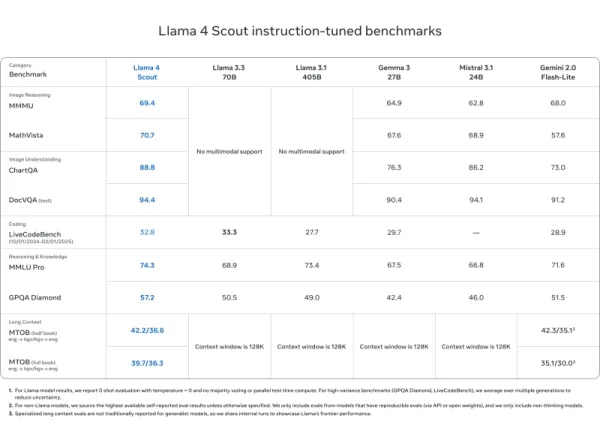
- 在DocVQA(94.4)、MMLU Pro(74.3)和MathVista(70.7)上匹敵或超越Mistral 3.1、Gemini 2.0 Flash-Lite和Gemma 3等模型
- 無與倫比的1000萬token上下文長度—適合長篇文檔和程式碼庫
與DeepSeek R1的比較
在頂尖領域中,Llama 4 Behemoth表現出色,但尚未完全超越DeepSeek R1或OpenAI的o1系列。它在MATH-500和MMLU上略遜一籌,但在GPQA Diamond上領先。儘管如此,Llama 4在推理領域顯然是一個強大的競爭者。
基準 Llama 4 Behemoth DeepSeek R1 OpenAI o1-1217 MATH-500 95.0 97.3 96.4 GPQA Diamond 73.7 71.5 75.7 MMLU 82.2 90.8 91.8
安全與政治中立
Meta也未忽略安全問題。他們推出了Llama Guard、Prompt Guard和CyberSecEval等工具以確保一切合規。他們還強調減少政治偏見,特別是在祖克柏於2024年選舉後表示支持共和黨政治後,致力於採取更平衡的做法。
Llama 4的未來
有了Llama 4,Meta正在推動AI在效率、開放性和性能方面的極限。無論你是想打造企業級AI助理還是深入AI研究,Llama 4提供了強大且靈活的選項,優先考慮推理能力。顯而易見,Meta致力於讓AI對每個人都更具可及性和影響力。
相關文章
 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
馬克·扎克伯格真的相信人工智慧是面向每個人的嗎?
正在載入播放器…Meta 本週推出了 Glimmer,這是一個開源權重的 AI 模型,任何人都可以下載並在個人硬體上執行——這與該公司更強大的模型 Muse Spark 形成了鮮明對比,後者仍鎖定在其自有 API 之後。此次釋出伴隨著馬克·扎克伯格(Mark Zuckerberg)的一封公開信,他在信中主張人工智慧應向所有人開放,而非由少數幾家實驗室控制。但正如 Equity 節目主持人所指出的那樣,這一願景附帶了幾個重要的限制條件。在本期 TechCrunch 的 Equity 播客中,K
相關專題推薦
音樂創作
 用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
 8 個工具
 xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

 評論 (30)
0/500
![MichaelThomas]()
A 2 trillion parameter model? The environmental footprint of training these behemoths is starting to overshadow the hype for me. Meta's scale race is impressive, but I hope the next headline is about efficiency breakthroughs, not just size. 🌍💔
![LarryWilliams]()
Honnêtement, l'IA est en train de devenir une course aux armements écologique... Meta sort un modèle de 2T paramètres, mais on ne parle jamais de l'énergie nécessaire pour l'entraîner. DeepSeek R1 montre qu'on peut être efficace sans monstre énergivore. Un peu de sobriété, peut-être ? 🌱
![CarlGonzalez]()
Ладно, Meta выпускает Llama 4 с 2 триллионами параметров... Но я до сих пор не могу заставить свою предыдущую модель правильно переводить рецепт борща! 😅 Интересно, эти «революционные» модели когда-нибудь действительно поймут культурные нюансы или просто станут мастерами генерации клише?
![BruceRoberts]()
Meta qui continue la course aux armements avec ces modèles à 2T paramètres... mais franchement, c'est pas un peu excessif ? En janvier on avait déjà DeepSeek R1 qui montrait qu'on pouvait faire mieux avec moins. J'ai l'impression qu'ils cherchent juste à impressionner avec des chiffres gigantesques 🤔
![OwenLewis]()
Llama 4 sounds like a beast! That 10M token context window is wild—imagine analyzing entire books in one go. But can Meta keep up with DeepSeek’s efficiency? Excited for Behemoth, though! 🚀
![RogerSanchez]()
Llama 4 정말 대단해요! 긴 문맥 스카우트와 마버릭 모델은 놀랍네요. 2T 파라미터의 괴물이 나올 걸 기대하고 있어요. 다만, 설정하는 게 좀 복잡해요. 그래도, AI의 미래가 밝아 보이네요! 🚀
2025年1月,人工智能界因一家相對鮮為人知的中國AI新創公司DeepSeek推出了開創性的開源語言推理模型DeepSeek R1而震驚。此模型不僅超越了Meta等巨頭的表現,且成本僅為傳聞中的數百萬美元。這金額大概只夠Meta支付其AI團隊幾位領袖的薪水!此消息讓Meta陷入一陣慌亂,特別是因為他們前一個月剛發布的Llama 3.3版本已顯得有些過時。
時至今日,Meta的創始人兼執行長馬克·祖克柏(Mark Zuckerberg)在Instagram上宣布推出全新的Llama 4系列。該系列包括4000億參數的Llama 4 Maverick和1090億參數的Llama 4 Scout,兩者皆可供開發者在llama.com和Hugging Face上立即下載並開始使用。此外,還有一個仍在訓練中的巨型2兆參數模型Llama 4 Behemoth搶先曝光,但尚未有發布日期。
多模態與長上下文能力
這些新模型的突出特點是其多模態性質。它們不僅限於文字,還能處理影片和圖像。並且它們擁有極長的上下文窗口—Maverick為100萬個token,Scout更是高達1000萬個token。換句話說,這相當於一次處理1500頁和15000頁的文字!想像一下,這對於需要處理和生成大量資訊的領域,如醫學、科學或文學,將帶來無限可能。
專家混合架構
所有三款Llama 4模型均採用「專家混合(MoE)」架構,這是一種由OpenAI和Mistral等公司推廣的技術,近年來頗受矚目。此方法將多個較小的專精模型整合成一個更大、更高效的模型。每個Llama 4模型由128個不同專家組成,這意味著每個token僅由必要的專家和一個共享專家處理,使模型更具成本效益且運行更快。Meta宣稱Llama 4 Maverick可在一台Nvidia H100 DGX主機上運行,部署輕鬆無比。
成本效益與可及性
Meta致力於讓這些模型更易於使用。Scout和Maverick均可供自行托管,他們甚至分享了一些誘人的成本估算。例如,Llama 4 Maverick的推理成本每百萬token介於0.19美元至0.49美元,與GPT-4o等專有模型相比,真是物超所值。如果你想透過雲端供應商使用這些模型,Groq已提供具競爭力的價格。
增強推理與MetaP
這些模型專為推理、編碼和問題解決而設計。Meta在訓練中採用了一些巧妙技術來提升這些能力,例如移除簡單提示並使用連續強化學習,搭配逐漸增加難度的提示。他們還引入了MetaP,這是一種允許在一個模型上設置超參數並應用到其他模型的新技術,節省時間和金錢。這對訓練像Behemoth這樣使用32K GPU並處理超過30兆token的巨型模型尤為重要,堪稱遊戲規則改變者。
性能與比較
那麼,這些模型表現如何?祖克柏清楚表明他對開源AI領軍的願景,Llama 4是朝此方向邁出的一大步。雖然它們可能未在所有領域創下新紀錄,但無疑名列前茅。例如,Llama 4 Behemoth在某些基準測試上超越了一些重量級對手,儘管在其他方面仍需追趕DeepSeek R1和OpenAI的o1系列。
Llama 4 Behemoth
- 在MATH-500(95.0)、GPQA Diamond(73.7)和MMLU Pro(82.2)上超越GPT-4.5、Gemini 2.0 Pro和Claude Sonnet 3.7
Llama 4 Maverick
- 在ChartQA、DocVQA、MathVista和MMMU等多模態推理基準測試中擊敗GPT-4o和Gemini 2.0 Flash
- 與DeepSeek v3.1競爭,同時使用不到一半的活躍參數
- 基準分數:ChartQA(90.0)、DocVQA(94.4)、MMLU Pro(80.5)
Llama 4 Scout
- 在DocVQA(94.4)、MMLU Pro(74.3)和MathVista(70.7)上匹敵或超越Mistral 3.1、Gemini 2.0 Flash-Lite和Gemma 3等模型
- 無與倫比的1000萬token上下文長度—適合長篇文檔和程式碼庫
與DeepSeek R1的比較
在頂尖領域中,Llama 4 Behemoth表現出色,但尚未完全超越DeepSeek R1或OpenAI的o1系列。它在MATH-500和MMLU上略遜一籌,但在GPQA Diamond上領先。儘管如此,Llama 4在推理領域顯然是一個強大的競爭者。
| 基準 | Llama 4 Behemoth | DeepSeek R1 | OpenAI o1-1217 |
|---|---|---|---|
| MATH-500 | 95.0 | 97.3 | 96.4 |
| GPQA Diamond | 73.7 | 71.5 | 75.7 |
| MMLU | 82.2 | 90.8 | 91.8 |
安全與政治中立
Meta也未忽略安全問題。他們推出了Llama Guard、Prompt Guard和CyberSecEval等工具以確保一切合規。他們還強調減少政治偏見,特別是在祖克柏於2024年選舉後表示支持共和黨政治後,致力於採取更平衡的做法。
Llama 4的未來
有了Llama 4,Meta正在推動AI在效率、開放性和性能方面的極限。無論你是想打造企業級AI助理還是深入AI研究,Llama 4提供了強大且靈活的選項,優先考慮推理能力。顯而易見,Meta致力於讓AI對每個人都更具可及性和影響力。








 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
 Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
 馬克·扎克伯格真的相信人工智慧是面向每個人的嗎?
正在載入播放器…Meta 本週推出了 Glimmer,這是一個開源權重的 AI 模型,任何人都可以下載並在個人硬體上執行——這與該公司更強大的模型 Muse Spark 形成了鮮明對比,後者仍鎖定在其自有 API 之後。此次釋出伴隨著馬克·扎克伯格(Mark Zuckerberg)的一封公開信,他在信中主張人工智慧應向所有人開放,而非由少數幾家實驗室控制。但正如 Equity 節目主持人所指出的那樣,這一願景附帶了幾個重要的限制條件。在本期 TechCrunch 的 Equity 播客中,K

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

A 2 trillion parameter model? The environmental footprint of training these behemoths is starting to overshadow the hype for me. Meta's scale race is impressive, but I hope the next headline is about efficiency breakthroughs, not just size. 🌍💔
Honnêtement, l'IA est en train de devenir une course aux armements écologique... Meta sort un modèle de 2T paramètres, mais on ne parle jamais de l'énergie nécessaire pour l'entraîner. DeepSeek R1 montre qu'on peut être efficace sans monstre énergivore. Un peu de sobriété, peut-être ? 🌱
Ладно, Meta выпускает Llama 4 с 2 триллионами параметров... Но я до сих пор не могу заставить свою предыдущую модель правильно переводить рецепт борща! 😅 Интересно, эти «революционные» модели когда-нибудь действительно поймут культурные нюансы или просто станут мастерами генерации клише?
Meta qui continue la course aux armements avec ces modèles à 2T paramètres... mais franchement, c'est pas un peu excessif ? En janvier on avait déjà DeepSeek R1 qui montrait qu'on pouvait faire mieux avec moins. J'ai l'impression qu'ils cherchent juste à impressionner avec des chiffres gigantesques 🤔
Llama 4 sounds like a beast! That 10M token context window is wild—imagine analyzing entire books in one go. But can Meta keep up with DeepSeek’s efficiency? Excited for Behemoth, though! 🚀
Llama 4 정말 대단해요! 긴 문맥 스카우트와 마버릭 모델은 놀랍네요. 2T 파라미터의 괴물이 나올 걸 기대하고 있어요. 다만, 설정하는 게 좀 복잡해요. 그래도, AI의 미래가 밝아 보이네요! 🚀












