


 首頁
科大訊飛星火釋出0.65B編碼器語音模型,搭載30B混合專家架構,基於完全國產算力構建
科大訊飛推出了基於純國產算力基礎設施構建的語音基礎大模型 Spark-Audio-1.0-Preview。
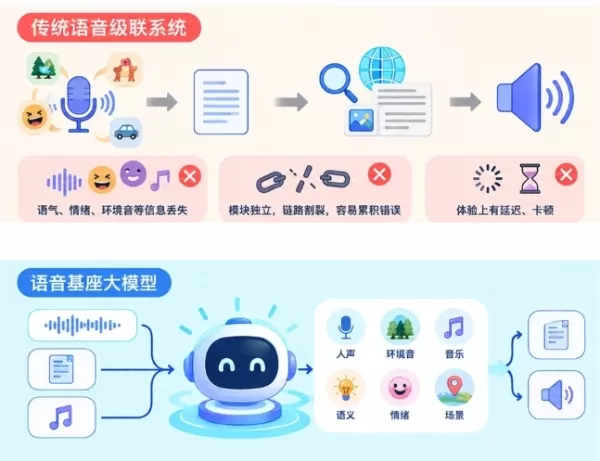
此前,基於大模型的音訊處理主要依賴級聯方式:先將語音轉換為文字,再將其傳遞給模型進行分析。這種方法存在兩大主要缺陷:一是資訊丟失,因為文字無法捕捉語調、情感和背景聲音,導致上下文不完整;二是工作流碎片化,轉錄、說話人識別和翻譯等獨立模組序列執行,導致誤差累積、延遲增加以及使用者體驗不佳。
超越轉錄:直接語音理解
該語音基礎大模型超越了簡單的轉錄功能,能夠直接解讀音訊。它可以區分人聲、環境噪音和音樂,同時把握聲音中的語義、情感和上下文線索。
初版 Spark-Audio-1.0-Preview 包含一個 0.65B 引數的音訊編碼器(密集結構)和一個 30B-A3B 引數的大語言模型(MoE 結構)。該模型基於完全國產算力叢集,使用 1300 萬小時的音訊和大量文字資料進行訓練,支援文字和音訊雙重輸入。它支援語音轉錄、多語言翻譯、多方言識別、環境音識別、說話人識別、情感分析和複雜音訊問答等任務,使機器從“聽得清”邁向“聽得懂”。與科大訊飛星火大模型的“1+N”系統類似,使用者可對該語音基礎模型進行微調,構建針對語音識別、實時翻譯和互動式語音應用的專用系統。
支援 99 種語言和 202 種方言,在複雜場景中表現卓越
根據官方資料,Spark-Audio-1.0-Preview 在各種語音評估任務中的表現與競爭對手相當或更優,特別是在高噪音和輕聲說話等具有挑戰性的真實場景中。其效能也與更大規模的閉源語音基礎大模型高度一致。
該模型支援識別 99 種語言和 202 種方言。在類似規模的 Qwen3.5-omni-flash(35B-A3B)的多語言和多方言語音識別平均表現中,它展現出更優的效能,並達到了顯著更大規模的 Qwen3.5-omni-plus 的效能水平。在 Fleurs、Kespeech 和 LibriSpeech 等針對中英、多語言和多方言語音識別的評估中,它優於 Gemini-3.1 Pro,並在 Fleurs 中文測試集上取得了 SOTA(當前最佳)成績。
科大訊飛承認,雖然該版本在通用知識、數學和程式碼任務中保持了強勁效能,但在指令遵循、對話和音訊理解方面仍有提升空間。未來的更新將重點加強這些領域。Spark-Audio-1.0-Preview 現已開放公眾體驗,API 介面即將在科大訊飛開放平臺上線。
相關文章
 Suno 釋出重大更新,推出高階音軌分離與車載支援功能
Suno 已對其 AI 音樂生成平臺推出重大更新,最佳化了網頁和移動端的體驗,以簡化創作流程並提升可用性。該平臺正朝著更加便捷高效的 AI 音樂製作階段邁進,將專業音訊工具與駕駛等日常場景相結合。增強的音軌分離功能此次更新的一個主要亮點是高階音軌分離功能,該功能可將人聲、鼓點、貝斯和樂器分離到獨立的音軌中。這一能力使音樂人能夠輕鬆獲取高質量的分軌素材,用於混音或二次創作,顯著降低了專業後期製作的門檻。分軌匯出為 MIDI 檔案使用者現在可以直接將分離後的音軌匯出為 MIDI 檔案。這一功能對於需要在
Cohere 的 Joëlle Pineau 談論主權人工智慧與企業資安
由 Cohere 委託 IDC 進行的研究探討了「主權人工智慧」議題,首席人工智慧官 Joëlle Pineau 在其中闡述了企業雲端安全與資料治理的關鍵策略。根據由人工智慧公司 Cohere 委託 IDC 撰寫的報告《2026 年主權人工智慧採用現狀》,每三位企業領導者中就有一位難以用自己的話來定義「主權人工智慧」。加拿大人工智慧公司 Cohere 專門開發適用於企業用途的大型語言模型(LLMs
亞洲人工智慧初創公司推出類似“神話”模型,而Anthropic出口禁令持續
週三,中國網路安全公司360據報道推出了“圖龍風”(Tulongfeng),稱其可直接與Anthropic的“神話”(Mythos)模型競爭。這款專注於網路安全的AI模型據稱實力強大,特朗普政府目前已禁止非美國人使用它及其更受限的版本“寓言5”(Fable 5)。同周早些時候,總部位於東京的AI初創公司Sakana AI推出了“河豚”(Fugu),該模型以日語中河豚一詞命名。該公司表示,這款前沿AI模型“與Anthropic的寓言5和神話預覽版等領先模型並駕齊驅”。它還專為智慧體設計,能夠透過
相關專題推薦
代碼
 最佳 AI 測試生成器:為 API 和函式建立單元測試
2026 年最新、最受好評的 API 與函式開發用 AI 測試生成器。XIX.AI 精選了一系列強大且顛覆業界的必試工具,這些工具均經過嚴格的實際環境測試,以提供精確的結果。 您將在此找到詳盡的免費版與付費版比較分析,以及每週更新的排行榜。立即探索,發掘最適合您的工具,並在軟體測試領域中發揮您的 AI 優勢。
 7 個工具
 xix.ai
商業
最佳 AI 商業計畫書生成工具:將點子轉化為投資人簡報草稿
2026 年最新、最受好評的 AI 商業計畫書生成工具現已登陸 XIX.AI!這份精心精選的合集收錄了多款強大且具顛覆性的工具,能協助創作者迅速將創新構想轉化為精緻的投資人簡報草稿。 您將在此找到每週更新的排行榜、免費與付費版本的比較分析,以及實際測試報告,助您挑選必試的解決方案,以提升生產力並取得最佳成效。立即探索,發掘最適合您的工具,成功爭取資金!
11 個工具
xix.ai
金融
適用於 QuickBooks、Xero 及多實體對帳的人工智慧發票 OCR 平台
2026 年最新最佳 AI 發票 OCR 平台,適用於 QuickBooks、Xero 及多實體對帳! XIX.AI 精選了一系列備受好評的強大工具,這些工具均經過精準的實測驗證,並提供每週更新的排名。這些必試解決方案能簡化發票處理流程、提升生產力,並在複雜的商業環境中節省時間。立即查看免費版與付費版的比較,找出最適合您的方案。現在就探索,釋放您的 AI 競爭優勢!
8 個工具
xix.ai
商業
適用於企業提案工作流的 AI RFP 響應軟體
2026年最先進的企業提案工作流專用AI RFP回覆軟體!XIX.AI精心整理了一份經過嚴格實際測試、評分極高的優質工具清單,其中包含諸多提升效率、簡化提案流程的實用功能。您可以檢視免費版與付費版的對比資訊、詳細的排名資料,瞭解這些具有顛覆性意義的解決方案如何幫助您更快地撰寫出高質量回復。立即探索,讓AI優勢助力您的業務發展!
9 個工具
xix.ai
視頻創作
AI 字幕與配音工具:為全球觀眾進行影片在地化
2026 年最新精選:最受好評的人工智慧字幕與配音工具,專為將影片在地化以服務全球觀眾而設計。憑藉顛覆業界的準確度,強大提升內容跨越語言障礙的觸及範圍。實際測試證明,這些必試解決方案提供免費與付費版本的比較,以及可靠的排名,助您將生產力提升至最高。立即探索,發掘最適合您的全球內容發佈工具
10 個工具
xix.ai
自動化
用於應付帳款自動化、核准流程及 ERP 同步工作流程的 AI 發票處理工具
2026 年最新最佳 AI 發票處理工具,適用於應付帳款自動化、審批流程及 ERP 同步工作流程!XIX.AI 嚴選經過嚴格實測、評價極高且功能強大的解決方案,可大幅提升生產力。 獲取免費版與付費版的比較分析,查看詳細排名,並發掘必試選項以優化您的財務營運。立即探索,釋放您的 AI 競爭優勢!
9 個工具
xix.ai

 評論 (0)
0/500
科大訊飛推出了基於純國產算力基礎設施構建的語音基礎大模型 Spark-Audio-1.0-Preview。
此前,基於大模型的音訊處理主要依賴級聯方式:先將語音轉換為文字,再將其傳遞給模型進行分析。這種方法存在兩大主要缺陷:一是資訊丟失,因為文字無法捕捉語調、情感和背景聲音,導致上下文不完整;二是工作流碎片化,轉錄、說話人識別和翻譯等獨立模組序列執行,導致誤差累積、延遲增加以及使用者體驗不佳。
超越轉錄:直接語音理解
該語音基礎大模型超越了簡單的轉錄功能,能夠直接解讀音訊。它可以區分人聲、環境噪音和音樂,同時把握聲音中的語義、情感和上下文線索。
初版 Spark-Audio-1.0-Preview 包含一個 0.65B 引數的音訊編碼器(密集結構)和一個 30B-A3B 引數的大語言模型(MoE 結構)。該模型基於完全國產算力叢集,使用 1300 萬小時的音訊和大量文字資料進行訓練,支援文字和音訊雙重輸入。它支援語音轉錄、多語言翻譯、多方言識別、環境音識別、說話人識別、情感分析和複雜音訊問答等任務,使機器從“聽得清”邁向“聽得懂”。與科大訊飛星火大模型的“1+N”系統類似,使用者可對該語音基礎模型進行微調,構建針對語音識別、實時翻譯和互動式語音應用的專用系統。
支援 99 種語言和 202 種方言,在複雜場景中表現卓越
根據官方資料,Spark-Audio-1.0-Preview 在各種語音評估任務中的表現與競爭對手相當或更優,特別是在高噪音和輕聲說話等具有挑戰性的真實場景中。其效能也與更大規模的閉源語音基礎大模型高度一致。
該模型支援識別 99 種語言和 202 種方言。在類似規模的 Qwen3.5-omni-flash(35B-A3B)的多語言和多方言語音識別平均表現中,它展現出更優的效能,並達到了顯著更大規模的 Qwen3.5-omni-plus 的效能水平。在 Fleurs、Kespeech 和 LibriSpeech 等針對中英、多語言和多方言語音識別的評估中,它優於 Gemini-3.1 Pro,並在 Fleurs 中文測試集上取得了 SOTA(當前最佳)成績。
科大訊飛承認,雖然該版本在通用知識、數學和程式碼任務中保持了強勁效能,但在指令遵循、對話和音訊理解方面仍有提升空間。未來的更新將重點加強這些領域。Spark-Audio-1.0-Preview 現已開放公眾體驗,API 介面即將在科大訊飛開放平臺上線。








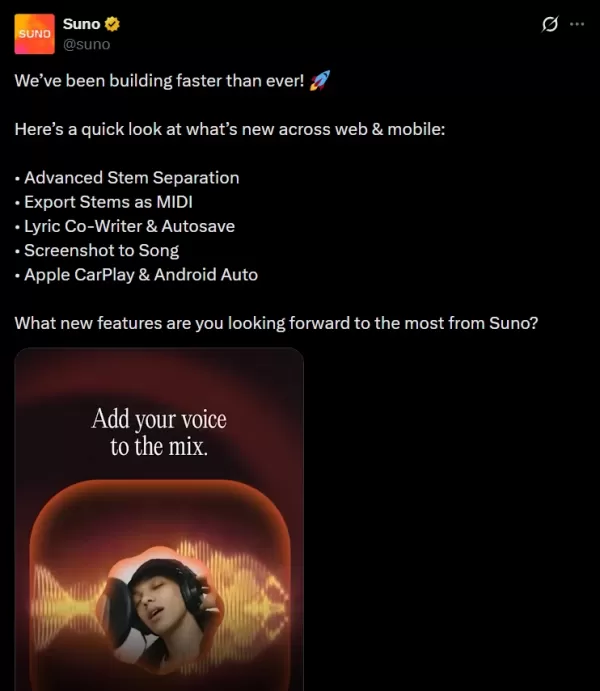 Suno 釋出重大更新,推出高階音軌分離與車載支援功能
Suno 已對其 AI 音樂生成平臺推出重大更新,最佳化了網頁和移動端的體驗,以簡化創作流程並提升可用性。該平臺正朝著更加便捷高效的 AI 音樂製作階段邁進,將專業音訊工具與駕駛等日常場景相結合。增強的音軌分離功能此次更新的一個主要亮點是高階音軌分離功能,該功能可將人聲、鼓點、貝斯和樂器分離到獨立的音軌中。這一能力使音樂人能夠輕鬆獲取高質量的分軌素材,用於混音或二次創作,顯著降低了專業後期製作的門檻。分軌匯出為 MIDI 檔案使用者現在可以直接將分離後的音軌匯出為 MIDI 檔案。這一功能對於需要在
 Cohere 的 Joëlle Pineau 談論主權人工智慧與企業資安
由 Cohere 委託 IDC 進行的研究探討了「主權人工智慧」議題,首席人工智慧官 Joëlle Pineau 在其中闡述了企業雲端安全與資料治理的關鍵策略。根據由人工智慧公司 Cohere 委託 IDC 撰寫的報告《2026 年主權人工智慧採用現狀》,每三位企業領導者中就有一位難以用自己的話來定義「主權人工智慧」。加拿大人工智慧公司 Cohere 專門開發適用於企業用途的大型語言模型(LLMs
 亞洲人工智慧初創公司推出類似“神話”模型,而Anthropic出口禁令持續
週三,中國網路安全公司360據報道推出了“圖龍風”(Tulongfeng),稱其可直接與Anthropic的“神話”(Mythos)模型競爭。這款專注於網路安全的AI模型據稱實力強大,特朗普政府目前已禁止非美國人使用它及其更受限的版本“寓言5”(Fable 5)。同周早些時候,總部位於東京的AI初創公司Sakana AI推出了“河豚”(Fugu),該模型以日語中河豚一詞命名。該公司表示,這款前沿AI模型“與Anthropic的寓言5和神話預覽版等領先模型並駕齊驅”。它還專為智慧體設計,能夠透過
2026 年最新、最受好評的 API 與函式開發用 AI 測試生成器。XIX.AI 精選了一系列強大且顛覆業界的必試工具,這些工具均經過嚴格的實際環境測試,以提供精確的結果。 您將在此找到詳盡的免費版與付費版比較分析,以及每週更新的排行榜。立即探索,發掘最適合您的工具,並在軟體測試領域中發揮您的 AI 優勢。
7 個工具
xix.ai
2026 年最新、最受好評的 AI 商業計畫書生成工具現已登陸 XIX.AI!這份精心精選的合集收錄了多款強大且具顛覆性的工具,能協助創作者迅速將創新構想轉化為精緻的投資人簡報草稿。 您將在此找到每週更新的排行榜、免費與付費版本的比較分析,以及實際測試報告,助您挑選必試的解決方案,以提升生產力並取得最佳成效。立即探索,發掘最適合您的工具,成功爭取資金!
11 個工具
xix.ai
2026 年最新最佳 AI 發票 OCR 平台,適用於 QuickBooks、Xero 及多實體對帳! XIX.AI 精選了一系列備受好評的強大工具,這些工具均經過精準的實測驗證,並提供每週更新的排名。這些必試解決方案能簡化發票處理流程、提升生產力,並在複雜的商業環境中節省時間。立即查看免費版與付費版的比較,找出最適合您的方案。現在就探索,釋放您的 AI 競爭優勢!
8 個工具
xix.ai
2026年最先進的企業提案工作流專用AI RFP回覆軟體!XIX.AI精心整理了一份經過嚴格實際測試、評分極高的優質工具清單,其中包含諸多提升效率、簡化提案流程的實用功能。您可以檢視免費版與付費版的對比資訊、詳細的排名資料,瞭解這些具有顛覆性意義的解決方案如何幫助您更快地撰寫出高質量回復。立即探索,讓AI優勢助力您的業務發展!
9 個工具
xix.ai
2026 年最新精選:最受好評的人工智慧字幕與配音工具,專為將影片在地化以服務全球觀眾而設計。憑藉顛覆業界的準確度,強大提升內容跨越語言障礙的觸及範圍。實際測試證明,這些必試解決方案提供免費與付費版本的比較,以及可靠的排名,助您將生產力提升至最高。立即探索,發掘最適合您的全球內容發佈工具
10 個工具
xix.ai
2026 年最新最佳 AI 發票處理工具,適用於應付帳款自動化、審批流程及 ERP 同步工作流程!XIX.AI 嚴選經過嚴格實測、評價極高且功能強大的解決方案,可大幅提升生產力。 獲取免費版與付費版的比較分析,查看詳細排名,並發掘必試選項以優化您的財務營運。立即探索,釋放您的 AI 競爭優勢!
9 個工具
xix.ai












