


 Дом
iFlytek Xinghuo представляет 0.65B энкодерную модель речи с 30B MoE, построенную на полностью отечественных вычислительных мощностях
iFLYTEK представила Spark-Audio-1.0-Preview, базовую языковую модель для обработки речи, полностью созданную на отечественной вычислительной инфраструктуре.
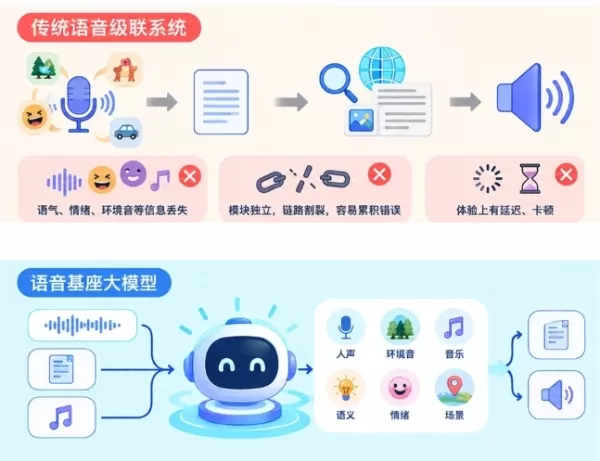
Ранее обработка аудио с помощью больших моделей опиралась на каскадный метод: сначала речь преобразовывалась в текст, а затем передавалась модели для анализа. Этот подход имеет два основных недостатка: потеря информации, поскольку текст не передает тон, эмоции и фоновые звуки, что приводит к неполному контексту; и фрагментированные рабочие процессы, при которых независимые модули для транскрипции, идентификации говорящего и перевода работают последовательно, вызывая накопление ошибок, задержки и низкое качество пользовательского опыта.
Выход за пределы транскрипции: прямое понимание речи
Эта базовая модель для обработки речи выходит за рамки простой транскрипции и напрямую интерпретирует аудио. Она способна различать человеческие голоса, фоновый шум и музыку, а также понимать семантику, эмоции и контекстные подсказки внутри звука.
Первоначальный выпуск Spark-Audio-1.0-Preview включает 0,65B аудиоэнкодер (плотная структура) и большую языковую модель 30B-A3B (структура MoE). Обученная на 13 миллионах часов аудио и обширных текстовых данных с использованием полностью отечественного вычислительного кластера, модель принимает как текстовые, так и аудио входные данные. Она поддерживает задачи, включая транскрипцию речи, многоязычный перевод, распознавание нескольких диалектов, идентификацию фоновых звуков, распознавание говорящего, анализ тональности и сложные вопросы и ответы по аудио, позволяя машинам перейти от «четкого слышания» к «пониманию». Аналогично системе «1+N» больших моделей iFLYTEK Spark, пользователи могут дообучить эту базовую модель для речи, чтобы создать специализированные системы для распознавания речи, перевода в реальном времени и интерактивных приложений для речи.
Поддержка 99 языков и 202 диалектов, превосходные результаты в сложных сценариях
Согласно официальным данным, Spark-Audio-1.0-Preview демонстрирует результаты, сопоставимые или лучшие по сравнению с конкурентами в различных задачах оценки речи, особенно в сложных реальных сценариях, таких как высокий уровень шума и тихая речь. Ее результаты также тесно соответствуют более крупным закрытым базовым моделям для обработки речи.
Модель поддерживает распознавание 99 языков и 202 диалектов. Она демонстрирует превосходные средние результаты в многоязычном и многодиалектном распознавании речи по сравнению с аналогичной по размеру Qwen3.5-omni-flash (35B-A3B) и соответствует результатам значительно более крупной Qwen3.5-omni-plus. В таких оценках, как Fleurs, Kespeech и LibriSpeech для китайско-английского, многоязычного и многодиалектного распознавания речи, она превосходит Gemini-3.1 Pro и достигает SOTA на тестовом наборе Fleurs на китайском языке.
iFLYTEK признает, что хотя эта версия сохраняет высокие показатели в задачах общих знаний, математики и программирования, есть возможности для улучшения в следовании инструкциям, диалогах и понимании аудио. Будущие обновления будут сосредоточены на усилении этих областей. Spark-Audio-1.0-Preview теперь доступна для публичного тестирования, доступ к API будет выпущен на платформе iFLYTEK Open Platform в ближайшее время.
Связанная статья
 Zoho помогает компаниям внедрять ИИ-агентов
Рынок стремительно развивается в направлении агентов на базе искусственного интеллектаZoho подчеркивает, что ИИ развивается в геометрической прогрессии, поэтому предприятиям крайне важно адаптироватьс
Suno представляет масштабное обновление с расширенным разделением треков и поддержкой автомобилей
Suno выпустила значительные обновления своей платформы для генерации музыки на основе искусственного интеллекта, улучшив как веб-версию, так и мобильный опыт для упрощения процесса создания контента и повышения удобства использования. Платформа движе
Жоэль Пино из компании Cohere о суверенном ИИ и корпоративной безопасности
В исследовании IDC, проведенном по заказу компании Cohere, рассматривается тема «суверенного ИИ», а директор по ИИ Жоэль Пино излагает основные стратегии обеспечения безопасности корпоративных облачны
Рекомендации по связанным специальным темам
код
 Лучшие генераторы тестов на ИИ: создание модульных тестов для API и функций
2026 год: лучшие и наиболее высоко оценённые генераторы тестов для ИИ, предназначенные для разработки API и функций. XIX.AI собрал мощный набор инструментов, способных изменить подход к тестированию, которые проходят строгие тесты в реальных условиях для получения точных результатов. Здесь вы найдёте подробные сравнения бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Ознакомьтесь с ними прямо сейчас, чтобы выбрать идеальный инструмент и получить преимущество в тестировании программного обеспечения с использованием ИИ.
 7 инструментов
 xix.ai
Бизнес
Лучшие генераторы бизнес-планов на базе ИИ: превратите идеи в черновые версии презентаций для инвесторов
2026 года: самые новые и лучшие генераторы бизнес-планов на базе ИИ с самыми высокими рейтингами — уже здесь, на XIX.AI! В этой тщательно отобранной подборке представлены мощные инструменты, способные кардинально изменить ситуацию и помочь создателям быстро превратить инновационные идеи в отточенные черновые версии презентаций для инвесторов. Здесь вы найдете еженедельно обновляемые рейтинги, сравнительные обзоры бесплатных и платных версий, а также результаты реальных тестов, которые помогут вам выбрать решение, которое обязательно стоит попробовать, чтобы повысить продуктивность и добиться максимальных результатов. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для привлечения финансирования!
11 инструментов
xix.ai
Финансы
Платформы OCR с искусственным интеллектом для обработки счетов-фактур в QuickBooks, Xero и сверки данных по нескольким юридическим лицам
2026: Лучшие современные платформы с ИИ для распознавания счетов-фактур (OCR) для QuickBooks, Xero и сверки данных по нескольким юридическим лицам! XIX.AI составляет рейтинг лучших мощных инструментов, которые проходят точные тесты в реальных условиях и еженедельно обновляются. Эти решения, которые обязательно стоит попробовать, оптимизируют обработку счетов, повышают производительность и экономят время в сложных бизнес-средах. Воспользуйтесь сравнением бесплатных и платных версий, чтобы найти идеальный вариант для себя. Узнайте больше прямо сейчас, чтобы раскрыть все преимущества ИИ!
8 инструментов
xix.ai
Бизнес
Программное обеспечение для ответов на заявки в области ИИ, предназначенное для рабочих процессов подготовки корпоративных предложений
2026 год: лучшее программное обеспечение для ответов на заявки в области ИИ, предназначенное для использования в корпоративных процессах подготовки предложений! XIX.AI собрал список самых эффективных инструментов, прошедших строгие тестирования в реальных условиях, и предлагает функции, которые обязательно стоит опробовать для повышения производительности и оптимизации процедур составления предложений. Получите бесплатное сравнение версий с платными, ознакомьтесь с подробным рейтингом и узнайте, как эти инновационные решения помогут вам быстрее создавать качественные ответы. Ознакомьтесь сейчас, чтобы раскрыть потенциал ИИ в вашей работе!
9 инструментов
xix.ai
Создание видео
Инструменты ИИ для создания субтитров и дубляжа: локализация видео для международной аудитории
2026: лучшие и самые популярные инструменты для создания субтитров и дубляжа с ИИ, отобранные специально для локализации видео для международной аудитории. Значительно расширьте охват контента, преодолевая языковые барьеры, благодаря революционной точности. Реальные тесты доказывают, что эти решения, которые обязательно стоит попробовать, позволяют сравнить бесплатные и платные версии и предлагают надежные рейтинги для максимального повышения продуктивности. Изучите их прямо сейчас, чтобы найти идеальный инструмент для распространения контента по всему миру.
10 инструментов
xix.ai
автоматизация
Инструменты искусственного интеллекта для обработки счетов-фактур, предназначенные для автоматизации учета кредиторской задолженности, маршрутизации утверждений и синхронизации с системами ERP
2026: Новейшие и лучшие инструменты на базе ИИ для обработки счетов-фактур, автоматизации учета кредиторской задолженности, маршрутизации утверждений и синхронизации с ERP-системами! XIX.AI отбирает высокооцененные и мощные решения, прошедшие строгие практические испытания, которые позволяют значительно повысить производительность. Получите сравнение бесплатных и платных версий, ознакомьтесь с подробными рейтингами и откройте для себя варианты, которые обязательно стоит попробовать для оптимизации ваших финансовых операций. Узнайте больше прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai

 Комментарии (0)
iFLYTEK представила Spark-Audio-1.0-Preview, базовую языковую модель для обработки речи, полностью созданную на отечественной вычислительной инфраструктуре.
Ранее обработка аудио с помощью больших моделей опиралась на каскадный метод: сначала речь преобразовывалась в текст, а затем передавалась модели для анализа. Этот подход имеет два основных недостатка: потеря информации, поскольку текст не передает тон, эмоции и фоновые звуки, что приводит к неполному контексту; и фрагментированные рабочие процессы, при которых независимые модули для транскрипции, идентификации говорящего и перевода работают последовательно, вызывая накопление ошибок, задержки и низкое качество пользовательского опыта.
Выход за пределы транскрипции: прямое понимание речи
Эта базовая модель для обработки речи выходит за рамки простой транскрипции и напрямую интерпретирует аудио. Она способна различать человеческие голоса, фоновый шум и музыку, а также понимать семантику, эмоции и контекстные подсказки внутри звука.
Первоначальный выпуск Spark-Audio-1.0-Preview включает 0,65B аудиоэнкодер (плотная структура) и большую языковую модель 30B-A3B (структура MoE). Обученная на 13 миллионах часов аудио и обширных текстовых данных с использованием полностью отечественного вычислительного кластера, модель принимает как текстовые, так и аудио входные данные. Она поддерживает задачи, включая транскрипцию речи, многоязычный перевод, распознавание нескольких диалектов, идентификацию фоновых звуков, распознавание говорящего, анализ тональности и сложные вопросы и ответы по аудио, позволяя машинам перейти от «четкого слышания» к «пониманию». Аналогично системе «1+N» больших моделей iFLYTEK Spark, пользователи могут дообучить эту базовую модель для речи, чтобы создать специализированные системы для распознавания речи, перевода в реальном времени и интерактивных приложений для речи.
Поддержка 99 языков и 202 диалектов, превосходные результаты в сложных сценариях
Согласно официальным данным, Spark-Audio-1.0-Preview демонстрирует результаты, сопоставимые или лучшие по сравнению с конкурентами в различных задачах оценки речи, особенно в сложных реальных сценариях, таких как высокий уровень шума и тихая речь. Ее результаты также тесно соответствуют более крупным закрытым базовым моделям для обработки речи.
Модель поддерживает распознавание 99 языков и 202 диалектов. Она демонстрирует превосходные средние результаты в многоязычном и многодиалектном распознавании речи по сравнению с аналогичной по размеру Qwen3.5-omni-flash (35B-A3B) и соответствует результатам значительно более крупной Qwen3.5-omni-plus. В таких оценках, как Fleurs, Kespeech и LibriSpeech для китайско-английского, многоязычного и многодиалектного распознавания речи, она превосходит Gemini-3.1 Pro и достигает SOTA на тестовом наборе Fleurs на китайском языке.
iFLYTEK признает, что хотя эта версия сохраняет высокие показатели в задачах общих знаний, математики и программирования, есть возможности для улучшения в следовании инструкциям, диалогах и понимании аудио. Будущие обновления будут сосредоточены на усилении этих областей. Spark-Audio-1.0-Preview теперь доступна для публичного тестирования, доступ к API будет выпущен на платформе iFLYTEK Open Platform в ближайшее время.








 Zoho помогает компаниям внедрять ИИ-агентов
Рынок стремительно развивается в направлении агентов на базе искусственного интеллектаZoho подчеркивает, что ИИ развивается в геометрической прогрессии, поэтому предприятиям крайне важно адаптироватьс
 Suno представляет масштабное обновление с расширенным разделением треков и поддержкой автомобилей
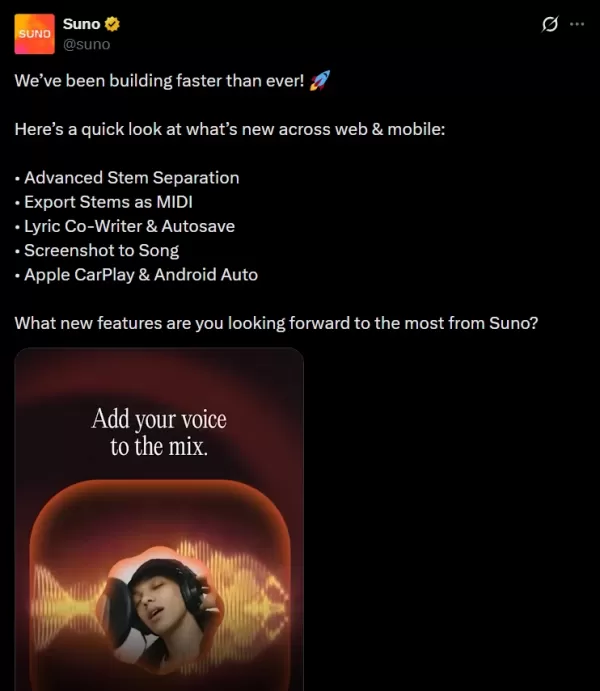
Suno выпустила значительные обновления своей платформы для генерации музыки на основе искусственного интеллекта, улучшив как веб-версию, так и мобильный опыт для упрощения процесса создания контента и повышения удобства использования. Платформа движе
 Жоэль Пино из компании Cohere о суверенном ИИ и корпоративной безопасности
В исследовании IDC, проведенном по заказу компании Cohere, рассматривается тема «суверенного ИИ», а директор по ИИ Жоэль Пино излагает основные стратегии обеспечения безопасности корпоративных облачны
2026 год: лучшие и наиболее высоко оценённые генераторы тестов для ИИ, предназначенные для разработки API и функций. XIX.AI собрал мощный набор инструментов, способных изменить подход к тестированию, которые проходят строгие тесты в реальных условиях для получения точных результатов. Здесь вы найдёте подробные сравнения бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Ознакомьтесь с ними прямо сейчас, чтобы выбрать идеальный инструмент и получить преимущество в тестировании программного обеспечения с использованием ИИ.
7 инструментов
xix.ai
2026 года: самые новые и лучшие генераторы бизнес-планов на базе ИИ с самыми высокими рейтингами — уже здесь, на XIX.AI! В этой тщательно отобранной подборке представлены мощные инструменты, способные кардинально изменить ситуацию и помочь создателям быстро превратить инновационные идеи в отточенные черновые версии презентаций для инвесторов. Здесь вы найдете еженедельно обновляемые рейтинги, сравнительные обзоры бесплатных и платных версий, а также результаты реальных тестов, которые помогут вам выбрать решение, которое обязательно стоит попробовать, чтобы повысить продуктивность и добиться максимальных результатов. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для привлечения финансирования!
11 инструментов
xix.ai
2026: Лучшие современные платформы с ИИ для распознавания счетов-фактур (OCR) для QuickBooks, Xero и сверки данных по нескольким юридическим лицам! XIX.AI составляет рейтинг лучших мощных инструментов, которые проходят точные тесты в реальных условиях и еженедельно обновляются. Эти решения, которые обязательно стоит попробовать, оптимизируют обработку счетов, повышают производительность и экономят время в сложных бизнес-средах. Воспользуйтесь сравнением бесплатных и платных версий, чтобы найти идеальный вариант для себя. Узнайте больше прямо сейчас, чтобы раскрыть все преимущества ИИ!
8 инструментов
xix.ai
2026 год: лучшее программное обеспечение для ответов на заявки в области ИИ, предназначенное для использования в корпоративных процессах подготовки предложений! XIX.AI собрал список самых эффективных инструментов, прошедших строгие тестирования в реальных условиях, и предлагает функции, которые обязательно стоит опробовать для повышения производительности и оптимизации процедур составления предложений. Получите бесплатное сравнение версий с платными, ознакомьтесь с подробным рейтингом и узнайте, как эти инновационные решения помогут вам быстрее создавать качественные ответы. Ознакомьтесь сейчас, чтобы раскрыть потенциал ИИ в вашей работе!
9 инструментов
xix.ai
2026: лучшие и самые популярные инструменты для создания субтитров и дубляжа с ИИ, отобранные специально для локализации видео для международной аудитории. Значительно расширьте охват контента, преодолевая языковые барьеры, благодаря революционной точности. Реальные тесты доказывают, что эти решения, которые обязательно стоит попробовать, позволяют сравнить бесплатные и платные версии и предлагают надежные рейтинги для максимального повышения продуктивности. Изучите их прямо сейчас, чтобы найти идеальный инструмент для распространения контента по всему миру.
10 инструментов
xix.ai
2026: Новейшие и лучшие инструменты на базе ИИ для обработки счетов-фактур, автоматизации учета кредиторской задолженности, маршрутизации утверждений и синхронизации с ERP-системами! XIX.AI отбирает высокооцененные и мощные решения, прошедшие строгие практические испытания, которые позволяют значительно повысить производительность. Получите сравнение бесплатных и платных версий, ознакомьтесь с подробными рейтингами и откройте для себя варианты, которые обязательно стоит попробовать для оптимизации ваших финансовых операций. Узнайте больше прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai












