


 Lar
A iFlytek Xinghuo revela modelo de fala codificador de 0,65B com MoE de 30B, construído sobre poder computacional totalmente nacional
A iFLYTEK lançou o Spark-Audio-1.0-Preview, um modelo de linguagem grande de base para áudio construído inteiramente sobre infraestrutura de computação nacional.
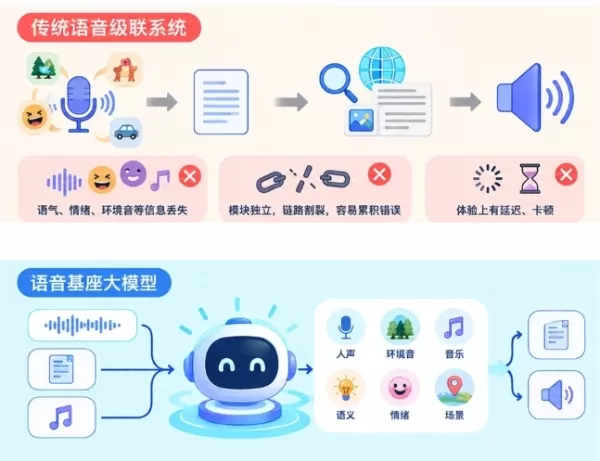
Anteriormente, o processamento de áudio com modelos de linguagem grande dependia de um método em cascata: converter primeiro a fala em texto e, em seguida, passá-lo ao modelo para análise. Essa abordagem apresenta duas falhas principais: perda de informação, pois o texto não consegue capturar tom, emoção e sons de fundo, levando a um contexto incompleto; e fluxos de trabalho fragmentados, nos quais módulos independentes para transcrição, identificação do locutor e tradução operam em série, causando acúmulo de erros, latência e uma experiência de usuário ruim.
Além da transcrição: Compreensão direta da fala
Este modelo de base para áudio vai além da simples transcrição para interpretar diretamente o áudio. Ele pode distinguir vozes humanas, ruído ambiente e música, ao mesmo tempo em que capta semântica, emoções e indicações contextuais presentes no som.
A versão inicial do Spark-Audio-1.0-Preview apresenta um codificador de áudio de 0,65B (estrutura densa) e um modelo de linguagem grande de 30B-A3B (estrutura MoE). Treinado em 13 milhões de horas de áudio e em extensos dados de texto, utilizando um cluster de computação totalmente nacional, o modelo aceita entradas de texto e áudio. Ele suporta tarefas como transcrição de fala, tradução multilíngue, reconhecimento de múltiplos dialetos, identificação de sons ambientais, reconhecimento do locutor, análise de sentimento e perguntas e respostas complexas sobre áudio, permitindo que as máquinas transicionem de "ouvir claramente" para "compreender". Semelhante ao sistema "1+N" do modelo grande Spark da iFLYTEK, os usuários podem ajustar finamente este modelo de base para áudio para criar sistemas especializados para reconhecimento de fala, tradução em tempo real e aplicações interativas de fala.
Suporta 99 idiomas e 202 dialetos, destacando-se em cenários complexos
De acordo com dados oficiais, o Spark-Audio-1.0-Preview tem desempenho comparável ou superior ao dos concorrentes em várias tarefas de avaliação de fala, particularmente em cenários do mundo real desafiadores, como altos níveis de ruído e fala suave. Seu desempenho também está estreitamente alinhado com modelos de base para áudio maiores e de código fechado.
O modelo suporta o reconhecimento de 99 idiomas e 202 dialetos. Ele demonstra desempenho médio superior no reconhecimento de fala multilíngue e multidialeto em comparação com o Qwen3.5-omni-flash (35B-A3B) de tamanho semelhante, e iguala o desempenho do significativamente maior Qwen3.5-omni-plus. Em avaliações como Fleurs, Kespeech e LibriSpeech para reconhecimento de fala chinês-inglesa, multilíngue e multidialeto, ele supera o Gemini-3.1 Pro e alcança o estado da arte (SOTA) no conjunto de testes chinês do Fleurs.
A iFLYTEK reconhece que, embora esta versão mantenha um desempenho forte em tarefas de conhecimento geral, matemática e programação, há espaço para melhoria na execução de instruções, diálogo e compreensão de áudio. As atualizações futuras focarão no fortalecimento dessas áreas. O Spark-Audio-1.0-Preview já está disponível para experiência pública, com acesso à API sendo lançado em breve na Plataforma Aberta da iFLYTEK.
Artigo relacionado
 A Zoho ajuda as empresas a adotarem agentes de IA
O mercado está evoluindo rapidamente em direção a agentes baseados em IAA Zoho destaca que a IA está avançando exponencialmente, tornando crucial que as empresas se adaptem e repensem suas operaçõesO
Suno anuncia atualização importante com separação avançada de faixas e suporte para carros
A Suno lançou atualizações significativas em sua plataforma de geração de música por inteligência artificial, aprimorando as experiências na web e no mobile para simplificar a criação e aumentar a usabilidade. A plataforma avança para um estágio mais
Joëlle Pineau, da Cohere, fala sobre IA soberana e segurança corporativa
Uma pesquisa da IDC encomendada pela Cohere explora a IA soberana, com a diretora de IA, Joëlle Pineau, apresentando estratégias essenciais para a segurança na nuvem corporativa e a governança de dado
Recomendações de tópicos especiais relacionados
código
 Melhores Geradores de Testes de IA: Crie testes unitários para APIs e funções
2026 – Os melhores e mais atualizados geradores de testes de IA com alta classificação, ideais para o desenvolvimento de APIs e funções. A XIX.AI reuniu uma coleção poderosa e revolucionária de ferramentas indispensáveis, que passam por testes rigorosos no mundo real a fim de fornecer resultados precisos. Você encontrará análises detalhadas comparando opções gratuitas e pagas, além de classificações atualizadas semanalmente. Explore agora para encontrar a ferramenta perfeita para você e aproveitar toda a vantagem da IA nos testes de software.
 7 ferramentas
 xix.ai
Negócios
Os melhores geradores de planos de negócios com IA: transforme ideias em rascunhos de apresentações para investidores
Os melhores e mais bem avaliados geradores de planos de negócios com IA de 2026 estão aqui no XIX.AI! Esta coleção cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a transformar ideias inovadoras em rascunhos bem elaborados de apresentações para investidores rapidamente. Você encontrará rankings atualizados semanalmente, análises comparativas entre versões gratuitas e pagas, além de testes práticos para ajudá-lo a escolher a solução imperdível que aumenta a produtividade e oferece os melhores resultados. Explore agora para descobrir a ferramenta perfeita para garantir seu financiamento!
11 ferramentas
xix.ai
Financiar
Plataformas de OCR de notas fiscais com IA para QuickBooks, Xero e reconciliação entre várias entidades
As melhores plataformas de OCR de faturas com IA de 2026 para QuickBooks, Xero e reconciliação entre múltiplas entidades! A XIX.AI seleciona uma lista das melhores ferramentas, que oferecem testes práticos precisos e rankings atualizados semanalmente. Essas soluções imperdíveis otimizam o processamento de faturas, aumentam a produtividade e economizam tempo em estruturas empresariais complexas. Confira uma comparação entre versões gratuitas e pagas para encontrar a opção ideal para você. Explore agora e descubra sua vantagem com IA!
8 ferramentas
xix.ai
Negócios
Software de resposta a solicitações de propostas (RFP) com IA para fluxos de trabalho de propostas corporativas
2026: Os melhores e mais recentes softwares de resposta a RFPs com IA para fluxos de trabalho de propostas corporativas! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas e poderosas, que passam por rigorosos testes na prática, oferecendo recursos imperdíveis para aumentar a produtividade e otimizar seus processos de elaboração de propostas. Veja uma comparação entre versões gratuitas e pagas, confira rankings detalhados e descubra como essas soluções revolucionárias podem ajudá-lo a criar respostas de alta qualidade com mais rapidez. Explore agora para aproveitar toda a vantagem da IA!
9 ferramentas
xix.ai
Criação de vídeo
Ferramentas de legenda e dublagem com IA: localize vídeos para públicos globais
As melhores e mais bem avaliadas ferramentas de legendagem e dublagem com IA de 2026, selecionadas para a localização de vídeos para públicos globais. Amplie significativamente o alcance do seu conteúdo além das barreiras linguísticas com uma precisão revolucionária. Testes práticos comprovam que essas soluções imperdíveis oferecem comparações entre versões gratuitas e pagas, além de classificações confiáveis para maximizar a produtividade. Explore agora e descubra a ferramenta perfeita para a distribuição global de conteúdo.
10 ferramentas
xix.ai
automação
Ferramentas de processamento de notas fiscais com IA para automação do controle de contas a pagar, roteamento de aprovação e fluxos de trabalho de sincronização com o ERP
As melhores e mais recentes ferramentas de processamento de notas fiscais com IA de 2026 para automação de contas a pagar, roteamento de aprovação e fluxos de trabalho de sincronização com ERP! A XIX.AI seleciona soluções poderosas e com as melhores avaliações, que passam por rigorosos testes em condições reais para aumentar drasticamente a produtividade. Veja uma comparação entre versões gratuitas e pagas, confira classificações detalhadas e descubra opções imperdíveis para otimizar suas operações financeiras. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

 Comentários (0)
A iFLYTEK lançou o Spark-Audio-1.0-Preview, um modelo de linguagem grande de base para áudio construído inteiramente sobre infraestrutura de computação nacional.
Anteriormente, o processamento de áudio com modelos de linguagem grande dependia de um método em cascata: converter primeiro a fala em texto e, em seguida, passá-lo ao modelo para análise. Essa abordagem apresenta duas falhas principais: perda de informação, pois o texto não consegue capturar tom, emoção e sons de fundo, levando a um contexto incompleto; e fluxos de trabalho fragmentados, nos quais módulos independentes para transcrição, identificação do locutor e tradução operam em série, causando acúmulo de erros, latência e uma experiência de usuário ruim.
Além da transcrição: Compreensão direta da fala
Este modelo de base para áudio vai além da simples transcrição para interpretar diretamente o áudio. Ele pode distinguir vozes humanas, ruído ambiente e música, ao mesmo tempo em que capta semântica, emoções e indicações contextuais presentes no som.
A versão inicial do Spark-Audio-1.0-Preview apresenta um codificador de áudio de 0,65B (estrutura densa) e um modelo de linguagem grande de 30B-A3B (estrutura MoE). Treinado em 13 milhões de horas de áudio e em extensos dados de texto, utilizando um cluster de computação totalmente nacional, o modelo aceita entradas de texto e áudio. Ele suporta tarefas como transcrição de fala, tradução multilíngue, reconhecimento de múltiplos dialetos, identificação de sons ambientais, reconhecimento do locutor, análise de sentimento e perguntas e respostas complexas sobre áudio, permitindo que as máquinas transicionem de "ouvir claramente" para "compreender". Semelhante ao sistema "1+N" do modelo grande Spark da iFLYTEK, os usuários podem ajustar finamente este modelo de base para áudio para criar sistemas especializados para reconhecimento de fala, tradução em tempo real e aplicações interativas de fala.
Suporta 99 idiomas e 202 dialetos, destacando-se em cenários complexos
De acordo com dados oficiais, o Spark-Audio-1.0-Preview tem desempenho comparável ou superior ao dos concorrentes em várias tarefas de avaliação de fala, particularmente em cenários do mundo real desafiadores, como altos níveis de ruído e fala suave. Seu desempenho também está estreitamente alinhado com modelos de base para áudio maiores e de código fechado.
O modelo suporta o reconhecimento de 99 idiomas e 202 dialetos. Ele demonstra desempenho médio superior no reconhecimento de fala multilíngue e multidialeto em comparação com o Qwen3.5-omni-flash (35B-A3B) de tamanho semelhante, e iguala o desempenho do significativamente maior Qwen3.5-omni-plus. Em avaliações como Fleurs, Kespeech e LibriSpeech para reconhecimento de fala chinês-inglesa, multilíngue e multidialeto, ele supera o Gemini-3.1 Pro e alcança o estado da arte (SOTA) no conjunto de testes chinês do Fleurs.
A iFLYTEK reconhece que, embora esta versão mantenha um desempenho forte em tarefas de conhecimento geral, matemática e programação, há espaço para melhoria na execução de instruções, diálogo e compreensão de áudio. As atualizações futuras focarão no fortalecimento dessas áreas. O Spark-Audio-1.0-Preview já está disponível para experiência pública, com acesso à API sendo lançado em breve na Plataforma Aberta da iFLYTEK.








 A Zoho ajuda as empresas a adotarem agentes de IA
O mercado está evoluindo rapidamente em direção a agentes baseados em IAA Zoho destaca que a IA está avançando exponencialmente, tornando crucial que as empresas se adaptem e repensem suas operaçõesO
 Suno anuncia atualização importante com separação avançada de faixas e suporte para carros
A Suno lançou atualizações significativas em sua plataforma de geração de música por inteligência artificial, aprimorando as experiências na web e no mobile para simplificar a criação e aumentar a usabilidade. A plataforma avança para um estágio mais
 Joëlle Pineau, da Cohere, fala sobre IA soberana e segurança corporativa
Uma pesquisa da IDC encomendada pela Cohere explora a IA soberana, com a diretora de IA, Joëlle Pineau, apresentando estratégias essenciais para a segurança na nuvem corporativa e a governança de dado
2026 – Os melhores e mais atualizados geradores de testes de IA com alta classificação, ideais para o desenvolvimento de APIs e funções. A XIX.AI reuniu uma coleção poderosa e revolucionária de ferramentas indispensáveis, que passam por testes rigorosos no mundo real a fim de fornecer resultados precisos. Você encontrará análises detalhadas comparando opções gratuitas e pagas, além de classificações atualizadas semanalmente. Explore agora para encontrar a ferramenta perfeita para você e aproveitar toda a vantagem da IA nos testes de software.
7 ferramentas
xix.ai
Os melhores e mais bem avaliados geradores de planos de negócios com IA de 2026 estão aqui no XIX.AI! Esta coleção cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a transformar ideias inovadoras em rascunhos bem elaborados de apresentações para investidores rapidamente. Você encontrará rankings atualizados semanalmente, análises comparativas entre versões gratuitas e pagas, além de testes práticos para ajudá-lo a escolher a solução imperdível que aumenta a produtividade e oferece os melhores resultados. Explore agora para descobrir a ferramenta perfeita para garantir seu financiamento!
11 ferramentas
xix.ai
As melhores plataformas de OCR de faturas com IA de 2026 para QuickBooks, Xero e reconciliação entre múltiplas entidades! A XIX.AI seleciona uma lista das melhores ferramentas, que oferecem testes práticos precisos e rankings atualizados semanalmente. Essas soluções imperdíveis otimizam o processamento de faturas, aumentam a produtividade e economizam tempo em estruturas empresariais complexas. Confira uma comparação entre versões gratuitas e pagas para encontrar a opção ideal para você. Explore agora e descubra sua vantagem com IA!
8 ferramentas
xix.ai
2026: Os melhores e mais recentes softwares de resposta a RFPs com IA para fluxos de trabalho de propostas corporativas! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas e poderosas, que passam por rigorosos testes na prática, oferecendo recursos imperdíveis para aumentar a produtividade e otimizar seus processos de elaboração de propostas. Veja uma comparação entre versões gratuitas e pagas, confira rankings detalhados e descubra como essas soluções revolucionárias podem ajudá-lo a criar respostas de alta qualidade com mais rapidez. Explore agora para aproveitar toda a vantagem da IA!
9 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de legendagem e dublagem com IA de 2026, selecionadas para a localização de vídeos para públicos globais. Amplie significativamente o alcance do seu conteúdo além das barreiras linguísticas com uma precisão revolucionária. Testes práticos comprovam que essas soluções imperdíveis oferecem comparações entre versões gratuitas e pagas, além de classificações confiáveis para maximizar a produtividade. Explore agora e descubra a ferramenta perfeita para a distribuição global de conteúdo.
10 ferramentas
xix.ai
As melhores e mais recentes ferramentas de processamento de notas fiscais com IA de 2026 para automação de contas a pagar, roteamento de aprovação e fluxos de trabalho de sincronização com ERP! A XIX.AI seleciona soluções poderosas e com as melhores avaliações, que passam por rigorosos testes em condições reais para aumentar drasticamente a produtividade. Veja uma comparação entre versões gratuitas e pagas, confira classificações detalhadas e descubra opções imperdíveis para otimizar suas operações financeiras. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai












