


 집
iFlytek Xinghuo, 30B MoE 기반의 0.65B 인코더 음성 모델을 공개했으며, 이는 완전히 국내산 컴퓨팅 파워를 기반으로 구축되었습니다.
iFLYTEK은 국내 컴퓨팅 인프라를 완전히 기반으로 구축된 음성 기반 대형 모델인 Spark-Audio-1.0-Preview를 출시했습니다.
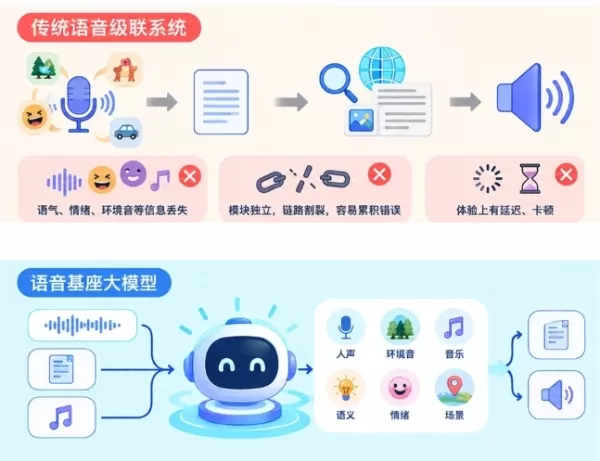
이전에는 대형 모델을 활용한 음성 처리가 연쇄적 방식을 의존했습니다. 즉, 음성을 텍스트로 변환한 후 이를 모델에 전달하여 분석하는 방식이었습니다. 이 접근 방식은 두 가지 주요 결함을 안고 있습니다. 첫째, 정보 손실로 인해 텍스트가 어조, 감정, 배경 소리 등을 포착하지 못해 맥락이 불완전해집니다. 둘째, 전사, 화자 ID, 번역을 위한 독립적인 모듈이 순차적으로 실행되는 파편화된 워크플로우로 인해 오류가 누적되고 지연 시간이 발생하며 사용자 경험이 저하됩니다.
전사를 넘어: 직접적인 음성 이해
이 음성 기반 대형 모델은 단순 전사를 넘어 음성을 직접 해석합니다. 인간의 목소리, 환경 소음, 음악을 구분할 수 있으며, 소리 내의 의미, 감정, 맥락적 단서를 파악합니다.
초기 버전인 Spark-Audio-1.0-Preview는 0.65B 오디오 인코더(밀집 구조)와 30B-A3B 대형 언어 모델(MoE 구조)을 특징으로 합니다. 완전히 국내 컴퓨팅 클러스터를 사용하여 1,300만 시간의 오디오와 방대한 텍스트 데이터로 학습된 이 모델은 텍스트와 오디오 입력을 모두 수용합니다. 음성 전사, 다국어 번역, 다방언 인식, 환경 소리 식별, 화자 인식, 감정 분석, 복잡한 오디오 Q&A 등의 작업을 지원하며, 기계가 '명확히 듣는' 단계에서 '이해하는' 단계로 전환할 수 있도록 합니다. iFLYTEK의 스파크 대형 모델 '1+N' 시스템과 유사하게, 사용자는 이 음성 기반 모델을 파인튜닝하여 음성 인식, 실시간 번역, 대화형 음성 애플리케이션을 위한 전용 시스템을 구축할 수 있습니다.
99개 언어와 202개 방언을 지원하며, 복잡한 시나리오에서 뛰어난 성능 발휘
공식 데이터에 따르면, Spark-Audio-1.0-Preview는 다양한 음성 평가 작업에서 경쟁사들과 비교하거나 더 우수한 성능을 보이며, 특히 높은 소음 수준과 낮은 음성 출력과 같은 실제 환경에서 어려운 시나리오에서 두각을 나타냅니다. 그 성능은 더 크고 폐쇄형 음성 기반 대형 모델과도 밀접하게 일치합니다.
이 모델은 99개 언어와 202개 방언을 인식할 수 있습니다. 유사한 크기의 Qwen3.5-omni-flash(35B-A3B)에 비해 다국어 및 다방언 음성 인식에서 평균적으로 더 우수한 성능을 보여주며, 훨씬 더 큰 Qwen3.5-omni-plus의 성능과 맞먹습니다. 중국어-영어, 다국어, 다방언 음성 인식을 위한 Fleurs, Kespeech, LibriSpeech와 같은 평가에서 Gemini-3.1 Pro를 능가하며, Fleurs 중국어 테스트 세트에서 SOTA를 달성합니다.
iFLYTEK은 이 버전이 일반 지식, 수학, 코딩 작업에서 강력한 성능을 유지하지만, 지시 따르기, 대화, 오디오 이해 측면에서는 개선의 여지가 있음을 인정합니다. 향후 업데이트는 이러한 영역을 강화하는 데 중점을 둘 것입니다. Spark-Audio-1.0-Preview는 이제 공개 체험이 가능하며, 곧 iFLYTEK 오픈 플랫폼을 통해 API 접근이 제공될 예정입니다.
관련 기사
 Suno, 고급 트랙 분리 및 차량 지원 기능을 갖춘 주요 업데이트를 공개합니다
Suno는 AI 음악 생성 플랫폼에 상당한 업데이트를 적용하여 웹 및 모바일 경험을 모두 향상시켜 창작을 간소화하고 사용성을 높였습니다. 이 플랫폼은 AI 기반 음악 제작을 위해 더 접근하기 쉽고 효율적인 단계로 나아가고 있으며, 전문 오디오 도구를 운전과 같은 일상적인 시나리오와 통합하고 있습니다.향상된 스템 분리이번 업데이트의 핵심 하이라이트는 고급 스템 분리 기능으로, 보컬, 드럼, 베이스, 악기를 개별 트랙으로 분리합니다. 이 기능은 음
코히어(Cohere)의 조엘 피노(Joëlle Pineau), 주권형 AI와 기업 보안에 대해
Cohere가 의뢰한 IDC 연구에서는 주권형 AI를 심층적으로 다루었으며, 최고 AI 책임자(CIO)인 조엘 피노(Joëlle Pineau)는 기업 클라우드 보안 및 데이터 거버넌스를 위한 핵심 전략을 제시했다.AI 기업 코히어(Cohere)가 의뢰한 IDC 보고서 『2026년 주권형 AI 도입 현황(The State of Sovereign AI Adop
Anthropic의 수출 금지 조치가 계속되는 가운데 아시아의 AI 스타트업들이 Mythos와 유사한 모델을 공개하고 있다
수요일, 중국의 사이버 보안 기업 360이 앤트로픽의 마이토스와 직접 경쟁할 수 있는 AI 도구인 투룽펑(Tulongfeng)을 공개했다고 보도되었다. 이는 사이버 보안에 특화된 AI 모델로, 그 강력함 때문에 트럼프 행정부가 현재 비미국인들에게 마이토스와 더 제한된 버전인 페이블 5(Fable 5)의 사용을 금지하고 있다.같은 주 초반, 도쿄 기반 AI 스타트업 사카나 AI(Sakana AI)는 복어(blowfish)를 뜻하는 일본어에서 이
관련 특별 주제 추천
암호
 최고의 AI 테스트 생성기: API 및 함수용 단위 테스트 작성
2026년 최신의 우수하고 높은 평점을 받은 API 및 함수 개발용 AI 테스트 생성 도구들입니다. XIX.AI는 엄격한 실제 환경 테스트를 거쳐 정확한 결과를 제공하는, 반드시 사용해 볼 만한 강력하고 혁신적인 도구들을 선별하여 제공합니다. 무료 버전과 유료 버전의 상세 비교 분석 자료와 매주 업데이트되는 순위 정보도 확인할 수 있습니다. 지금 바로 살펴보시고 소프트웨어 테스트 분야에서 최적의 도구를 찾아 AI 기반의 경쟁 우위를 확보해 보세요.
 7 도구
 xix.ai
사업
최고의 AI 사업 계획서 작성 도구: 아이디어를 투자자 프레젠테이션 초안으로 구현하세요
2026년 최신 최고 평점을 받은 AI 사업 계획서 생성기들이 XIX.AI에 모였습니다! 이 엄선된 컬렉션에는 크리에이터들이 혁신적인 아이디어를 신속하게 완성도 높은 투자자 프레젠테이션 초안으로 다듬을 수 있도록 도와주는, 판도를 바꿀 만한 강력한 도구들이 포함되어 있습니다. 매주 업데이트되는 순위, 무료와 유료 버전의 비교 분석, 실제 테스트 결과를 통해 생산성을 높이고 최고의 성과를 거둘 수 있는 ‘꼭 사용해봐야 할’ 솔루션을 선택하실 수 있습니다. 지금 바로 살펴보고 자금 조달을 위한 완벽한 도구를 찾아보세요!
11 도구
xix.ai
재원
QuickBooks, Xero 및 다중 법인 계정 조정용 AI 송장 OCR 플랫폼
2026년 최신 최고의 AI 청구서 OCR 플랫폼: QuickBooks, Xero 및 다중 법인 계정 조정용! XIX.AI는 정확한 실전 테스트와 매주 업데이트되는 순위를 바탕으로 최고 평점을 받은 강력한 도구 목록을 엄선합니다. 이 꼭 사용해봐야 할 솔루션들은 복잡한 비즈니스 환경 전반에서 청구서 처리 과정을 간소화하고, 생산성을 높이며, 시간을 절약해 줍니다. 무료 버전과 유료 버전을 비교해 보시고 귀사에 가장 적합한 솔루션을 찾아보세요. 지금 바로 살펴보고 AI의 경쟁력을 확보하세요!
8 도구
xix.ai
사업
기업 제안서 작업 흐름을 위한 AI RFP 응답 소프트웨어
2026년 최신의 기업 제안서 작성을 위한 최고의 AI RFP 응답 소프트웨어! XIX.AI는 엄격한 실제 환경 테스트를 통과한 우수한 도구들을 엄선하여 제공하며, 생산성을 향상시키고 제안서 작성 과정을 간소화해 주는 유용한 기능들을 선보입니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 상세한 순위를 살펴보며, 이러한 혁신적인 솔루션이 어떻게 더 빠르고 고품질의 응답문을 작성하는 데 도움을 주는지 알아보세요. 지금 바로 확인하여 AI를 활용한 경쟁 우위를 확보해 보세요!
9 도구
xix.ai
비디오 제작
AI 자막 및 더빙 도구: 전 세계 시청자를 위한 동영상 현지화
2026년 최신 최고 평점을 받은 AI 자막 및 더빙 도구 모음: 전 세계 시청자를 위한 동영상 현지화를 위해 엄선된 솔루션. 획기적인 정확도로 언어 장벽을 넘어 콘텐츠의 도달 범위를 강력하게 확대하세요. 실제 테스트를 통해 검증된 이 필수 솔루션들은 무료와 유료 버전의 비교 정보 및 신뢰할 수 있는 순위를 제공하여 생산성을 극대화합니다. 지금 바로 살펴보고 글로벌 콘텐츠 배포에 최적화된 도구를 찾아보세요.
10 도구
xix.ai
오토메이션
AP 자동화, 승인 경로 설정 및 ERP 동기화 워크플로우를 위한 AI 기반 청구서 처리 도구
2026년 최신 최고의 AI 청구서 처리 도구: AP 자동화, 승인 경로 설정 및 ERP 동기화 워크플로우를 위한 솔루션! XIX.AI는 엄격한 실전 테스트를 통과한 최고 평점을 받은 강력한 솔루션을 엄선하여 생산성을 획기적으로 높여드립니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 상세한 순위 정보를 살펴보며, 재무 운영을 효율화할 필수 옵션을 찾아보세요. 지금 바로 탐색하여 AI의 경쟁력을 확보하세요!
9 도구
xix.ai

 의견 (0)
0/500
iFLYTEK은 국내 컴퓨팅 인프라를 완전히 기반으로 구축된 음성 기반 대형 모델인 Spark-Audio-1.0-Preview를 출시했습니다.
이전에는 대형 모델을 활용한 음성 처리가 연쇄적 방식을 의존했습니다. 즉, 음성을 텍스트로 변환한 후 이를 모델에 전달하여 분석하는 방식이었습니다. 이 접근 방식은 두 가지 주요 결함을 안고 있습니다. 첫째, 정보 손실로 인해 텍스트가 어조, 감정, 배경 소리 등을 포착하지 못해 맥락이 불완전해집니다. 둘째, 전사, 화자 ID, 번역을 위한 독립적인 모듈이 순차적으로 실행되는 파편화된 워크플로우로 인해 오류가 누적되고 지연 시간이 발생하며 사용자 경험이 저하됩니다.
전사를 넘어: 직접적인 음성 이해
이 음성 기반 대형 모델은 단순 전사를 넘어 음성을 직접 해석합니다. 인간의 목소리, 환경 소음, 음악을 구분할 수 있으며, 소리 내의 의미, 감정, 맥락적 단서를 파악합니다.
초기 버전인 Spark-Audio-1.0-Preview는 0.65B 오디오 인코더(밀집 구조)와 30B-A3B 대형 언어 모델(MoE 구조)을 특징으로 합니다. 완전히 국내 컴퓨팅 클러스터를 사용하여 1,300만 시간의 오디오와 방대한 텍스트 데이터로 학습된 이 모델은 텍스트와 오디오 입력을 모두 수용합니다. 음성 전사, 다국어 번역, 다방언 인식, 환경 소리 식별, 화자 인식, 감정 분석, 복잡한 오디오 Q&A 등의 작업을 지원하며, 기계가 '명확히 듣는' 단계에서 '이해하는' 단계로 전환할 수 있도록 합니다. iFLYTEK의 스파크 대형 모델 '1+N' 시스템과 유사하게, 사용자는 이 음성 기반 모델을 파인튜닝하여 음성 인식, 실시간 번역, 대화형 음성 애플리케이션을 위한 전용 시스템을 구축할 수 있습니다.
99개 언어와 202개 방언을 지원하며, 복잡한 시나리오에서 뛰어난 성능 발휘
공식 데이터에 따르면, Spark-Audio-1.0-Preview는 다양한 음성 평가 작업에서 경쟁사들과 비교하거나 더 우수한 성능을 보이며, 특히 높은 소음 수준과 낮은 음성 출력과 같은 실제 환경에서 어려운 시나리오에서 두각을 나타냅니다. 그 성능은 더 크고 폐쇄형 음성 기반 대형 모델과도 밀접하게 일치합니다.
이 모델은 99개 언어와 202개 방언을 인식할 수 있습니다. 유사한 크기의 Qwen3.5-omni-flash(35B-A3B)에 비해 다국어 및 다방언 음성 인식에서 평균적으로 더 우수한 성능을 보여주며, 훨씬 더 큰 Qwen3.5-omni-plus의 성능과 맞먹습니다. 중국어-영어, 다국어, 다방언 음성 인식을 위한 Fleurs, Kespeech, LibriSpeech와 같은 평가에서 Gemini-3.1 Pro를 능가하며, Fleurs 중국어 테스트 세트에서 SOTA를 달성합니다.
iFLYTEK은 이 버전이 일반 지식, 수학, 코딩 작업에서 강력한 성능을 유지하지만, 지시 따르기, 대화, 오디오 이해 측면에서는 개선의 여지가 있음을 인정합니다. 향후 업데이트는 이러한 영역을 강화하는 데 중점을 둘 것입니다. Spark-Audio-1.0-Preview는 이제 공개 체험이 가능하며, 곧 iFLYTEK 오픈 플랫폼을 통해 API 접근이 제공될 예정입니다.








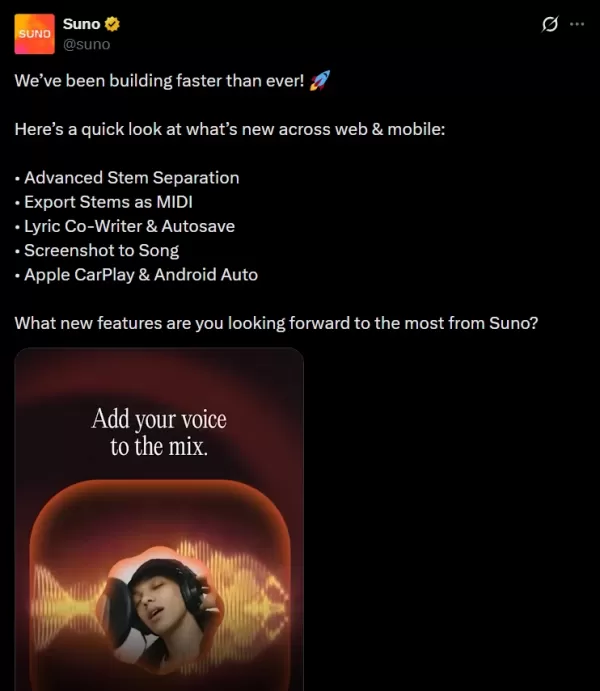 Suno, 고급 트랙 분리 및 차량 지원 기능을 갖춘 주요 업데이트를 공개합니다
Suno는 AI 음악 생성 플랫폼에 상당한 업데이트를 적용하여 웹 및 모바일 경험을 모두 향상시켜 창작을 간소화하고 사용성을 높였습니다. 이 플랫폼은 AI 기반 음악 제작을 위해 더 접근하기 쉽고 효율적인 단계로 나아가고 있으며, 전문 오디오 도구를 운전과 같은 일상적인 시나리오와 통합하고 있습니다.향상된 스템 분리이번 업데이트의 핵심 하이라이트는 고급 스템 분리 기능으로, 보컬, 드럼, 베이스, 악기를 개별 트랙으로 분리합니다. 이 기능은 음
 코히어(Cohere)의 조엘 피노(Joëlle Pineau), 주권형 AI와 기업 보안에 대해
Cohere가 의뢰한 IDC 연구에서는 주권형 AI를 심층적으로 다루었으며, 최고 AI 책임자(CIO)인 조엘 피노(Joëlle Pineau)는 기업 클라우드 보안 및 데이터 거버넌스를 위한 핵심 전략을 제시했다.AI 기업 코히어(Cohere)가 의뢰한 IDC 보고서 『2026년 주권형 AI 도입 현황(The State of Sovereign AI Adop
 Anthropic의 수출 금지 조치가 계속되는 가운데 아시아의 AI 스타트업들이 Mythos와 유사한 모델을 공개하고 있다
수요일, 중국의 사이버 보안 기업 360이 앤트로픽의 마이토스와 직접 경쟁할 수 있는 AI 도구인 투룽펑(Tulongfeng)을 공개했다고 보도되었다. 이는 사이버 보안에 특화된 AI 모델로, 그 강력함 때문에 트럼프 행정부가 현재 비미국인들에게 마이토스와 더 제한된 버전인 페이블 5(Fable 5)의 사용을 금지하고 있다.같은 주 초반, 도쿄 기반 AI 스타트업 사카나 AI(Sakana AI)는 복어(blowfish)를 뜻하는 일본어에서 이
2026년 최신의 우수하고 높은 평점을 받은 API 및 함수 개발용 AI 테스트 생성 도구들입니다. XIX.AI는 엄격한 실제 환경 테스트를 거쳐 정확한 결과를 제공하는, 반드시 사용해 볼 만한 강력하고 혁신적인 도구들을 선별하여 제공합니다. 무료 버전과 유료 버전의 상세 비교 분석 자료와 매주 업데이트되는 순위 정보도 확인할 수 있습니다. 지금 바로 살펴보시고 소프트웨어 테스트 분야에서 최적의 도구를 찾아 AI 기반의 경쟁 우위를 확보해 보세요.
7 도구
xix.ai
2026년 최신 최고 평점을 받은 AI 사업 계획서 생성기들이 XIX.AI에 모였습니다! 이 엄선된 컬렉션에는 크리에이터들이 혁신적인 아이디어를 신속하게 완성도 높은 투자자 프레젠테이션 초안으로 다듬을 수 있도록 도와주는, 판도를 바꿀 만한 강력한 도구들이 포함되어 있습니다. 매주 업데이트되는 순위, 무료와 유료 버전의 비교 분석, 실제 테스트 결과를 통해 생산성을 높이고 최고의 성과를 거둘 수 있는 ‘꼭 사용해봐야 할’ 솔루션을 선택하실 수 있습니다. 지금 바로 살펴보고 자금 조달을 위한 완벽한 도구를 찾아보세요!
11 도구
xix.ai
2026년 최신 최고의 AI 청구서 OCR 플랫폼: QuickBooks, Xero 및 다중 법인 계정 조정용! XIX.AI는 정확한 실전 테스트와 매주 업데이트되는 순위를 바탕으로 최고 평점을 받은 강력한 도구 목록을 엄선합니다. 이 꼭 사용해봐야 할 솔루션들은 복잡한 비즈니스 환경 전반에서 청구서 처리 과정을 간소화하고, 생산성을 높이며, 시간을 절약해 줍니다. 무료 버전과 유료 버전을 비교해 보시고 귀사에 가장 적합한 솔루션을 찾아보세요. 지금 바로 살펴보고 AI의 경쟁력을 확보하세요!
8 도구
xix.ai
2026년 최신의 기업 제안서 작성을 위한 최고의 AI RFP 응답 소프트웨어! XIX.AI는 엄격한 실제 환경 테스트를 통과한 우수한 도구들을 엄선하여 제공하며, 생산성을 향상시키고 제안서 작성 과정을 간소화해 주는 유용한 기능들을 선보입니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 상세한 순위를 살펴보며, 이러한 혁신적인 솔루션이 어떻게 더 빠르고 고품질의 응답문을 작성하는 데 도움을 주는지 알아보세요. 지금 바로 확인하여 AI를 활용한 경쟁 우위를 확보해 보세요!
9 도구
xix.ai
2026년 최신 최고 평점을 받은 AI 자막 및 더빙 도구 모음: 전 세계 시청자를 위한 동영상 현지화를 위해 엄선된 솔루션. 획기적인 정확도로 언어 장벽을 넘어 콘텐츠의 도달 범위를 강력하게 확대하세요. 실제 테스트를 통해 검증된 이 필수 솔루션들은 무료와 유료 버전의 비교 정보 및 신뢰할 수 있는 순위를 제공하여 생산성을 극대화합니다. 지금 바로 살펴보고 글로벌 콘텐츠 배포에 최적화된 도구를 찾아보세요.
10 도구
xix.ai
2026년 최신 최고의 AI 청구서 처리 도구: AP 자동화, 승인 경로 설정 및 ERP 동기화 워크플로우를 위한 솔루션! XIX.AI는 엄격한 실전 테스트를 통과한 최고 평점을 받은 강력한 솔루션을 엄선하여 생산성을 획기적으로 높여드립니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 상세한 순위 정보를 살펴보며, 재무 운영을 효율화할 필수 옵션을 찾아보세요. 지금 바로 탐색하여 AI의 경쟁력을 확보하세요!
9 도구
xix.ai












