


 Heim
iFlytek Xinghuo stellt 0,65B Encoder-Sprachmodell mit 30B MoE vor, basierend auf vollständig inländischer Rechenleistung
iFLYTEK hat Spark-Audio-1.0-Preview vorgestellt, ein sprachbasiertes großes Grundmodell, das vollständig auf inländischer Recheninfrastruktur aufgebaut ist.
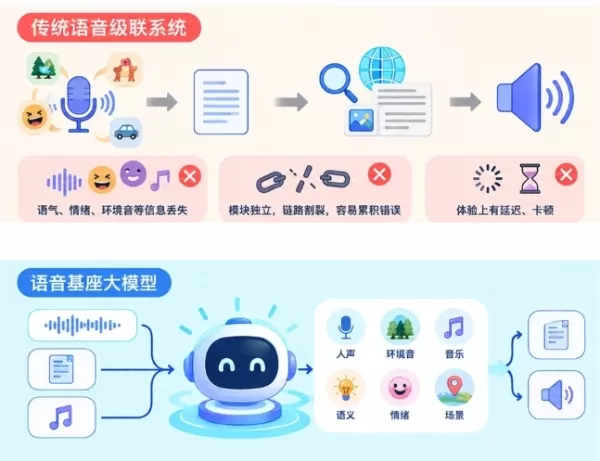
Bisherige Audioverarbeitung mit großen Modellen beruhte auf einer Kaskadenmethode: Zuerst wurde Sprache in Text umgewandelt und dann an das Modell zur Analyse übergeben. Dieser Ansatz weist zwei schwerwiegende Mängel auf: Informationsverlust, da Text Tonfall, Emotionen und Hintergrundgeräusche nicht erfassen kann, was zu einem unvollständigen Kontext führt; sowie fragmentierte Arbeitsabläufe, bei denen unabhängige Module für Transkription, Sprechererkennung und Übersetzung nacheinander ausgeführt werden, was zu Fehlerakkumulation, Latenz und einer schlechten Benutzererfahrung führt.
Über Transkription hinaus: Direktes Sprachverständnis
Dieses sprachbasierte Grundmodell geht über einfache Transkription hinaus und interpretiert Audio direkt. Es kann menschliche Stimmen, Umgebungsgeräusche und Musik unterscheiden sowie Semantik, Emotionen und kontextuelle Hinweise innerhalb des Tons erfassen.
Die erste Version von Spark-Audio-1.0-Preview verfügt über einen 0,65B-Audioencoder (Dichte Struktur) und ein 30B-A3B-großes Sprachmodell (MoE-Struktur). Geschult mit 13 Millionen Stunden Audio und umfangreichen Textdaten auf einem vollständig inländischen Rechencluster, akzeptiert das Modell sowohl Text- als auch Audioeingaben. Es unterstützt Aufgaben wie Sprachtranskription, mehrsprachige Übersetzung, Mehrdialekterkennung, Umgebungsgeräuschidentifikation, Sprechererkennung, Stimmungsanalyse und komplexe Audio-Fragen-Antworten, wodurch Maschinen vom „klaren Hören“ zum „Verstehen“ übergehen können. Ähnlich wie bei iFLYTEKs großem Sprachmodell „1+N“-System können Benutzer dieses sprachbasierte Grundmodell feinabstimmen, um spezialisierte Systeme für Spracherkennung, Echtzeitübersetzung und interaktive Sprachanwendungen zu erstellen.
Unterstützt 99 Sprachen und 202 Dialekte, hervorragend in komplexen Szenarien
L offiziellen Daten liefert Spark-Audio-1.0-Preview vergleichbare oder bessere Ergebnisse als Wettbewerber bei verschiedenen Sprachbewertungsaufgaben, insbesondere in herausfordernden realen Szenarien wie hohen Geräuschpegeln und leiser Sprache. Seine Leistung steht auch in engem Zusammenhang mit größeren, geschlossenen sprachbasierten Grundmodellen.
Das Modell unterstützt die Erkennung von 99 Sprachen und 202 Dialekten. Es zeigt eine überlegene durchschnittliche Leistung bei der mehrsprachigen und mehrdialektalen Spracherkennung im Vergleich zum ähnlich großen Qwen3.5-omni-flash (35B-A3B) und entspricht der Leistung des deutlich größeren Qwen3.5-omni-plus. In Bewertungen wie Fleurs, Kespeech und LibriSpeech für Chinesisch-Englisch, Mehrsprachigkeit und Mehrdialekt-Spracherkennung übertrifft es Gemini-3.1 Pro und erzielt SOTA auf dem Fleurs-Chinesisch-Testset.
iFLYTEK räumt ein, dass diese Version zwar starke Leistungen bei allgemeinen Wissens-, Mathematik- und Codierungsaufgaben aufweist, es jedoch Verbesserungspotenzial bei der Befolgung von Anweisungen, Dialogen und dem Audioverständnis gibt. Zukünftige Updates werden sich auf die Stärkung dieser Bereiche konzentrieren. Spark-Audio-1.0-Preview ist jetzt für öffentliche Erfahrungen verfügbar, wobei der API-Zugriff bald auf der iFLYTEK Open Platform freigegeben wird.
Verwandter Artikel
 Suno stellt ein großes Update mit erweiterter Track-Trennung und Fahrzeugunterstützung vor
Suno hat erhebliche Updates für seine KI-Musikgenerierungsplattform veröffentlicht, die sowohl das Web- als auch das mobile Erlebnis verbessern, um die Erstellung zu vereinfachen und die Benutzerfreundlichkeit zu steigern. Die Plattform schreitet vor
Joëlle Pineau von Cohere über souveräne KI und Unternehmenssicherheit
Eine von Cohere in Auftrag gegebene IDC-Studie befasst sich mit „Sovereign AI“, wobei Chief AI Officer Joëlle Pineau wesentliche Strategien für die Cloud-Sicherheit und Daten-Governance in Unternehmen
Asiatische KI-Startups stellen Mythos-ähnliche Modelle vor, während das Exportverbot von Anthropic weiterhin gilt
Am Mittwoch berichtete das chinesische Cybersicherheitsunternehmen 360, es habe Tulongfeng vorgestellt, ein KI-Tool, das nach eigenen Angaben direkt mit Anthrims Mythos konkurrieren kann. Dabei handelt es sich um das auf Cybersicherheit spezialisiert
Empfehlungen zu verwandten Spezialthemen
Code
 Die besten AI-Testgeneratoren: Erstellen Sie Einheitstests für APIs und Funktionen
Die neuesten, besten und am höchsten bewerteten AI-Testgeneratoren für die Entwicklung von APIs und Funktionen im Jahr 2026. XIX.AI hat eine leistungsstarke Auswahl an unverzichtbaren Tools zusammengestellt, die durch strenge Tests in der Praxis gegangen sind, um präzise Ergebnisse zu liefern. Sie finden detaillierte Vergleichsanalysen zu kostenlosen und kostenpflichtigen Optionen sowie wöchentlich aktualisierte Ranglisten. Entdecken Sie jetzt das perfekte Tool für Ihre Bedürfnisse und sichern Sie sich einen Vorteil im Softwaretesting durch KI.
 7 Tools
 xix.ai
Geschäft
Die besten KI-Generatoren für Geschäftspläne: Verwandeln Sie Ideen in Entwürfe für Investorenpräsentationen
Die besten und am besten bewerteten KI-Tools zur Erstellung von Geschäftsplänen für das Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, mit denen Entwickler innovative Ideen schnell in ausgefeilte Entwürfe für Investorenpräsentationen umsetzen können. Hier finden Sie wöchentlich aktualisierte Rankings, Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests, die Ihnen dabei helfen, die Lösung zu finden, die Sie unbedingt ausprobieren sollten, um Ihre Produktivität zu steigern und Spitzenergebnisse zu erzielen. Stöbern Sie jetzt und entdecken Sie das perfekte Tool, um sich Ihre Finanzierung zu sichern!
11 Tools
xix.ai
Finanzen
KI-basierte OCR-Plattformen für Rechnungen für QuickBooks, Xero und den Abgleich mehrerer Unternehmenseinheiten
2026: Die besten aktuellen KI-basierten OCR-Plattformen für Rechnungen für QuickBooks, Xero und den Abgleich mehrerer Unternehmenseinheiten! XIX.AI stellt eine Liste der besten leistungsstarken Tools zusammen, die präzise Praxistests und wöchentlich aktualisierte Rankings bieten. Diese unverzichtbaren Lösungen optimieren die Rechnungsbearbeitung, steigern die Produktivität und sparen Zeit in komplexen Unternehmensstrukturen. Nutzen Sie den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die für Sie perfekte Lösung zu finden. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Wettbewerbsvorteil!
8 Tools
xix.ai
Geschäft
Software zur Erstellung von Antworten auf AI-RFP-Anfragen für Unternehmensvorschlagsprozesse
2026 – Das neueste und beste Softwaretool für die Erstellung von Antworten auf RFP-Anfragen mit KI, speziell entwickelt für Unternehmensprozesse! XIX.AI stellt eine Liste der am besten bewerteten, leistungsstarken Tools zusammen, die strenge Prüfungen im echten Einsatz bestanden haben. Diese Tools bieten nützliche Funktionen, die die Produktivität steigern und Ihre Prozesse bei der Erstellung von Angeboten vereinfachen. Holen Sie sich einen kostenlosen Vergleich zu den kostenpflichtigen Versionen, sehen Sie sich detaillierte Ranglisten an und entdecken Sie, wie diese bahnbrechenden Lösungen Ihnen dabei helfen, qualitativ hochwertige Antworten schneller zu erstellen. Entdecken Sie sie jetzt und sichern Sie sich einen Wettbewerbsvorteil durch KI!
9 Tools
xix.ai
Videoerstellung
KI-Tools für Untertitel und Synchronisation: Videos für ein globales Publikum lokalisieren
Die besten und am besten bewerteten KI-Tools für Untertitel und Synchronisation im Jahr 2026 – speziell ausgewählt für die Lokalisierung von Videos für ein globales Publikum. Erweitern Sie die Reichweite Ihrer Inhalte über Sprachbarrieren hinweg mit bahnbrechender Genauigkeit. Praxistests belegen, dass diese unverzichtbaren Lösungen einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie zuverlässige Rankings bieten, um Ihre Produktivität zu maximieren. Entdecken Sie jetzt das perfekte Tool für die weltweite Bereitstellung Ihrer Inhalte.
10 Tools
xix.ai
Automatisierung
KI-Tools zur Rechnungsbearbeitung für die Automatisierung der Kreditorenbuchhaltung, Genehmigungswege und ERP-Synchronisierungs-Workflows
Die besten KI-Tools 2026 für die Rechnungsbearbeitung – zur Automatisierung der Kreditorenbuchhaltung, für Genehmigungswege und ERP-Synchronisations-Workflows! XIX.AI stellt erstklassige, leistungsstarke Lösungen zusammen, die strenge Praxistests bestehen und die Produktivität drastisch steigern. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich detaillierte Rankings an und entdecken Sie unverzichtbare Optionen zur Optimierung Ihrer Finanzabläufe. Entdecken Sie jetzt, wie Sie Ihren KI-Vorteil nutzen können!
9 Tools
xix.ai

 Kommentare (0)
iFLYTEK hat Spark-Audio-1.0-Preview vorgestellt, ein sprachbasiertes großes Grundmodell, das vollständig auf inländischer Recheninfrastruktur aufgebaut ist.
Bisherige Audioverarbeitung mit großen Modellen beruhte auf einer Kaskadenmethode: Zuerst wurde Sprache in Text umgewandelt und dann an das Modell zur Analyse übergeben. Dieser Ansatz weist zwei schwerwiegende Mängel auf: Informationsverlust, da Text Tonfall, Emotionen und Hintergrundgeräusche nicht erfassen kann, was zu einem unvollständigen Kontext führt; sowie fragmentierte Arbeitsabläufe, bei denen unabhängige Module für Transkription, Sprechererkennung und Übersetzung nacheinander ausgeführt werden, was zu Fehlerakkumulation, Latenz und einer schlechten Benutzererfahrung führt.
Über Transkription hinaus: Direktes Sprachverständnis
Dieses sprachbasierte Grundmodell geht über einfache Transkription hinaus und interpretiert Audio direkt. Es kann menschliche Stimmen, Umgebungsgeräusche und Musik unterscheiden sowie Semantik, Emotionen und kontextuelle Hinweise innerhalb des Tons erfassen.
Die erste Version von Spark-Audio-1.0-Preview verfügt über einen 0,65B-Audioencoder (Dichte Struktur) und ein 30B-A3B-großes Sprachmodell (MoE-Struktur). Geschult mit 13 Millionen Stunden Audio und umfangreichen Textdaten auf einem vollständig inländischen Rechencluster, akzeptiert das Modell sowohl Text- als auch Audioeingaben. Es unterstützt Aufgaben wie Sprachtranskription, mehrsprachige Übersetzung, Mehrdialekterkennung, Umgebungsgeräuschidentifikation, Sprechererkennung, Stimmungsanalyse und komplexe Audio-Fragen-Antworten, wodurch Maschinen vom „klaren Hören“ zum „Verstehen“ übergehen können. Ähnlich wie bei iFLYTEKs großem Sprachmodell „1+N“-System können Benutzer dieses sprachbasierte Grundmodell feinabstimmen, um spezialisierte Systeme für Spracherkennung, Echtzeitübersetzung und interaktive Sprachanwendungen zu erstellen.
Unterstützt 99 Sprachen und 202 Dialekte, hervorragend in komplexen Szenarien
L offiziellen Daten liefert Spark-Audio-1.0-Preview vergleichbare oder bessere Ergebnisse als Wettbewerber bei verschiedenen Sprachbewertungsaufgaben, insbesondere in herausfordernden realen Szenarien wie hohen Geräuschpegeln und leiser Sprache. Seine Leistung steht auch in engem Zusammenhang mit größeren, geschlossenen sprachbasierten Grundmodellen.
Das Modell unterstützt die Erkennung von 99 Sprachen und 202 Dialekten. Es zeigt eine überlegene durchschnittliche Leistung bei der mehrsprachigen und mehrdialektalen Spracherkennung im Vergleich zum ähnlich großen Qwen3.5-omni-flash (35B-A3B) und entspricht der Leistung des deutlich größeren Qwen3.5-omni-plus. In Bewertungen wie Fleurs, Kespeech und LibriSpeech für Chinesisch-Englisch, Mehrsprachigkeit und Mehrdialekt-Spracherkennung übertrifft es Gemini-3.1 Pro und erzielt SOTA auf dem Fleurs-Chinesisch-Testset.
iFLYTEK räumt ein, dass diese Version zwar starke Leistungen bei allgemeinen Wissens-, Mathematik- und Codierungsaufgaben aufweist, es jedoch Verbesserungspotenzial bei der Befolgung von Anweisungen, Dialogen und dem Audioverständnis gibt. Zukünftige Updates werden sich auf die Stärkung dieser Bereiche konzentrieren. Spark-Audio-1.0-Preview ist jetzt für öffentliche Erfahrungen verfügbar, wobei der API-Zugriff bald auf der iFLYTEK Open Platform freigegeben wird.








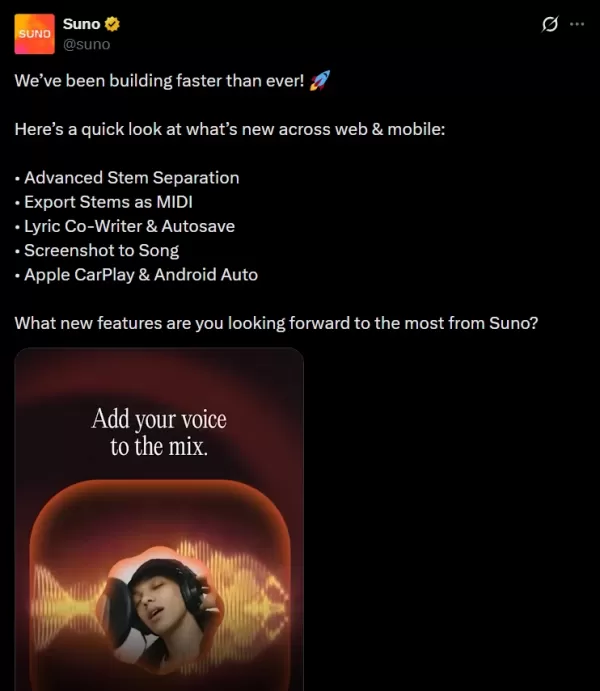 Suno stellt ein großes Update mit erweiterter Track-Trennung und Fahrzeugunterstützung vor
Suno hat erhebliche Updates für seine KI-Musikgenerierungsplattform veröffentlicht, die sowohl das Web- als auch das mobile Erlebnis verbessern, um die Erstellung zu vereinfachen und die Benutzerfreundlichkeit zu steigern. Die Plattform schreitet vor
 Joëlle Pineau von Cohere über souveräne KI und Unternehmenssicherheit
Eine von Cohere in Auftrag gegebene IDC-Studie befasst sich mit „Sovereign AI“, wobei Chief AI Officer Joëlle Pineau wesentliche Strategien für die Cloud-Sicherheit und Daten-Governance in Unternehmen
 Asiatische KI-Startups stellen Mythos-ähnliche Modelle vor, während das Exportverbot von Anthropic weiterhin gilt
Am Mittwoch berichtete das chinesische Cybersicherheitsunternehmen 360, es habe Tulongfeng vorgestellt, ein KI-Tool, das nach eigenen Angaben direkt mit Anthrims Mythos konkurrieren kann. Dabei handelt es sich um das auf Cybersicherheit spezialisiert
Die neuesten, besten und am höchsten bewerteten AI-Testgeneratoren für die Entwicklung von APIs und Funktionen im Jahr 2026. XIX.AI hat eine leistungsstarke Auswahl an unverzichtbaren Tools zusammengestellt, die durch strenge Tests in der Praxis gegangen sind, um präzise Ergebnisse zu liefern. Sie finden detaillierte Vergleichsanalysen zu kostenlosen und kostenpflichtigen Optionen sowie wöchentlich aktualisierte Ranglisten. Entdecken Sie jetzt das perfekte Tool für Ihre Bedürfnisse und sichern Sie sich einen Vorteil im Softwaretesting durch KI.
7 Tools
xix.ai
Die besten und am besten bewerteten KI-Tools zur Erstellung von Geschäftsplänen für das Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, mit denen Entwickler innovative Ideen schnell in ausgefeilte Entwürfe für Investorenpräsentationen umsetzen können. Hier finden Sie wöchentlich aktualisierte Rankings, Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests, die Ihnen dabei helfen, die Lösung zu finden, die Sie unbedingt ausprobieren sollten, um Ihre Produktivität zu steigern und Spitzenergebnisse zu erzielen. Stöbern Sie jetzt und entdecken Sie das perfekte Tool, um sich Ihre Finanzierung zu sichern!
11 Tools
xix.ai
2026: Die besten aktuellen KI-basierten OCR-Plattformen für Rechnungen für QuickBooks, Xero und den Abgleich mehrerer Unternehmenseinheiten! XIX.AI stellt eine Liste der besten leistungsstarken Tools zusammen, die präzise Praxistests und wöchentlich aktualisierte Rankings bieten. Diese unverzichtbaren Lösungen optimieren die Rechnungsbearbeitung, steigern die Produktivität und sparen Zeit in komplexen Unternehmensstrukturen. Nutzen Sie den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die für Sie perfekte Lösung zu finden. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Wettbewerbsvorteil!
8 Tools
xix.ai
2026 – Das neueste und beste Softwaretool für die Erstellung von Antworten auf RFP-Anfragen mit KI, speziell entwickelt für Unternehmensprozesse! XIX.AI stellt eine Liste der am besten bewerteten, leistungsstarken Tools zusammen, die strenge Prüfungen im echten Einsatz bestanden haben. Diese Tools bieten nützliche Funktionen, die die Produktivität steigern und Ihre Prozesse bei der Erstellung von Angeboten vereinfachen. Holen Sie sich einen kostenlosen Vergleich zu den kostenpflichtigen Versionen, sehen Sie sich detaillierte Ranglisten an und entdecken Sie, wie diese bahnbrechenden Lösungen Ihnen dabei helfen, qualitativ hochwertige Antworten schneller zu erstellen. Entdecken Sie sie jetzt und sichern Sie sich einen Wettbewerbsvorteil durch KI!
9 Tools
xix.ai
Die besten und am besten bewerteten KI-Tools für Untertitel und Synchronisation im Jahr 2026 – speziell ausgewählt für die Lokalisierung von Videos für ein globales Publikum. Erweitern Sie die Reichweite Ihrer Inhalte über Sprachbarrieren hinweg mit bahnbrechender Genauigkeit. Praxistests belegen, dass diese unverzichtbaren Lösungen einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie zuverlässige Rankings bieten, um Ihre Produktivität zu maximieren. Entdecken Sie jetzt das perfekte Tool für die weltweite Bereitstellung Ihrer Inhalte.
10 Tools
xix.ai
Die besten KI-Tools 2026 für die Rechnungsbearbeitung – zur Automatisierung der Kreditorenbuchhaltung, für Genehmigungswege und ERP-Synchronisations-Workflows! XIX.AI stellt erstklassige, leistungsstarke Lösungen zusammen, die strenge Praxistests bestehen und die Produktivität drastisch steigern. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich detaillierte Rankings an und entdecken Sie unverzichtbare Optionen zur Optimierung Ihrer Finanzabläufe. Entdecken Sie jetzt, wie Sie Ihren KI-Vorteil nutzen können!
9 Tools
xix.ai












