


 家
科大訊飛星火、30B MoE を搭載した 0.65B エンコーダ音声モデルを公開、完全な国内計算資源を基盤に構築
iFLYTEKは、国内の計算インフラのみを基盤として構築された音声基盤大規模モデル「Spark-Audio-1.0-Preview」をリリースしました。
従来、大規模モデルを用いた音声処理は、まず音声をテキストに変換し、その後モデルに渡して分析するというカスケード方式に依存していました。このアプローチには2つの大きな欠点があります。1つ目は情報の損失です。テキストではトーン、感情、背景音などが捉えられず、文脈が不完全になります。2つ目は分断されたワークフローです。文字起こし、話者識別、翻訳といった独立したモジュールが直列で動作するため、エラーの蓄積、遅延、そしてユーザー体験の低下を招きます。
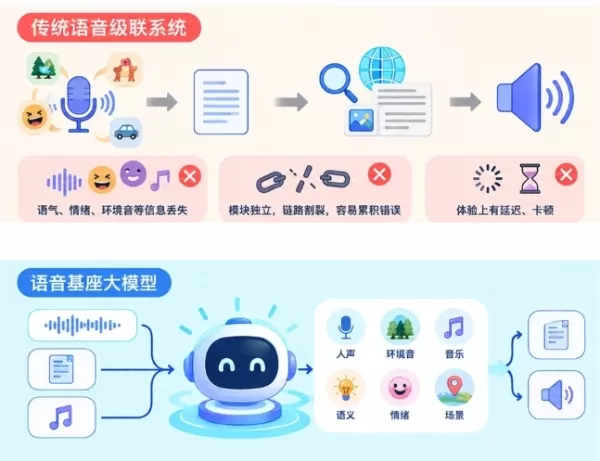
文字起こしを超えて:直接の音声理解
この音声基盤モデルは、単純な文字起こしを超えて、音声を直接解釈します。人間の声、環境音、音楽を区別でき、音声内の意味、感情、文脈の手がかりを把握します。
初期版のSpark-Audio-1.0-Previewは、0.65Bの音声エンコーダー(Dense構造)と30B-A3Bの大規模言語モデル(MoE構造)を特徴としています。完全な国内計算クラスターを用いて、1300万時間の音声データと膨大なテキストデータで学習されたこのモデルは、テキストと音声の両方の入力を接受します。音声文字起こし、多言語翻訳、多方言認識、環境音識別、話者認識、感情分析、複雑な音声Q&Aなどのタスクをサポートし、機械が「はっきりと聞く」から「理解する」へ移行することを可能にします。iFLYTEKのSpark大規模モデルの「1+N」システムと同様に、ユーザーはこの音声基盤モデルをファインチューニングして、音声認識、リアルタイム翻訳、対話型音声アプリケーション向けの専用システムを作成できます。
99の言語と202の方言をサポートし、複雑なシナリオで優れたパフォーマンスを発揮
公式データによると、Spark-Audio-1.0-Previewは、高ノイズレベルや小声での発話といった困難な現実世界のシナリオを含む、さまざまな音声評価タスクにおいて、競合他社と同等またはそれ以上のパフォーマンスを示しています。そのパフォーマンスは、より大規模なクローズドソースの音声基盤モデルとも密接に一致しています。
このモデルは99の言語と202の方言の認識をサポートしています。同規模のQwen3.5-omni-flash(35B-A3B)と比較して、多言語および多方言の音声認識において優れた平均パフォーマンスを示し、大幅に大規模なQwen3.5-omni-plusと同等のパフォーマンスを達成しています。中国語-英語、多言語、多方言の音声認識に関するFleurs、Kespeech、LibriSpeechなどの評価では、Gemini-3.1 Proを上回り、Fleursの中国語テストセットでSOTAを達成しています。
iFLYTEKは、このバージョンが一般的な知識、数学、コーディングタスクにおいて強力なパフォーマンスを維持している一方で、指示のフォロー、対話、音声理解の分野には改善の余地があることを認めています。今後のアップデートでは、これらの領域の強化に焦点を当てます。Spark-Audio-1.0-Previewは現在、一般公開された体験版として利用可能であり、APIアクセスはまもなくiFLYTEK Open Platformでリリースされる予定です。
関連記事
 Zoho、企業のAIエージェント導入を支援
市場はAI駆動型エージェントへと急速に進化しているZohoは、AIが飛躍的に進歩していることを強調し、企業がこれに適応し、業務の見直しを行うことが不可欠であると指摘しているAIをめぐる熱狂は、衰える気配を見せていません。最新動向に追いつくには多大な努力が必要です。モデルの大型化、エージェントの性能向上、そして「乗り遅れることへの強い不安」が相まって、すべての経営者は、AIを日常のワークフローに組み
Suno、高度なトラック分離と車載サポートを備えた大規模アップデートを公開
Sunoは、AI音楽生成プラットフォームに大幅なアップデートを導入し、Webおよびモバイルの両方の体験を強化して、制作の簡素化と使いやすさの向上を図っています。このプラットフォームは、AI駆動の音楽制作において、よりアクセスしやすく効率的な段階へと進歩しており、プロフェッショナルなオーディオツールを運転などの日常的なシナリオと統合しています。高度なステム分離このアップデートの主要な見どころは、ボーカル、ドラム、ベース、楽器を個別のトラックに分離する高度なステム分離機能です。この機能により、ミュー
Cohere社のジョエル・ピノーが語る「ソブリンAI」と企業セキュリティ
Cohereが委託したIDCの調査では、ソブリンAIについて検証されており、最高AI責任者(CIO)のジョエル・ピノー氏が、企業のクラウドセキュリティとデータガバナンスに向けた重要な戦略を概説している。AI企業Cohereが委託したIDCのレポート『2026年のソブリンAI導入状況(The State of Sovereign AI Adoption in 2026)』によると、ビジネスリーダーの
関連特集おすすめ
コード
 おすすめのAIテスト生成ツール:APIや関数のユニットテストを作成する
2026年最新・最高評価のAPIおよび関数開発向けAIテストジェネレーター。XIX.AIは、厳格な実環境テストを経て正確な結果を提供する、強力で業界に革新をもたらす「必試」ツールを厳選しました。 無料版と有料版の詳細な比較分析や、毎週更新されるランキングをご覧いただけます。今すぐチェックして、あなたにぴったりのツールを見つけ、ソフトウェアテストにおけるAIの優位性を手に入れましょう。
 7 ツール
 xix.ai
仕事
おすすめのAIビジネスプラン作成ツール:アイデアを投資家向けプレゼン資料の草案に変える
2026年最新の、高評価を誇るAIビジネスプラン作成ツールがXIX.AIに登場!この厳選コレクションには、クリエイターが革新的なアイデアを、洗練された投資家向けプレゼン資料の草案へと迅速にまとめ上げるのに役立つ、業界に革命をもたらす強力なツールが揃っています。 毎週更新されるランキング、無料版と有料版の比較分析、実地テストの結果など、生産性を高め、最高の成果をもたらす「必試」のソリューション選びに役立つ情報が満載です。今すぐチェックして、資金調達を成功させるための最適なツールを発見しましょう!
11 ツール
xix.ai
ファイナンス
QuickBooks、Xero、および複数事業体間の照合に対応したAI請求書OCRプラットフォーム
2026年版:QuickBooks、Xero、および複数事業体の照合に最適なAI請求書OCRプラットフォーム最新ランキング! XIX.AIは、実環境での正確なテストと毎週更新されるランキングに基づき、高評価の強力なツールリストを厳選しています。これらの必見ソリューションは、請求書処理を効率化し、生産性を向上させ、複雑なビジネス環境においても時間を節約します。無料版と有料版の比較を確認して、最適なソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
8 ツール
xix.ai
仕事
企業向け提案ワークフローに特化したAI RFP対応ソフトウェア
2026年最新の、企業向け提案ワークフローに最適なAI RFP対応ソフトウェア!XIX.AIは、厳しい実際の運用テストをクリアした優れたツールを厳選してリストアップしており、生産性を向上させ、提案プロセスを効率化するための有用な機能を提供しています。無料版と有料版の比較情報や詳細なランキングを確認し、これら画期的なソリューションがいかにしてより迅速に高品質な回答を作成するのに役立つかをご覧ください。今すぐチェックして、AIによる競争優位を手に入れましょう!
9 ツール
xix.ai
動画作成
AI字幕・吹き替えツール:世界中の視聴者向けに動画をローカライズする
2026年最新・最高評価のAI字幕・吹き替えツール集:世界中の視聴者に向けた動画のローカライズに最適。画期的な精度で、言語の壁を越えてコンテンツのリーチを飛躍的に拡大。実地テストで実証された、ぜひ試すべきソリューションの数々。無料版と有料版の比較や信頼性の高いランキングを通じて、生産性を最大化。今すぐチェックして、グローバルなコンテンツ配信に最適なツールを見つけましょう。
10 ツール
xix.ai
オートメーション
買掛金処理の自動化、承認ルートの設定、およびERP連携ワークフローのためのAI請求書処理ツール
2026年最新版!買掛金管理の自動化、承認フロー、ERP連携ワークフローに最適なAI請求書処理ツール!XIX.AIは、厳格な実地テストをクリアした高評価で高性能なソリューションを厳選し、生産性を劇的に向上させます。 無料版と有料版の比較、詳細なランキングを確認し、財務業務を効率化するためにぜひ試すべきオプションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

 コメント (0)
0/500
iFLYTEKは、国内の計算インフラのみを基盤として構築された音声基盤大規模モデル「Spark-Audio-1.0-Preview」をリリースしました。
従来、大規模モデルを用いた音声処理は、まず音声をテキストに変換し、その後モデルに渡して分析するというカスケード方式に依存していました。このアプローチには2つの大きな欠点があります。1つ目は情報の損失です。テキストではトーン、感情、背景音などが捉えられず、文脈が不完全になります。2つ目は分断されたワークフローです。文字起こし、話者識別、翻訳といった独立したモジュールが直列で動作するため、エラーの蓄積、遅延、そしてユーザー体験の低下を招きます。
文字起こしを超えて:直接の音声理解
この音声基盤モデルは、単純な文字起こしを超えて、音声を直接解釈します。人間の声、環境音、音楽を区別でき、音声内の意味、感情、文脈の手がかりを把握します。
初期版のSpark-Audio-1.0-Previewは、0.65Bの音声エンコーダー(Dense構造)と30B-A3Bの大規模言語モデル(MoE構造)を特徴としています。完全な国内計算クラスターを用いて、1300万時間の音声データと膨大なテキストデータで学習されたこのモデルは、テキストと音声の両方の入力を接受します。音声文字起こし、多言語翻訳、多方言認識、環境音識別、話者認識、感情分析、複雑な音声Q&Aなどのタスクをサポートし、機械が「はっきりと聞く」から「理解する」へ移行することを可能にします。iFLYTEKのSpark大規模モデルの「1+N」システムと同様に、ユーザーはこの音声基盤モデルをファインチューニングして、音声認識、リアルタイム翻訳、対話型音声アプリケーション向けの専用システムを作成できます。
99の言語と202の方言をサポートし、複雑なシナリオで優れたパフォーマンスを発揮
公式データによると、Spark-Audio-1.0-Previewは、高ノイズレベルや小声での発話といった困難な現実世界のシナリオを含む、さまざまな音声評価タスクにおいて、競合他社と同等またはそれ以上のパフォーマンスを示しています。そのパフォーマンスは、より大規模なクローズドソースの音声基盤モデルとも密接に一致しています。
このモデルは99の言語と202の方言の認識をサポートしています。同規模のQwen3.5-omni-flash(35B-A3B)と比較して、多言語および多方言の音声認識において優れた平均パフォーマンスを示し、大幅に大規模なQwen3.5-omni-plusと同等のパフォーマンスを達成しています。中国語-英語、多言語、多方言の音声認識に関するFleurs、Kespeech、LibriSpeechなどの評価では、Gemini-3.1 Proを上回り、Fleursの中国語テストセットでSOTAを達成しています。
iFLYTEKは、このバージョンが一般的な知識、数学、コーディングタスクにおいて強力なパフォーマンスを維持している一方で、指示のフォロー、対話、音声理解の分野には改善の余地があることを認めています。今後のアップデートでは、これらの領域の強化に焦点を当てます。Spark-Audio-1.0-Previewは現在、一般公開された体験版として利用可能であり、APIアクセスはまもなくiFLYTEK Open Platformでリリースされる予定です。








 Zoho、企業のAIエージェント導入を支援
市場はAI駆動型エージェントへと急速に進化しているZohoは、AIが飛躍的に進歩していることを強調し、企業がこれに適応し、業務の見直しを行うことが不可欠であると指摘しているAIをめぐる熱狂は、衰える気配を見せていません。最新動向に追いつくには多大な努力が必要です。モデルの大型化、エージェントの性能向上、そして「乗り遅れることへの強い不安」が相まって、すべての経営者は、AIを日常のワークフローに組み
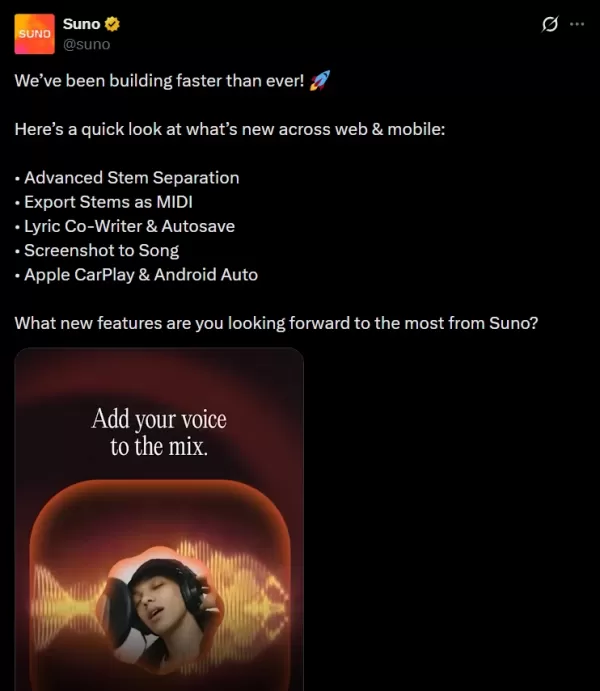 Suno、高度なトラック分離と車載サポートを備えた大規模アップデートを公開
Sunoは、AI音楽生成プラットフォームに大幅なアップデートを導入し、Webおよびモバイルの両方の体験を強化して、制作の簡素化と使いやすさの向上を図っています。このプラットフォームは、AI駆動の音楽制作において、よりアクセスしやすく効率的な段階へと進歩しており、プロフェッショナルなオーディオツールを運転などの日常的なシナリオと統合しています。高度なステム分離このアップデートの主要な見どころは、ボーカル、ドラム、ベース、楽器を個別のトラックに分離する高度なステム分離機能です。この機能により、ミュー
 Cohere社のジョエル・ピノーが語る「ソブリンAI」と企業セキュリティ
Cohereが委託したIDCの調査では、ソブリンAIについて検証されており、最高AI責任者(CIO)のジョエル・ピノー氏が、企業のクラウドセキュリティとデータガバナンスに向けた重要な戦略を概説している。AI企業Cohereが委託したIDCのレポート『2026年のソブリンAI導入状況(The State of Sovereign AI Adoption in 2026)』によると、ビジネスリーダーの
2026年最新・最高評価のAPIおよび関数開発向けAIテストジェネレーター。XIX.AIは、厳格な実環境テストを経て正確な結果を提供する、強力で業界に革新をもたらす「必試」ツールを厳選しました。 無料版と有料版の詳細な比較分析や、毎週更新されるランキングをご覧いただけます。今すぐチェックして、あなたにぴったりのツールを見つけ、ソフトウェアテストにおけるAIの優位性を手に入れましょう。
7 ツール
xix.ai
2026年最新の、高評価を誇るAIビジネスプラン作成ツールがXIX.AIに登場!この厳選コレクションには、クリエイターが革新的なアイデアを、洗練された投資家向けプレゼン資料の草案へと迅速にまとめ上げるのに役立つ、業界に革命をもたらす強力なツールが揃っています。 毎週更新されるランキング、無料版と有料版の比較分析、実地テストの結果など、生産性を高め、最高の成果をもたらす「必試」のソリューション選びに役立つ情報が満載です。今すぐチェックして、資金調達を成功させるための最適なツールを発見しましょう!
11 ツール
xix.ai
2026年版:QuickBooks、Xero、および複数事業体の照合に最適なAI請求書OCRプラットフォーム最新ランキング! XIX.AIは、実環境での正確なテストと毎週更新されるランキングに基づき、高評価の強力なツールリストを厳選しています。これらの必見ソリューションは、請求書処理を効率化し、生産性を向上させ、複雑なビジネス環境においても時間を節約します。無料版と有料版の比較を確認して、最適なソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
8 ツール
xix.ai
2026年最新の、企業向け提案ワークフローに最適なAI RFP対応ソフトウェア!XIX.AIは、厳しい実際の運用テストをクリアした優れたツールを厳選してリストアップしており、生産性を向上させ、提案プロセスを効率化するための有用な機能を提供しています。無料版と有料版の比較情報や詳細なランキングを確認し、これら画期的なソリューションがいかにしてより迅速に高品質な回答を作成するのに役立つかをご覧ください。今すぐチェックして、AIによる競争優位を手に入れましょう!
9 ツール
xix.ai
2026年最新・最高評価のAI字幕・吹き替えツール集:世界中の視聴者に向けた動画のローカライズに最適。画期的な精度で、言語の壁を越えてコンテンツのリーチを飛躍的に拡大。実地テストで実証された、ぜひ試すべきソリューションの数々。無料版と有料版の比較や信頼性の高いランキングを通じて、生産性を最大化。今すぐチェックして、グローバルなコンテンツ配信に最適なツールを見つけましょう。
10 ツール
xix.ai
2026年最新版!買掛金管理の自動化、承認フロー、ERP連携ワークフローに最適なAI請求書処理ツール!XIX.AIは、厳格な実地テストをクリアした高評価で高性能なソリューションを厳選し、生産性を劇的に向上させます。 無料版と有料版の比較、詳細なランキングを確認し、財務業務を効率化するためにぜひ試すべきオプションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai












