


 Hogar
iFlytek Xinghuo presenta un modelo de codificación de voz de 0.65B con 30B MoE, construido sobre potencia informática completamente nacional
iFLYTEK ha lanzado Spark-Audio-1.0-Preview, un modelo grande de base para audio construido íntegramente sobre infraestructura informática nacional.
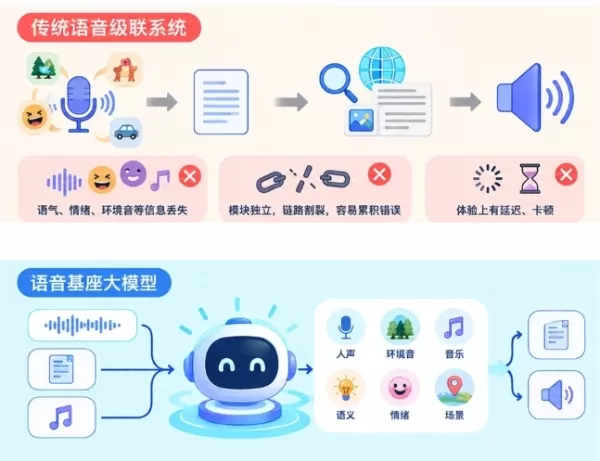
Anteriormente, el procesamiento de audio con modelos grandes se basaba en un método en cascada: convertir primero el habla a texto y luego pasarlo al modelo para su análisis. Este enfoque presenta dos grandes defectos: pérdida de información, ya que el texto no logra capturar el tono, la emoción y los sonidos del entorno, lo que conduce a un contexto incompleto; y flujos de trabajo fragmentados, donde módulos independientes para la transcripción, la identificación del hablante y la traducción funcionan en serie, lo que provoca acumulación de errores, latencia y una mala experiencia de usuario.
Más allá de la transcripción: Comprensión directa del habla
Este modelo de base para el audio va más allá de la simple transcripción para interpretar directamente el audio. Puede distinguir las voces humanas, el ruido ambiental y la música, al tiempo que capta la semántica, las emociones y las señales contextuales dentro del sonido.
La versión inicial de Spark-Audio-1.0-Preview cuenta con un codificador de audio de 0,65B (estructura densa) y un modelo de lenguaje grande de 30B-A3B (estructura MoE). Entrenado con 13 millones de horas de audio y extensos datos de texto utilizando un clúster de computación completamente nacional, el modelo acepta entradas tanto de texto como de audio. Admite tareas como transcripción de voz, traducción multilingüe, reconocimiento de múltiples dialectos, identificación de sonidos ambientales, reconocimiento del hablante, análisis de sentimiento y preguntas y respuestas complejas sobre audio, permitiendo que las máquinas pasen de "oír claramente" a "comprender". De manera similar al sistema "1+N" de los modelos grandes de iFLYTEK, los usuarios pueden ajustar finamente este modelo de base para el audio y crear sistemas especializados para el reconocimiento de voz, la traducción en tiempo real y las aplicaciones interactivas de voz.
Soporte para 99 idiomas y 202 dialectos, con excelencia en escenarios complejos
Según los datos oficiales, Spark-Audio-1.0-Preview tiene un rendimiento comparable o superior al de la competencia en diversas tareas de evaluación de voz, especialmente en escenarios reales desafiantes como altos niveles de ruido y habla suave. Su rendimiento también está estrechamente alineado con el de modelos de base para el habla más grandes y de código cerrado.
El modelo admite el reconocimiento de 99 idiomas y 202 dialectos. Demuestra un rendimiento promedio superior en el reconocimiento de voz multilingüe y multidialectal en comparación con Qwen3.5-omni-flash (35B-A3B) de tamaño similar, y iguala el rendimiento de Qwen3.5-omni-plus, significativamente más grande. En evaluaciones como Fleurs, Kespeech y LibriSpeech para el reconocimiento de voz chino-inglés, multilingüe y multidialectal, supera a Gemini-3.1 Pro y alcanza el estado de la técnica (SOTA) en el conjunto de prueba chino de Fleurs.
iFLYTEK reconoce que, aunque esta versión mantiene un fuerte rendimiento en tareas de conocimiento general, matemáticas y programación, hay margen de mejora en el seguimiento de instrucciones, el diálogo y la comprensión del audio. Las futuras actualizaciones se centrarán en fortalecer estas áreas. Spark-Audio-1.0-Preview ya está disponible para la experiencia pública, y el acceso a la API se lanzará pronto en la Plataforma Abierta de iFLYTEK.
Artículo relacionado
 Zoho ayuda a las empresas a implantar agentes de IA
El mercado está evolucionando rápidamente hacia los agentes basados en la inteligencia artificialZoho destaca que la IA avanza de forma exponencial, por lo que es fundamental que las empresas se adapt
Suno presenta una actualización importante con separación avanzada de pistas y soporte para coches
Suno ha lanzado actualizaciones significativas en su plataforma de generación de música con inteligencia artificial, mejorando tanto la experiencia web como la móvil para agilizar la creación y aumentar la usabilidad. La plataforma avanza hacia una e
Joëlle Pineau, de Cohere, habla sobre la IA soberana y la seguridad empresarial
Un estudio de IDC encargado por Cohere analiza la IA soberana, y la directora de IA, Joëlle Pineau, describe las estrategias esenciales para la seguridad en la nube empresarial y la gobernanza de dato
Recomendaciones de temas especiales relacionados
código
 Mejores generadores de pruebas de IA: Crea pruebas unitarias para APIs y funciones
Los mejores generadores de pruebas de IA de 2026, altamente calificados y actualizados, para el desarrollo de APIs y funciones. XIX.AI ha reunido una colección poderosa y revolucionaria de herramientas imprescindibles que han superado pruebas rigurosas en entornos reales a fin de ofrecer resultados precisos. Encontrará aquí análisis detallados y comparativas gratuitas frente a las opciones de pago, además de clasificaciones actualizadas semanalmente. Explore ahora mismo para descubrir la herramienta perfecta para usted y aprovechar toda la ventaja que le brinda la inteligencia artificial en las pruebas de software.
 7 herramientas
 xix.ai
Negocio
Los mejores generadores de planes de negocio basados en IA: convierte tus ideas en borradores de presentaciones para inversores
¡Los mejores generadores de planes de negocio con IA de 2026, los más valorados, ya están aquí, en XIX.AI! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a convertir rápidamente sus ideas innovadoras en borradores de presentaciones para inversores perfectamente elaborados. Encontrarás clasificaciones actualizadas semanalmente, comparativas entre versiones gratuitas y de pago, y pruebas en condiciones reales que te ayudarán a elegir la solución imprescindible que impulse tu productividad y ofrezca los mejores resultados. ¡Explora ahora mismo y descubre la herramienta perfecta para conseguir financiación!
11 herramientas
xix.ai
Finanzas
Plataformas de OCR de facturas basadas en IA para QuickBooks, Xero y la conciliación de varias entidades
¡Las mejores plataformas de OCR de facturas con IA de 2026 para QuickBooks, Xero y la conciliación de múltiples entidades! XIX.AI elabora una lista de las herramientas mejor valoradas, que ofrecen pruebas precisas en condiciones reales y clasificaciones actualizadas semanalmente. Estas soluciones imprescindibles agilizan el procesamiento de facturas, aumentan la productividad y ahorran tiempo en entornos empresariales complejos. Consulta una comparación entre las versiones gratuitas y de pago para encontrar la que mejor se adapta a tus necesidades. ¡Descúbrelas ahora y aprovecha las ventajas de la IA!
8 herramientas
xix.ai
Negocio
Software de respuesta a solicitudes de oferta (RFP) basado en IA para flujos de trabajo de propuestas empresariales
¡El mejor software de 2026 para responder a solicitudes de propuestas (RFP) con IA, ideal para los flujos de trabajo de propuestas empresariales! XIX.AI ha elaborado una lista de las herramientas mejor valoradas, que han superado rigurosas pruebas en condiciones reales y ofrecen funciones imprescindibles para impulsar la productividad y optimizar tus procesos de elaboración de propuestas. Consigue una comparación entre las versiones gratuitas y de pago, consulta las clasificaciones detalladas y descubre cómo estas soluciones revolucionarias pueden ayudarte a crear respuestas de alta calidad más rápidamente. ¡Explora ahora mismo y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai
Creación de vídeos
Herramientas de subtitulado y doblaje con IA: adapta tus vídeos para un público internacional
Las mejores herramientas de subtitulado y doblaje con IA de 2026, seleccionadas para la localización de vídeos destinados a un público internacional. Amplía de forma espectacular el alcance de tus contenidos más allá de las barreras lingüísticas con una precisión revolucionaria. Las pruebas en condiciones reales demuestran que estas soluciones imprescindibles ofrecen comparativas entre opciones gratuitas y de pago, así como clasificaciones fiables para maximizar la productividad. Explora ahora y descubre la herramienta perfecta para la distribución global de contenidos.
10 herramientas
xix.ai
automatización
Herramientas de procesamiento de facturas basadas en IA para la automatización de la contabilidad de proveedores, los flujos de trabajo de aprobación y la sincronización con el ERP
¡Las mejores herramientas de procesamiento de facturas con IA de 2026 para la automatización de la contabilidad de proveedores, los flujos de trabajo de aprobación y la sincronización con el ERP! XIX.AI selecciona soluciones potentes y mejor valoradas que superan rigurosas pruebas en condiciones reales para aumentar drásticamente la productividad. Consigue una comparación entre las versiones gratuitas y de pago, consulta las clasificaciones detalladas y descubre opciones imprescindibles para optimizar tus operaciones financieras. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai

 comentario (0)
0/500
iFLYTEK ha lanzado Spark-Audio-1.0-Preview, un modelo grande de base para audio construido íntegramente sobre infraestructura informática nacional.
Anteriormente, el procesamiento de audio con modelos grandes se basaba en un método en cascada: convertir primero el habla a texto y luego pasarlo al modelo para su análisis. Este enfoque presenta dos grandes defectos: pérdida de información, ya que el texto no logra capturar el tono, la emoción y los sonidos del entorno, lo que conduce a un contexto incompleto; y flujos de trabajo fragmentados, donde módulos independientes para la transcripción, la identificación del hablante y la traducción funcionan en serie, lo que provoca acumulación de errores, latencia y una mala experiencia de usuario.
Más allá de la transcripción: Comprensión directa del habla
Este modelo de base para el audio va más allá de la simple transcripción para interpretar directamente el audio. Puede distinguir las voces humanas, el ruido ambiental y la música, al tiempo que capta la semántica, las emociones y las señales contextuales dentro del sonido.
La versión inicial de Spark-Audio-1.0-Preview cuenta con un codificador de audio de 0,65B (estructura densa) y un modelo de lenguaje grande de 30B-A3B (estructura MoE). Entrenado con 13 millones de horas de audio y extensos datos de texto utilizando un clúster de computación completamente nacional, el modelo acepta entradas tanto de texto como de audio. Admite tareas como transcripción de voz, traducción multilingüe, reconocimiento de múltiples dialectos, identificación de sonidos ambientales, reconocimiento del hablante, análisis de sentimiento y preguntas y respuestas complejas sobre audio, permitiendo que las máquinas pasen de "oír claramente" a "comprender". De manera similar al sistema "1+N" de los modelos grandes de iFLYTEK, los usuarios pueden ajustar finamente este modelo de base para el audio y crear sistemas especializados para el reconocimiento de voz, la traducción en tiempo real y las aplicaciones interactivas de voz.
Soporte para 99 idiomas y 202 dialectos, con excelencia en escenarios complejos
Según los datos oficiales, Spark-Audio-1.0-Preview tiene un rendimiento comparable o superior al de la competencia en diversas tareas de evaluación de voz, especialmente en escenarios reales desafiantes como altos niveles de ruido y habla suave. Su rendimiento también está estrechamente alineado con el de modelos de base para el habla más grandes y de código cerrado.
El modelo admite el reconocimiento de 99 idiomas y 202 dialectos. Demuestra un rendimiento promedio superior en el reconocimiento de voz multilingüe y multidialectal en comparación con Qwen3.5-omni-flash (35B-A3B) de tamaño similar, y iguala el rendimiento de Qwen3.5-omni-plus, significativamente más grande. En evaluaciones como Fleurs, Kespeech y LibriSpeech para el reconocimiento de voz chino-inglés, multilingüe y multidialectal, supera a Gemini-3.1 Pro y alcanza el estado de la técnica (SOTA) en el conjunto de prueba chino de Fleurs.
iFLYTEK reconoce que, aunque esta versión mantiene un fuerte rendimiento en tareas de conocimiento general, matemáticas y programación, hay margen de mejora en el seguimiento de instrucciones, el diálogo y la comprensión del audio. Las futuras actualizaciones se centrarán en fortalecer estas áreas. Spark-Audio-1.0-Preview ya está disponible para la experiencia pública, y el acceso a la API se lanzará pronto en la Plataforma Abierta de iFLYTEK.








 Zoho ayuda a las empresas a implantar agentes de IA
El mercado está evolucionando rápidamente hacia los agentes basados en la inteligencia artificialZoho destaca que la IA avanza de forma exponencial, por lo que es fundamental que las empresas se adapt
 Suno presenta una actualización importante con separación avanzada de pistas y soporte para coches
Suno ha lanzado actualizaciones significativas en su plataforma de generación de música con inteligencia artificial, mejorando tanto la experiencia web como la móvil para agilizar la creación y aumentar la usabilidad. La plataforma avanza hacia una e
 Joëlle Pineau, de Cohere, habla sobre la IA soberana y la seguridad empresarial
Un estudio de IDC encargado por Cohere analiza la IA soberana, y la directora de IA, Joëlle Pineau, describe las estrategias esenciales para la seguridad en la nube empresarial y la gobernanza de dato
Los mejores generadores de pruebas de IA de 2026, altamente calificados y actualizados, para el desarrollo de APIs y funciones. XIX.AI ha reunido una colección poderosa y revolucionaria de herramientas imprescindibles que han superado pruebas rigurosas en entornos reales a fin de ofrecer resultados precisos. Encontrará aquí análisis detallados y comparativas gratuitas frente a las opciones de pago, además de clasificaciones actualizadas semanalmente. Explore ahora mismo para descubrir la herramienta perfecta para usted y aprovechar toda la ventaja que le brinda la inteligencia artificial en las pruebas de software.
7 herramientas
xix.ai
¡Los mejores generadores de planes de negocio con IA de 2026, los más valorados, ya están aquí, en XIX.AI! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a convertir rápidamente sus ideas innovadoras en borradores de presentaciones para inversores perfectamente elaborados. Encontrarás clasificaciones actualizadas semanalmente, comparativas entre versiones gratuitas y de pago, y pruebas en condiciones reales que te ayudarán a elegir la solución imprescindible que impulse tu productividad y ofrezca los mejores resultados. ¡Explora ahora mismo y descubre la herramienta perfecta para conseguir financiación!
11 herramientas
xix.ai
¡Las mejores plataformas de OCR de facturas con IA de 2026 para QuickBooks, Xero y la conciliación de múltiples entidades! XIX.AI elabora una lista de las herramientas mejor valoradas, que ofrecen pruebas precisas en condiciones reales y clasificaciones actualizadas semanalmente. Estas soluciones imprescindibles agilizan el procesamiento de facturas, aumentan la productividad y ahorran tiempo en entornos empresariales complejos. Consulta una comparación entre las versiones gratuitas y de pago para encontrar la que mejor se adapta a tus necesidades. ¡Descúbrelas ahora y aprovecha las ventajas de la IA!
8 herramientas
xix.ai
¡El mejor software de 2026 para responder a solicitudes de propuestas (RFP) con IA, ideal para los flujos de trabajo de propuestas empresariales! XIX.AI ha elaborado una lista de las herramientas mejor valoradas, que han superado rigurosas pruebas en condiciones reales y ofrecen funciones imprescindibles para impulsar la productividad y optimizar tus procesos de elaboración de propuestas. Consigue una comparación entre las versiones gratuitas y de pago, consulta las clasificaciones detalladas y descubre cómo estas soluciones revolucionarias pueden ayudarte a crear respuestas de alta calidad más rápidamente. ¡Explora ahora mismo y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai
Las mejores herramientas de subtitulado y doblaje con IA de 2026, seleccionadas para la localización de vídeos destinados a un público internacional. Amplía de forma espectacular el alcance de tus contenidos más allá de las barreras lingüísticas con una precisión revolucionaria. Las pruebas en condiciones reales demuestran que estas soluciones imprescindibles ofrecen comparativas entre opciones gratuitas y de pago, así como clasificaciones fiables para maximizar la productividad. Explora ahora y descubre la herramienta perfecta para la distribución global de contenidos.
10 herramientas
xix.ai
¡Las mejores herramientas de procesamiento de facturas con IA de 2026 para la automatización de la contabilidad de proveedores, los flujos de trabajo de aprobación y la sincronización con el ERP! XIX.AI selecciona soluciones potentes y mejor valoradas que superan rigurosas pruebas en condiciones reales para aumentar drásticamente la productividad. Consigue una comparación entre las versiones gratuitas y de pago, consulta las clasificaciones detalladas y descubre opciones imprescindibles para optimizar tus operaciones financieras. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai












