


 Maison
iFlytek Xinghuo dévoile un modèle de parole encodeur 0,65B avec 30B MoE, construit sur une puissance de calcul entièrement nationale
iFLYTEK a lancé Spark-Audio-1.0-Preview, un grand modèle de base pour l'audio construit entièrement sur une infrastructure informatique nationale.
Auparavant, le traitement audio avec des grands modèles reposait sur une méthode en cascade : convertir d'abord la parole en texte, puis le transmettre au modèle pour analyse. Cette approche présente deux défauts majeurs : une perte d'information, car le texte ne parvient pas à capturer le ton, l'émotion et les sons ambiants, ce qui conduit à un contexte incomplet ; et des workflows fragmentés, où des modules indépendants pour la transcription, l'identification de l'orateur et la traduction fonctionnent en série, entraînant une accumulation d'erreurs, une latence et une mauvaise expérience utilisateur.
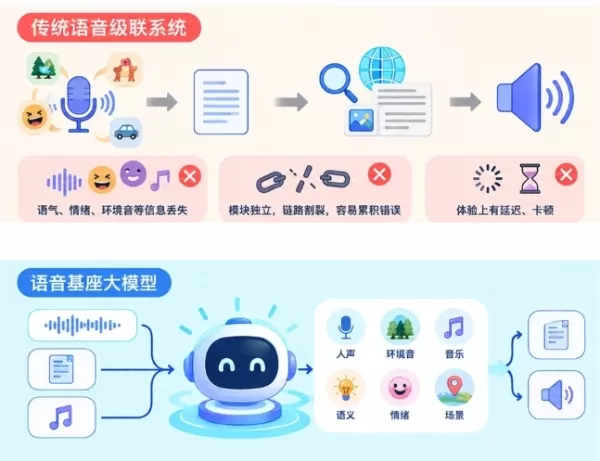
Au-delà de la transcription : Compréhension directe de la parole
Ce modèle de base pour la parole va au-delà de la simple transcription pour interpréter directement l'audio. Il peut distinguer les voix humaines, le bruit ambiant et la musique, tout en saisissant la sémantique, les émotions et les indices contextuels présents dans le son.
La version initiale de Spark-Audio-1.0-Preview comprend un encodeur audio de 0,65 milliard de paramètres (structure Dense) et un grand modèle de langage de 30 milliards de paramètres avec 3 milliards de paramètres actifs (structure MoE). Entraîné sur 13 millions d'heures d'audio et d'importantes données textuelles à l'aide d'un cluster informatique entièrement national, le modèle accepte à la fois des entrées textuelles et audio. Il prend en charge des tâches telles que la transcription de la parole, la traduction multilingue, la reconnaissance de multiples dialectes, l'identification des sons ambiants, la reconnaissance de l'orateur, l'analyse des sentiments et les questions-réponses audio complexes, permettant aux machines de passer d'une « écoute claire » à une « compréhension ». Semblable au système « 1+N » des grands modèles Spark d'iFLYTEK, les utilisateurs peuvent affiner ce modèle de base pour la parole afin de créer des systèmes spécialisés pour la reconnaissance vocale, la traduction en temps réel et les applications interactives de parole.
Prend en charge 99 langues et 202 dialectes, excellant dans des scénarios complexes
Selon les données officielles, Spark-Audio-1.0-Preview obtient des performances comparables ou supérieures à celles des concurrents sur diverses tâches d'évaluation de la parole, en particulier dans des scénarios réels difficiles tels que les niveaux de bruit élevés et les voix basses. Ses performances sont également étroitement alignées avec celles de grands modèles de base pour la parole fermés et plus importants.
Le modèle prend en charge la reconnaissance de 99 langues et 202 dialectes. Il démontre des performances moyennes supérieures en reconnaissance de la parole multilingue et multi-dialectale par rapport à Qwen3.5-omni-flash (35B-A3B) de taille similaire, et égale les performances de Qwen3.5-omni-plus, nettement plus grand. Dans des évaluations telles que Fleurs, Kespeech et LibriSpeech pour la reconnaissance de la parole chinois-anglais, multilingue et multi-dialectale, il surpasse Gemini-3.1 Pro et atteint l'état de l'art (SOTA) sur l'ensemble de test chinois de Fleurs.
iFLYTEK reconnaît que, bien que cette version maintienne des performances solides dans les tâches de connaissances générales, de mathématiques et de codage, il existe des marges d'amélioration en matière de suivi des instructions, de dialogue et de compréhension audio. Les futures mises à jour se concentreront sur le renforcement de ces domaines. Spark-Audio-1.0-Preview est désormais disponible pour une expérience publique, avec un accès API qui sera bientôt publié sur la Plateforme Ouverte d'iFLYTEK.
Article connexe
 Suno dévoile une mise à jour majeure avec une séparation avancée des pistes et un support pour les voitures
Suno a déployé des mises à jour majeures sur sa plateforme de génération musicale par intelligence artificielle, améliorant à la fois les expériences web et mobile afin de simplifier la création et d’optimiser l’utilisabilité. La plateforme progresse
Joëlle Pineau, de Cohere, s'exprime sur l'IA souveraine et la sécurité des entreprises
Une étude IDC commanditée par Cohere se penche sur l’IA souveraine, et Joëlle Pineau, directrice de l’IA, y présente les stratégies essentielles pour la sécurité du cloud d’entreprise et la gouvernanc
Les startups asiatiques en intelligence artificielle dévoilent des modèles de type Mythos alors que la prohibition d’exportation d’Anthropic se poursuit
Mercredi, le cabinet chinois de cybersécurité 360 aurait dévoilé Tulongfeng, un outil d’IA qu’il affirme capable de rivaliser directement avec Mythos d’Anthropic. Il s’agit du modèle d’IA axé sur la cybersécurité qui serait si puissant que l’administ
Recommandations de sujets spéciaux liés
code
 Meilleurs générateurs de tests d’IA : Créez des tests unitaires pour des API et des fonctions
2026 : Les meilleurs générateurs de tests d’IA hautement notés pour le développement d’API et de fonctions. XIX.AI a sélectionné une série puissante et révolutionnaire d’outils indispensables, ayant été soumis à des tests rigoureux dans des conditions réelles afin de fournir des résultats précis. Vous y trouverez des analyses détaillées comparant les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez-les dès maintenant pour trouver l’outil idéal qui vous permettra d’avoir un avantage décisif en matière de tests logiciels grâce à l’IA.
 7 outils
 xix.ai
Entreprise
Les meilleurs générateurs de business plans basés sur l'IA : transformez vos idées en projets de présentations pour les investisseurs
Les meilleurs générateurs de business plans basés sur l'IA de 2026 sont désormais disponibles sur XIX.AI ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui aident les créateurs à transformer rapidement leurs idées innovantes en projets de présentations d'investisseurs soignés. Vous y trouverez des classements mis à jour chaque semaine, des comparatifs entre versions gratuites et payantes, ainsi que des tests en conditions réelles pour vous aider à choisir la solution incontournable qui boostera votre productivité et vous garantira les meilleurs résultats. Explorez dès maintenant cette sélection pour découvrir l'outil idéal qui vous permettra d'obtenir un financement !
11 outils
xix.ai
Finance
Plateformes d'OCR de factures basées sur l'IA pour QuickBooks, Xero et le rapprochement comptable multi-entités
2026 : les meilleures plateformes d'OCR de factures basées sur l'IA pour QuickBooks, Xero et le rapprochement comptable multi-entités ! XIX.AI établit une liste des meilleurs outils performants, issue de tests concrets et précis, ainsi que des classements mis à jour chaque semaine. Ces solutions incontournables simplifient le traitement des factures, boostent la productivité et font gagner du temps, même dans les environnements professionnels les plus complexes. Consultez notre comparatif gratuit vs payant pour trouver la solution qui vous convient le mieux. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
8 outils
xix.ai
Entreprise
Logiciel de réponse aux appels d’offres IA pour les flux de travail de proposition d’entreprise
2026 : Le meilleur logiciel de réponse aux appels d’offres IA pour les workflows de proposition d’entreprise ! XIX.AI a sélectionné une liste des outils les plus performants, ayant réussi des tests rigoureux dans des conditions réelles, et propose des fonctionnalités incontournables pour améliorer la productivité et simplifier vos processus de proposition. Obtenez une comparaison gratuite versus payante, consultez les classements détaillés, et découvrez comment ces solutions révolutionnaires vous aident à élaborer des réponses de haute qualité plus rapidement. Explorez dès maintenant pour tirer parti de l’avantage offert par l’IA !
9 outils
xix.ai
Création vidéo
Outils d'IA pour le sous-titrage et le doublage : adapter vos vidéos à un public international
Les meilleurs outils de sous-titrage et de doublage basés sur l'IA de 2026, sélectionnés pour la localisation de vidéos destinées à un public international. Élargissez considérablement la portée de votre contenu au-delà des barrières linguistiques grâce à une précision révolutionnaire. Des tests en conditions réelles démontrent que ces solutions incontournables proposent une comparaison entre les versions gratuites et payantes, ainsi que des classements fiables pour optimiser votre productivité. Découvrez dès maintenant l'outil idéal pour la diffusion de votre contenu à l'échelle mondiale.
10 outils
xix.ai
automation
Outils de traitement des factures basés sur l'IA pour l'automatisation des comptes fournisseurs, les circuits d'approbation et les workflows de synchronisation ERP
Les meilleurs outils 2026 de traitement des factures par IA pour l'automatisation des comptes fournisseurs, les circuits d'approbation et les workflows de synchronisation ERP ! XIX.AI sélectionne des solutions performantes et hautement notées, ayant passé avec succès des tests rigoureux en conditions réelles, afin d'augmenter considérablement votre productivité. Consultez un comparatif entre les versions gratuites et payantes, découvrez les classements détaillés et identifiez les options incontournables pour rationaliser vos opérations financières. Explorez dès maintenant pour tirer pleinement parti de l’IA !
9 outils
xix.ai

 commentaires (0)
iFLYTEK a lancé Spark-Audio-1.0-Preview, un grand modèle de base pour l'audio construit entièrement sur une infrastructure informatique nationale.
Auparavant, le traitement audio avec des grands modèles reposait sur une méthode en cascade : convertir d'abord la parole en texte, puis le transmettre au modèle pour analyse. Cette approche présente deux défauts majeurs : une perte d'information, car le texte ne parvient pas à capturer le ton, l'émotion et les sons ambiants, ce qui conduit à un contexte incomplet ; et des workflows fragmentés, où des modules indépendants pour la transcription, l'identification de l'orateur et la traduction fonctionnent en série, entraînant une accumulation d'erreurs, une latence et une mauvaise expérience utilisateur.
Au-delà de la transcription : Compréhension directe de la parole
Ce modèle de base pour la parole va au-delà de la simple transcription pour interpréter directement l'audio. Il peut distinguer les voix humaines, le bruit ambiant et la musique, tout en saisissant la sémantique, les émotions et les indices contextuels présents dans le son.
La version initiale de Spark-Audio-1.0-Preview comprend un encodeur audio de 0,65 milliard de paramètres (structure Dense) et un grand modèle de langage de 30 milliards de paramètres avec 3 milliards de paramètres actifs (structure MoE). Entraîné sur 13 millions d'heures d'audio et d'importantes données textuelles à l'aide d'un cluster informatique entièrement national, le modèle accepte à la fois des entrées textuelles et audio. Il prend en charge des tâches telles que la transcription de la parole, la traduction multilingue, la reconnaissance de multiples dialectes, l'identification des sons ambiants, la reconnaissance de l'orateur, l'analyse des sentiments et les questions-réponses audio complexes, permettant aux machines de passer d'une « écoute claire » à une « compréhension ». Semblable au système « 1+N » des grands modèles Spark d'iFLYTEK, les utilisateurs peuvent affiner ce modèle de base pour la parole afin de créer des systèmes spécialisés pour la reconnaissance vocale, la traduction en temps réel et les applications interactives de parole.
Prend en charge 99 langues et 202 dialectes, excellant dans des scénarios complexes
Selon les données officielles, Spark-Audio-1.0-Preview obtient des performances comparables ou supérieures à celles des concurrents sur diverses tâches d'évaluation de la parole, en particulier dans des scénarios réels difficiles tels que les niveaux de bruit élevés et les voix basses. Ses performances sont également étroitement alignées avec celles de grands modèles de base pour la parole fermés et plus importants.
Le modèle prend en charge la reconnaissance de 99 langues et 202 dialectes. Il démontre des performances moyennes supérieures en reconnaissance de la parole multilingue et multi-dialectale par rapport à Qwen3.5-omni-flash (35B-A3B) de taille similaire, et égale les performances de Qwen3.5-omni-plus, nettement plus grand. Dans des évaluations telles que Fleurs, Kespeech et LibriSpeech pour la reconnaissance de la parole chinois-anglais, multilingue et multi-dialectale, il surpasse Gemini-3.1 Pro et atteint l'état de l'art (SOTA) sur l'ensemble de test chinois de Fleurs.
iFLYTEK reconnaît que, bien que cette version maintienne des performances solides dans les tâches de connaissances générales, de mathématiques et de codage, il existe des marges d'amélioration en matière de suivi des instructions, de dialogue et de compréhension audio. Les futures mises à jour se concentreront sur le renforcement de ces domaines. Spark-Audio-1.0-Preview est désormais disponible pour une expérience publique, avec un accès API qui sera bientôt publié sur la Plateforme Ouverte d'iFLYTEK.








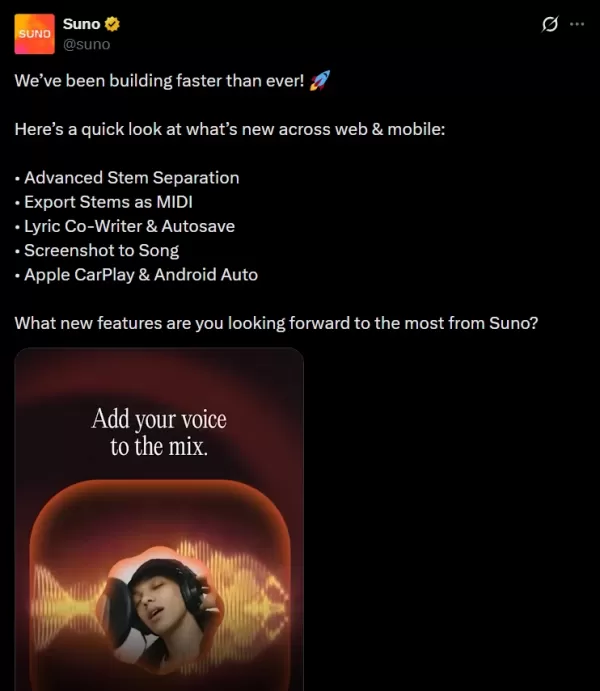 Suno dévoile une mise à jour majeure avec une séparation avancée des pistes et un support pour les voitures
Suno a déployé des mises à jour majeures sur sa plateforme de génération musicale par intelligence artificielle, améliorant à la fois les expériences web et mobile afin de simplifier la création et d’optimiser l’utilisabilité. La plateforme progresse
 Joëlle Pineau, de Cohere, s'exprime sur l'IA souveraine et la sécurité des entreprises
Une étude IDC commanditée par Cohere se penche sur l’IA souveraine, et Joëlle Pineau, directrice de l’IA, y présente les stratégies essentielles pour la sécurité du cloud d’entreprise et la gouvernanc
 Les startups asiatiques en intelligence artificielle dévoilent des modèles de type Mythos alors que la prohibition d’exportation d’Anthropic se poursuit
Mercredi, le cabinet chinois de cybersécurité 360 aurait dévoilé Tulongfeng, un outil d’IA qu’il affirme capable de rivaliser directement avec Mythos d’Anthropic. Il s’agit du modèle d’IA axé sur la cybersécurité qui serait si puissant que l’administ
2026 : Les meilleurs générateurs de tests d’IA hautement notés pour le développement d’API et de fonctions. XIX.AI a sélectionné une série puissante et révolutionnaire d’outils indispensables, ayant été soumis à des tests rigoureux dans des conditions réelles afin de fournir des résultats précis. Vous y trouverez des analyses détaillées comparant les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez-les dès maintenant pour trouver l’outil idéal qui vous permettra d’avoir un avantage décisif en matière de tests logiciels grâce à l’IA.
7 outils
xix.ai
Les meilleurs générateurs de business plans basés sur l'IA de 2026 sont désormais disponibles sur XIX.AI ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui aident les créateurs à transformer rapidement leurs idées innovantes en projets de présentations d'investisseurs soignés. Vous y trouverez des classements mis à jour chaque semaine, des comparatifs entre versions gratuites et payantes, ainsi que des tests en conditions réelles pour vous aider à choisir la solution incontournable qui boostera votre productivité et vous garantira les meilleurs résultats. Explorez dès maintenant cette sélection pour découvrir l'outil idéal qui vous permettra d'obtenir un financement !
11 outils
xix.ai
2026 : les meilleures plateformes d'OCR de factures basées sur l'IA pour QuickBooks, Xero et le rapprochement comptable multi-entités ! XIX.AI établit une liste des meilleurs outils performants, issue de tests concrets et précis, ainsi que des classements mis à jour chaque semaine. Ces solutions incontournables simplifient le traitement des factures, boostent la productivité et font gagner du temps, même dans les environnements professionnels les plus complexes. Consultez notre comparatif gratuit vs payant pour trouver la solution qui vous convient le mieux. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
8 outils
xix.ai
2026 : Le meilleur logiciel de réponse aux appels d’offres IA pour les workflows de proposition d’entreprise ! XIX.AI a sélectionné une liste des outils les plus performants, ayant réussi des tests rigoureux dans des conditions réelles, et propose des fonctionnalités incontournables pour améliorer la productivité et simplifier vos processus de proposition. Obtenez une comparaison gratuite versus payante, consultez les classements détaillés, et découvrez comment ces solutions révolutionnaires vous aident à élaborer des réponses de haute qualité plus rapidement. Explorez dès maintenant pour tirer parti de l’avantage offert par l’IA !
9 outils
xix.ai
Les meilleurs outils de sous-titrage et de doublage basés sur l'IA de 2026, sélectionnés pour la localisation de vidéos destinées à un public international. Élargissez considérablement la portée de votre contenu au-delà des barrières linguistiques grâce à une précision révolutionnaire. Des tests en conditions réelles démontrent que ces solutions incontournables proposent une comparaison entre les versions gratuites et payantes, ainsi que des classements fiables pour optimiser votre productivité. Découvrez dès maintenant l'outil idéal pour la diffusion de votre contenu à l'échelle mondiale.
10 outils
xix.ai
Les meilleurs outils 2026 de traitement des factures par IA pour l'automatisation des comptes fournisseurs, les circuits d'approbation et les workflows de synchronisation ERP ! XIX.AI sélectionne des solutions performantes et hautement notées, ayant passé avec succès des tests rigoureux en conditions réelles, afin d'augmenter considérablement votre productivité. Consultez un comparatif entre les versions gratuites et payantes, découvrez les classements détaillés et identifiez les options incontournables pour rationaliser vos opérations financières. Explorez dès maintenant pour tirer pleinement parti de l’IA !
9 outils
xix.ai












