


 首页
科大讯飞星火发布0.65B编码器语音模型,搭载30B混合专家架构,基于完全国产算力构建
科大讯飞推出了基于纯国产算力基础设施构建的语音基础大模型 Spark-Audio-1.0-Preview。
此前,基于大模型的音频处理主要依赖级联方式:先将语音转换为文本,再将其传递给模型进行分析。这种方法存在两大主要缺陷:一是信息丢失,因为文本无法捕捉语调、情感和背景声音,导致上下文不完整;二是工作流碎片化,转录、说话人识别和翻译等独立模块串行运行,导致误差累积、延迟增加以及用户体验不佳。
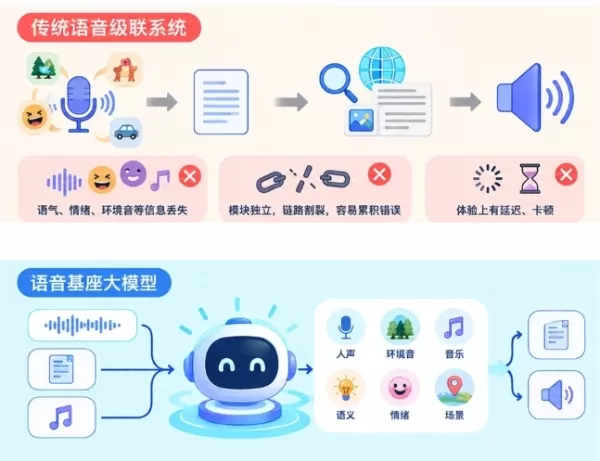
超越转录:直接语音理解
该语音基础大模型超越了简单的转录功能,能够直接解读音频。它可以区分人声、环境噪音和音乐,同时把握声音中的语义、情感和上下文线索。
初版 Spark-Audio-1.0-Preview 包含一个 0.65B 参数的音频编码器(密集结构)和一个 30B-A3B 参数的大语言模型(MoE 结构)。该模型基于完全国产算力集群,使用 1300 万小时的音频和大量文本数据进行训练,支持文本和音频双重输入。它支持语音转录、多语言翻译、多方言识别、环境音识别、说话人识别、情感分析和复杂音频问答等任务,使机器从“听得清”迈向“听得懂”。与科大讯飞星火大模型的“1+N”系统类似,用户可对该语音基础模型进行微调,构建针对语音识别、实时翻译和交互式语音应用的专用系统。
支持 99 种语言和 202 种方言,在复杂场景中表现卓越
根据官方数据,Spark-Audio-1.0-Preview 在各种语音评估任务中的表现与竞争对手相当或更优,特别是在高噪音和轻声说话等具有挑战性的真实场景中。其性能也与更大规模的闭源语音基础大模型高度一致。
该模型支持识别 99 种语言和 202 种方言。在类似规模的 Qwen3.5-omni-flash(35B-A3B)的多语言和多方言语音识别平均表现中,它展现出更优的性能,并达到了显著更大规模的 Qwen3.5-omni-plus 的性能水平。在 Fleurs、Kespeech 和 LibriSpeech 等针对中英、多语言和多方言语音识别的评估中,它优于 Gemini-3.1 Pro,并在 Fleurs 中文测试集上取得了 SOTA(当前最佳)成绩。
科大讯飞承认,虽然该版本在通用知识、数学和代码任务中保持了强劲性能,但在指令遵循、对话和音频理解方面仍有提升空间。未来的更新将重点加强这些领域。Spark-Audio-1.0-Preview 现已开放公众体验,API 接口即将在科大讯飞开放平台上线。
相关文章
 Zoho 助力企业采用人工智能客服机器人
市场正迅速向人工智能驱动的智能代理转型Zoho强调,人工智能正在呈指数级发展,企业必须适应这一趋势并重新思考其运营模式围绕人工智能的热潮丝毫没有减弱的迹象。要跟上最新发展,需要付出巨大的努力。随着模型规模的扩大、智能代理功能的增强,以及人们对“错失良机”的强烈担忧,每一位企业领导者都感受到必须设法将人工智能融入日常工作流程的压力。麦肯锡公司的一项研究显示,多达62%的受访者对AI智能代理表现出浓厚
Suno 发布重大更新,推出高级音轨分离与车载支持功能
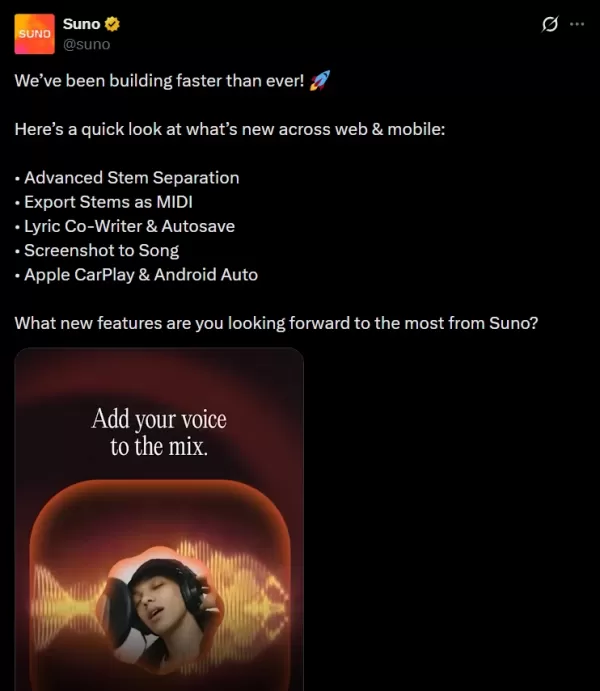
Suno 已对其 AI 音乐生成平台推出重大更新,优化了网页和移动端的体验,以简化创作流程并提升可用性。该平台正朝着更加便捷高效的 AI 音乐制作阶段迈进,将专业音频工具与驾驶等日常场景相结合。增强的音轨分离功能此次更新的一个主要亮点是高级音轨分离功能,该功能可将人声、鼓点、贝斯和乐器分离到独立的音轨中。这一能力使音乐人能够轻松获取高质量的分轨素材,用于混音或二次创作,显著降低了专业后期制作的门槛。分轨导出为 MIDI 文件用户现在可以直接将分离后的音轨导出为 MIDI 文件。这一功能对于需要在
Cohere公司的乔埃尔·皮诺谈主权人工智能与企业安全
由Cohere委托IDC开展的一项研究探讨了主权人工智能,首席人工智能官乔埃尔·皮诺(Joëlle Pineau)在报告中概述了企业云安全和数据治理的核心策略。根据IDC受人工智能公司Cohere委托发布的报告《2026年主权人工智能采用现状》,三分之一的商业领袖难以用自己的话定义“主权人工智能”。加拿大人工智能公司Cohere致力于开发专为企业应用设计的大型语言模型(LLMs)和自然语言处理工具
相关专题推荐
代码
 最佳 AI 测试生成器:为 API 和函数创建单元测试
2026年最新最佳高评分AI测试生成器,适用于API和函数开发。XIX.AI精心精选了一系列功能强大、颠覆性的必试工具,这些工具均经过严格的实际测试,可提供准确的测试结果。 您将在此找到免费版与付费版之间的详细对比分析,以及每周更新的排名榜单。立即探索,发现最适合您的工具,并在软件测试中释放您的AI优势。
 7 个工具
 xix.ai
商业
最佳 AI 商业计划书生成工具:将创意转化为投资者演示文稿草稿
2026年最新、最受欢迎的高评分AI商业计划书生成器已登陆XIX.AI!这一精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者快速将创新想法转化为完善的投资者演示文稿草稿。 您将看到每周更新的排行榜、免费版与付费版的对比分析,以及实际测试报告,这些内容将帮助您选择必试的解决方案,从而提升工作效率并取得最佳成果。立即探索,找到助您成功获得融资的完美工具!
11 个工具
xix.ai
金融
适用于 QuickBooks、Xero 以及多实体对账的人工智能发票 OCR 平台
2026年最新最佳AI发票OCR平台,适用于QuickBooks、Xero及多实体对账! XIX.AI 精心筛选出一系列广受好评的强大工具,这些工具经过精准的实际测试,并提供每周更新的排行榜。这些必试解决方案可简化发票处理流程,提升工作效率,并在复杂的业务环境中节省时间。获取免费版与付费版的对比指南,找到最适合您的方案。立即探索,释放您的AI优势!
8 个工具
xix.ai
商业
适用于企业提案工作流的 AI RFP 响应软件
2026年最先进的企业提案工作流专用AI RFP回复软件!XIX.AI精心整理了一份经过严格实际测试、评分极高的优质工具清单,其中包含诸多提升效率、简化提案流程的实用功能。您可以查看免费版与付费版的对比信息、详细的排名数据,了解这些具有颠覆性意义的解决方案如何帮助您更快地撰写出高质量回复。立即探索,让AI优势助力您的业务发展!
9 个工具
xix.ai
视频创作
AI字幕和配音工具:为全球观众本地化视频
2026年最新精选、评分最高的AI字幕和配音工具,专为面向全球受众的视频本地化而打造。凭借颠覆性的精准度,强力突破语言障碍,大幅提升内容覆盖范围。实际测试证明,这些必试解决方案提供了免费与付费版本的对比分析及可靠的排名,可最大限度地提高工作效率。立即探索,找到您进行全球内容分发的理想工具。
10 个工具
xix.ai
自动化
用于应付账款自动化、审批流转和ERP同步工作流的AI发票处理工具
2026年最新最佳AI发票处理工具,助力应付账款自动化、审批流转及ERP同步工作流!XIX.AI精选了经过严格实际测试、广受好评且功能强大的解决方案,可显著提升工作效率。 获取免费版与付费版对比分析,查看详细排名,并发现必试选项,以优化您的财务运营。立即探索,释放您的AI优势!
9 个工具
xix.ai

 评论 (0)
0/500
科大讯飞推出了基于纯国产算力基础设施构建的语音基础大模型 Spark-Audio-1.0-Preview。
此前,基于大模型的音频处理主要依赖级联方式:先将语音转换为文本,再将其传递给模型进行分析。这种方法存在两大主要缺陷:一是信息丢失,因为文本无法捕捉语调、情感和背景声音,导致上下文不完整;二是工作流碎片化,转录、说话人识别和翻译等独立模块串行运行,导致误差累积、延迟增加以及用户体验不佳。
超越转录:直接语音理解
该语音基础大模型超越了简单的转录功能,能够直接解读音频。它可以区分人声、环境噪音和音乐,同时把握声音中的语义、情感和上下文线索。
初版 Spark-Audio-1.0-Preview 包含一个 0.65B 参数的音频编码器(密集结构)和一个 30B-A3B 参数的大语言模型(MoE 结构)。该模型基于完全国产算力集群,使用 1300 万小时的音频和大量文本数据进行训练,支持文本和音频双重输入。它支持语音转录、多语言翻译、多方言识别、环境音识别、说话人识别、情感分析和复杂音频问答等任务,使机器从“听得清”迈向“听得懂”。与科大讯飞星火大模型的“1+N”系统类似,用户可对该语音基础模型进行微调,构建针对语音识别、实时翻译和交互式语音应用的专用系统。
支持 99 种语言和 202 种方言,在复杂场景中表现卓越
根据官方数据,Spark-Audio-1.0-Preview 在各种语音评估任务中的表现与竞争对手相当或更优,特别是在高噪音和轻声说话等具有挑战性的真实场景中。其性能也与更大规模的闭源语音基础大模型高度一致。
该模型支持识别 99 种语言和 202 种方言。在类似规模的 Qwen3.5-omni-flash(35B-A3B)的多语言和多方言语音识别平均表现中,它展现出更优的性能,并达到了显著更大规模的 Qwen3.5-omni-plus 的性能水平。在 Fleurs、Kespeech 和 LibriSpeech 等针对中英、多语言和多方言语音识别的评估中,它优于 Gemini-3.1 Pro,并在 Fleurs 中文测试集上取得了 SOTA(当前最佳)成绩。
科大讯飞承认,虽然该版本在通用知识、数学和代码任务中保持了强劲性能,但在指令遵循、对话和音频理解方面仍有提升空间。未来的更新将重点加强这些领域。Spark-Audio-1.0-Preview 现已开放公众体验,API 接口即将在科大讯飞开放平台上线。








 Zoho 助力企业采用人工智能客服机器人
市场正迅速向人工智能驱动的智能代理转型Zoho强调,人工智能正在呈指数级发展,企业必须适应这一趋势并重新思考其运营模式围绕人工智能的热潮丝毫没有减弱的迹象。要跟上最新发展,需要付出巨大的努力。随着模型规模的扩大、智能代理功能的增强,以及人们对“错失良机”的强烈担忧,每一位企业领导者都感受到必须设法将人工智能融入日常工作流程的压力。麦肯锡公司的一项研究显示,多达62%的受访者对AI智能代理表现出浓厚
 Suno 发布重大更新,推出高级音轨分离与车载支持功能
Suno 已对其 AI 音乐生成平台推出重大更新,优化了网页和移动端的体验,以简化创作流程并提升可用性。该平台正朝着更加便捷高效的 AI 音乐制作阶段迈进,将专业音频工具与驾驶等日常场景相结合。增强的音轨分离功能此次更新的一个主要亮点是高级音轨分离功能,该功能可将人声、鼓点、贝斯和乐器分离到独立的音轨中。这一能力使音乐人能够轻松获取高质量的分轨素材,用于混音或二次创作,显著降低了专业后期制作的门槛。分轨导出为 MIDI 文件用户现在可以直接将分离后的音轨导出为 MIDI 文件。这一功能对于需要在
 Cohere公司的乔埃尔·皮诺谈主权人工智能与企业安全
由Cohere委托IDC开展的一项研究探讨了主权人工智能,首席人工智能官乔埃尔·皮诺(Joëlle Pineau)在报告中概述了企业云安全和数据治理的核心策略。根据IDC受人工智能公司Cohere委托发布的报告《2026年主权人工智能采用现状》,三分之一的商业领袖难以用自己的话定义“主权人工智能”。加拿大人工智能公司Cohere致力于开发专为企业应用设计的大型语言模型(LLMs)和自然语言处理工具
2026年最新最佳高评分AI测试生成器,适用于API和函数开发。XIX.AI精心精选了一系列功能强大、颠覆性的必试工具,这些工具均经过严格的实际测试,可提供准确的测试结果。 您将在此找到免费版与付费版之间的详细对比分析,以及每周更新的排名榜单。立即探索,发现最适合您的工具,并在软件测试中释放您的AI优势。
7 个工具
xix.ai
2026年最新、最受欢迎的高评分AI商业计划书生成器已登陆XIX.AI!这一精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者快速将创新想法转化为完善的投资者演示文稿草稿。 您将看到每周更新的排行榜、免费版与付费版的对比分析,以及实际测试报告,这些内容将帮助您选择必试的解决方案,从而提升工作效率并取得最佳成果。立即探索,找到助您成功获得融资的完美工具!
11 个工具
xix.ai
2026年最新最佳AI发票OCR平台,适用于QuickBooks、Xero及多实体对账! XIX.AI 精心筛选出一系列广受好评的强大工具,这些工具经过精准的实际测试,并提供每周更新的排行榜。这些必试解决方案可简化发票处理流程,提升工作效率,并在复杂的业务环境中节省时间。获取免费版与付费版的对比指南,找到最适合您的方案。立即探索,释放您的AI优势!
8 个工具
xix.ai
2026年最先进的企业提案工作流专用AI RFP回复软件!XIX.AI精心整理了一份经过严格实际测试、评分极高的优质工具清单,其中包含诸多提升效率、简化提案流程的实用功能。您可以查看免费版与付费版的对比信息、详细的排名数据,了解这些具有颠覆性意义的解决方案如何帮助您更快地撰写出高质量回复。立即探索,让AI优势助力您的业务发展!
9 个工具
xix.ai
2026年最新精选、评分最高的AI字幕和配音工具,专为面向全球受众的视频本地化而打造。凭借颠覆性的精准度,强力突破语言障碍,大幅提升内容覆盖范围。实际测试证明,这些必试解决方案提供了免费与付费版本的对比分析及可靠的排名,可最大限度地提高工作效率。立即探索,找到您进行全球内容分发的理想工具。
10 个工具
xix.ai
2026年最新最佳AI发票处理工具,助力应付账款自动化、审批流转及ERP同步工作流!XIX.AI精选了经过严格实际测试、广受好评且功能强大的解决方案,可显著提升工作效率。 获取免费版与付费版对比分析,查看详细排名,并发现必试选项,以优化您的财务运营。立即探索,释放您的AI优势!
9 个工具
xix.ai












