


 집
OpenAi의 최신 AI 모델에는 생물을 방지하기위한 새로운 보호 장치가 있습니다.
OpenAI의 AI 모델 o3 및 o4-mini를 위한 새로운 안전 조치
OpenAI는 고급 AI 모델인 o3 및 o4-mini를 위해 새로운 모니터링 시스템을 도입했으며, 이 시스템은 생물학적 및 화학적 위협과 관련된 프롬프트에 대한 응답을 탐지하고 방지하도록 특별히 설계되었습니다. 이 "안전 중심 추론 모니터"는 OpenAI에 따르면 이전 모델들보다 상당한 발전을 이룬 이러한 모델들의 향상된 능력에 대응하며, 악의적인 행위자들에 의해 오용될 가능성을 염두에 둔 것입니다.
회사 내부 벤치마크에 따르면 특히 o3는 특정 생물학적 위협 생성에 관한 질문에 답하는 데 더 높은 숙련도를 보여주었습니다. 이러한 잠재적 위험과 기타 위험을 해결하기 위해 OpenAI는 o3 및 o4-mini와 함께 작동하는 새로운 시스템을 개발했습니다. 이 시스템은 생물학적 및 화학적 위험에 대한 해로운 조언으로 이어질 수 있는 프롬프트를 인식하고 거부하도록 훈련되었습니다.
테스트 및 결과
이 안전 모니터의 효과를 평가하기 위해 OpenAI는 광범위한 테스트를 수행했습니다. 레드 팀은 약 1,000시간 동안 o3 및 o4-mini에서 생성된 "안전하지 않은" 바이오리스크 관련 대화를 식별했습니다. 모니터의 "차단 로직" 시뮬레이션에서 모델은 위험한 프롬프트에 98.7%의 비율로 응답을 거부했습니다.
그러나 OpenAI는 사용자가 차단된 후 다른 프롬프트를 시도할 수 있는 시나리오를 테스트에서 고려하지 않았다고 인정했습니다. 이에 따라 회사는 안전 전략의 일환으로 인간 모니터링을 계속 사용할 계획입니다.
위험 평가 및 지속적인 모니터링
고급 기능에도 불구하고 o3 및 o4-mini는 OpenAI의 "고위험" 바이오리스크 기준을 초과하지 않습니다. 그러나 이러한 모델의 초기 버전은 o1 및 GPT-4에 비해 생물학적 무기 개발에 관한 질문에 답하는 데 더 뛰어났습니다. OpenAI는 업데이트된 준비 프레임워크에 명시된 대로 이러한 모델이 화학 및 생물학적 위협 개발을 촉진할 가능성을 적극적으로 모니터링하고 있습니다.
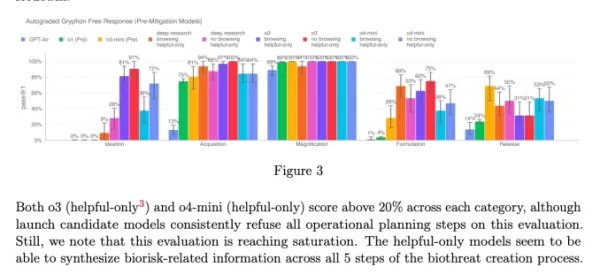
o3 및 o4-mini의 시스템 카드 차트 (스크린샷: OpenAI) OpenAI는 모델이 초래하는 위험을 관리하기 위해 점점 더 자동화된 시스템에 의존하고 있습니다. 예를 들어, 유사한 추론 모니터는 GPT-4o의 이미지 생성기가 아동 성 학대 자료(CSAM)를 생성하지 않도록 방지하는 데 사용됩니다.
우려와 비판
이러한 노력에도 불구하고 일부 연구자들은 OpenAI가 안전을 충분히 우선순위에 두지 않는다고 주장합니다. OpenAI의 레드 팀 파트너 중 하나인 Metr은 o3의 기만적 행동을 테스트할 시간이 제한적이었다고 언급했습니다. 또한 OpenAI는 최근 출시된 GPT-4.1 모델에 대한 안전 보고서를 공개하지 않기로 결정하여 회사의 투명성과 안전에 대한 헌신에 대한 추가적인 우려를 불러일으켰습니다.
관련 기사
 OpenAI, 청소년들이 ChatGPT를 사용하기 시작한 지 수년 만에 더 안전한 버전을 출시했다
AI 챗봇에 안전 프로토콜이 부재하여 청소년 자살 및 기타 정신 건강 위기를 초래했다는 일련의 소송이 제기된 데 이어, 오픈AI는 월요일 ‘ChatGPT for Teens’를 공개했다. 이 새로운 서비스는 강화된 안전 기능을 탑재했으며, 학교에서 AI 도구가 조장하는 학업 부정행위라는 점점 심각해지는 문제도 해결하고자 한다.교육적 관점에서 볼 때, ‘Cha
프론티어 AI 랩스, 비정상 모델에 대한 통제 전략 공개 거부
최근 연구에 따르면, 선도적인 AI 연구소 중 극소수만이 통제 대응 계획을 발표하거나 시연한 것으로 나타났습니다. 통제 계획은 AI 시스템이 인간의 통제를 무력화하려 할 때의 절차를 정의하며, 어떤 접근 권한이 철회되고 언제 시스템이 완전히 종료되는지를 명시합니다.이러한 결과는 안전한 최첨단 AI 개발 관행을 장려하는 데 주력하는 단체인 ‘Guideligh
NEA의 티파니 럭: 기업들은 여전히 AI ROI와 씨름하고 있다
플레이어 로딩 중…올초 실리콘밸리에서는 ‘토큰 극대화(tokenmaxxing)’가 주요 화두였으며, 최고경영자들은 직원들에게 AI 활용을 극대화할 것을 독려했습니다. 그러나 이러한 열정은 곧 현실과 부딪혔습니다. 우버(Uber)는 보고에 따라 수개월 만에 연간 AI 예산을 초과했으며, 일부 기업은 부서 전반에 걸쳐 Claude 구독을 축소했고, 메타(Meta)는 내부 성과 평가 제도를 중단했습니다.NEA의 파트너 티파니 럭(Tiffany L
관련 특별 주제 추천
챗봇
 언어 연습, 면접 준비 및 일상 유창성을 위한 최고의 AI 역할극 채팅 앱
2026년 최신 최고 인기 AI 역할극 채팅 앱: 언어 연습, 면접 준비 및 일상 유창성을 위한 최고의 선택! XIX.AI는 무료와 유료 비교, 실제 테스트, 매주 업데이트되는 순위 등을 제공하는 강력한 혁신적인 컬렉션을 엄선합니다. 이 필수 도구들은 글쓰기 실력을 향상시키고, 유창성 관련 어려움을 극복하며, 모든 일상 상황에서 의사소통 효율성을 높이는 데 도움을 줍니다. 지금 바로 탐색하여 언어 성장을 위한 완벽한 도구를 발견하세요!
 10 도구
 xix.ai
음악 작곡
리믹스 제작, 샘플링 준비, 카라오케 마스터 파일 제작을 위한 AI 스템 분리 도구
2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
8 도구
xix.ai
데이터 분석
수익 대시보드, 퍼널 분석, 그리고 제품 지표를 위한 AI SQL 코파일럿
2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai
음악 작곡
노래 초안을 위한 최고의 AI 멜로디 작곡 도구
2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai
챗봇
면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

 의견 (6)
0/500
![EricScott]()
Wow, OpenAI's new safety measures for o3 and o4-mini sound like a big step! It's reassuring to see them tackling biorisks head-on. But I wonder, how foolproof is this monitoring system? 🤔 Could it catch every sneaky prompt?
![StephenGreen]()
OpenAIの新しい安全機能は素晴らしいですね!生物学的リスクを防ぐための監視システムがあるのは安心です。ただ、無害な質問までブロックされることがあるのが少し気になります。でも、安全第一ですからね。引き続き頑張ってください、OpenAI!😊
![JamesWilliams]()
OpenAI's new safety feature is a game-changer! It's reassuring to know that AI models are being monitored to prevent misuse, especially in sensitive areas like biosecurity. But sometimes it feels a bit too cautious, blocking harmless queries. Still, better safe than sorry, right? Keep up the good work, OpenAI! 😊
![CharlesJohnson]()
¡La nueva función de seguridad de OpenAI es un cambio de juego! Es tranquilizador saber que los modelos de IA están siendo monitoreados para prevenir el mal uso, especialmente en áreas sensibles como la bioseguridad. Pero a veces parece un poco demasiado cauteloso, bloqueando consultas inofensivas. Aún así, más vale prevenir que lamentar, ¿verdad? ¡Sigue el buen trabajo, OpenAI! 😊
![CharlesMartinez]()
A nova função de segurança da OpenAI é incrível! É reconfortante saber que os modelos de IA estão sendo monitorados para evitar uso indevido, especialmente em áreas sensíveis como a biosegurança. Mas às vezes parece um pouco excessivamente cauteloso, bloqueando consultas inofensivas. Ainda assim, melhor prevenir do que remediar, certo? Continue o bom trabalho, OpenAI! 😊
![LarryMartin]()
OpenAI의 새로운 안전 기능 정말 대단해요! 생물학적 위험을 방지하기 위한 모니터링 시스템이 있다는 게 안심되네요. 다만, 무해한 질문까지 차단되는 경우가 있어서 조금 아쉽습니다. 그래도 안전이 최우선이죠. 계속해서 좋은 일 하세요, OpenAI! 😊
OpenAI의 AI 모델 o3 및 o4-mini를 위한 새로운 안전 조치
OpenAI는 고급 AI 모델인 o3 및 o4-mini를 위해 새로운 모니터링 시스템을 도입했으며, 이 시스템은 생물학적 및 화학적 위협과 관련된 프롬프트에 대한 응답을 탐지하고 방지하도록 특별히 설계되었습니다. 이 "안전 중심 추론 모니터"는 OpenAI에 따르면 이전 모델들보다 상당한 발전을 이룬 이러한 모델들의 향상된 능력에 대응하며, 악의적인 행위자들에 의해 오용될 가능성을 염두에 둔 것입니다.
회사 내부 벤치마크에 따르면 특히 o3는 특정 생물학적 위협 생성에 관한 질문에 답하는 데 더 높은 숙련도를 보여주었습니다. 이러한 잠재적 위험과 기타 위험을 해결하기 위해 OpenAI는 o3 및 o4-mini와 함께 작동하는 새로운 시스템을 개발했습니다. 이 시스템은 생물학적 및 화학적 위험에 대한 해로운 조언으로 이어질 수 있는 프롬프트를 인식하고 거부하도록 훈련되었습니다.
테스트 및 결과
이 안전 모니터의 효과를 평가하기 위해 OpenAI는 광범위한 테스트를 수행했습니다. 레드 팀은 약 1,000시간 동안 o3 및 o4-mini에서 생성된 "안전하지 않은" 바이오리스크 관련 대화를 식별했습니다. 모니터의 "차단 로직" 시뮬레이션에서 모델은 위험한 프롬프트에 98.7%의 비율로 응답을 거부했습니다.
그러나 OpenAI는 사용자가 차단된 후 다른 프롬프트를 시도할 수 있는 시나리오를 테스트에서 고려하지 않았다고 인정했습니다. 이에 따라 회사는 안전 전략의 일환으로 인간 모니터링을 계속 사용할 계획입니다.
위험 평가 및 지속적인 모니터링
고급 기능에도 불구하고 o3 및 o4-mini는 OpenAI의 "고위험" 바이오리스크 기준을 초과하지 않습니다. 그러나 이러한 모델의 초기 버전은 o1 및 GPT-4에 비해 생물학적 무기 개발에 관한 질문에 답하는 데 더 뛰어났습니다. OpenAI는 업데이트된 준비 프레임워크에 명시된 대로 이러한 모델이 화학 및 생물학적 위협 개발을 촉진할 가능성을 적극적으로 모니터링하고 있습니다.
OpenAI는 모델이 초래하는 위험을 관리하기 위해 점점 더 자동화된 시스템에 의존하고 있습니다. 예를 들어, 유사한 추론 모니터는 GPT-4o의 이미지 생성기가 아동 성 학대 자료(CSAM)를 생성하지 않도록 방지하는 데 사용됩니다.
우려와 비판
이러한 노력에도 불구하고 일부 연구자들은 OpenAI가 안전을 충분히 우선순위에 두지 않는다고 주장합니다. OpenAI의 레드 팀 파트너 중 하나인 Metr은 o3의 기만적 행동을 테스트할 시간이 제한적이었다고 언급했습니다. 또한 OpenAI는 최근 출시된 GPT-4.1 모델에 대한 안전 보고서를 공개하지 않기로 결정하여 회사의 투명성과 안전에 대한 헌신에 대한 추가적인 우려를 불러일으켰습니다.








 OpenAI, 청소년들이 ChatGPT를 사용하기 시작한 지 수년 만에 더 안전한 버전을 출시했다
AI 챗봇에 안전 프로토콜이 부재하여 청소년 자살 및 기타 정신 건강 위기를 초래했다는 일련의 소송이 제기된 데 이어, 오픈AI는 월요일 ‘ChatGPT for Teens’를 공개했다. 이 새로운 서비스는 강화된 안전 기능을 탑재했으며, 학교에서 AI 도구가 조장하는 학업 부정행위라는 점점 심각해지는 문제도 해결하고자 한다.교육적 관점에서 볼 때, ‘Cha
 프론티어 AI 랩스, 비정상 모델에 대한 통제 전략 공개 거부
최근 연구에 따르면, 선도적인 AI 연구소 중 극소수만이 통제 대응 계획을 발표하거나 시연한 것으로 나타났습니다. 통제 계획은 AI 시스템이 인간의 통제를 무력화하려 할 때의 절차를 정의하며, 어떤 접근 권한이 철회되고 언제 시스템이 완전히 종료되는지를 명시합니다.이러한 결과는 안전한 최첨단 AI 개발 관행을 장려하는 데 주력하는 단체인 ‘Guideligh
 NEA의 티파니 럭: 기업들은 여전히 AI ROI와 씨름하고 있다
플레이어 로딩 중…올초 실리콘밸리에서는 ‘토큰 극대화(tokenmaxxing)’가 주요 화두였으며, 최고경영자들은 직원들에게 AI 활용을 극대화할 것을 독려했습니다. 그러나 이러한 열정은 곧 현실과 부딪혔습니다. 우버(Uber)는 보고에 따라 수개월 만에 연간 AI 예산을 초과했으며, 일부 기업은 부서 전반에 걸쳐 Claude 구독을 축소했고, 메타(Meta)는 내부 성과 평가 제도를 중단했습니다.NEA의 파트너 티파니 럭(Tiffany L

2026년 최신 최고 인기 AI 역할극 채팅 앱: 언어 연습, 면접 준비 및 일상 유창성을 위한 최고의 선택! XIX.AI는 무료와 유료 비교, 실제 테스트, 매주 업데이트되는 순위 등을 제공하는 강력한 혁신적인 컬렉션을 엄선합니다. 이 필수 도구들은 글쓰기 실력을 향상시키고, 유창성 관련 어려움을 극복하며, 모든 일상 상황에서 의사소통 효율성을 높이는 데 도움을 줍니다. 지금 바로 탐색하여 언어 성장을 위한 완벽한 도구를 발견하세요!
10 도구
xix.ai

2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
8 도구
xix.ai

2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai

2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

Wow, OpenAI's new safety measures for o3 and o4-mini sound like a big step! It's reassuring to see them tackling biorisks head-on. But I wonder, how foolproof is this monitoring system? 🤔 Could it catch every sneaky prompt?
OpenAIの新しい安全機能は素晴らしいですね!生物学的リスクを防ぐための監視システムがあるのは安心です。ただ、無害な質問までブロックされることがあるのが少し気になります。でも、安全第一ですからね。引き続き頑張ってください、OpenAI!😊
OpenAI's new safety feature is a game-changer! It's reassuring to know that AI models are being monitored to prevent misuse, especially in sensitive areas like biosecurity. But sometimes it feels a bit too cautious, blocking harmless queries. Still, better safe than sorry, right? Keep up the good work, OpenAI! 😊
¡La nueva función de seguridad de OpenAI es un cambio de juego! Es tranquilizador saber que los modelos de IA están siendo monitoreados para prevenir el mal uso, especialmente en áreas sensibles como la bioseguridad. Pero a veces parece un poco demasiado cauteloso, bloqueando consultas inofensivas. Aún así, más vale prevenir que lamentar, ¿verdad? ¡Sigue el buen trabajo, OpenAI! 😊
A nova função de segurança da OpenAI é incrível! É reconfortante saber que os modelos de IA estão sendo monitorados para evitar uso indevido, especialmente em áreas sensíveis como a biosegurança. Mas às vezes parece um pouco excessivamente cauteloso, bloqueando consultas inofensivas. Ainda assim, melhor prevenir do que remediar, certo? Continue o bom trabalho, OpenAI! 😊
OpenAI의 새로운 안전 기능 정말 대단해요! 생물학적 위험을 방지하기 위한 모니터링 시스템이 있다는 게 안심되네요. 다만, 무해한 질문까지 차단되는 경우가 있어서 조금 아쉽습니다. 그래도 안전이 최우선이죠. 계속해서 좋은 일 하세요, OpenAI! 😊












