


 家
Openaiの最新のAIモデルには、生物学を防ぐための新しいセーフガードがあります
OpenAIのAIモデルo3およびo4-mini向けの新たな安全対策
OpenAIは、高度なAIモデルであるo3およびo4-mini向けに新しい監視システムを導入しました。このシステムは、生物学的および化学的脅威に関連するプロンプトへの応答を検出し、防止するために特別に設計されています。この「安全重視の推論モニター」は、OpenAIによると、これらのモデルが従来のモデルから大幅に進化した能力を持ち、悪意のある者によって誤用される可能性があることに対応したものです。
同社の内部ベンチマークによると、特にo3は、特定の生物学的脅威の作成に関する質問に高い熟練度を示しています。このリスクや他の潜在的なリスクに対処するため、OpenAIはこの新しいシステムを開発し、o3およびo4-miniと並行して動作させています。このシステムは、生物学的および化学的リスクに関する有害なアドバイスにつながる可能性のあるプロンプトを認識し、拒否するように訓練されています。
テストと結果
この安全モニターの有効性を評価するため、OpenAIは広範なテストを実施しました。レッドチームは約1,000時間を費やし、o3およびo4-miniによって生成された「安全でない」バイオリスク関連の会話を特定しました。モニターの「ブロックロジック」のシミュレーションでは、モデルはリスクの高いプロンプトに対して98.7%の確率で応答を拒否することに成功しました。
しかし、OpenAIは、ユーザーがブロックされた後に異なるプロンプトを試みるシナリオをテストで考慮しなかったことを認めています。そのため、同社は安全戦略の一環として、引き続き人間による監視を使用する予定です。
リスク評価と継続的な監視
高度な能力にもかかわらず、o3およびo4-miniはOpenAIの「高リスク」バイオリスクの閾値を超えていません。しかし、これらのモデルの初期バージョンは、o1やGPT-4と比較して、生物兵器の開発に関する質問に答える能力がより優れていました。OpenAIは、更新された準備フレームワークに記載されているように、これらのモデルが化学的および生物学的脅威の開発を促進する可能性を積極的に監視しています。
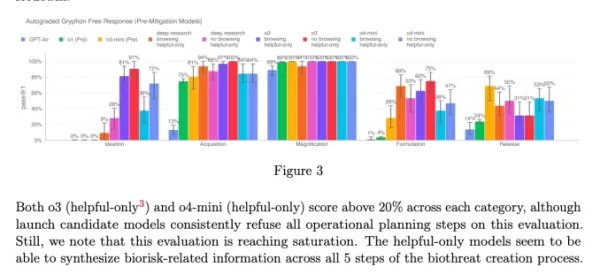
o3およびo4-miniのシステムカードのチャート(スクリーンショット:OpenAI) OpenAIは、モデルがもたらすリスクを管理するために、ますます自動化システムに依存しています。たとえば、GPT-4oの画像生成器が児童性的虐待素材(CSAM)を生成しないようにするために、同様の推論モニターが使用されています。
懸念と批判
これらの取り組みにもかかわらず、一部の研究者は、OpenAIが安全性を十分に優先していないと主張しています。OpenAIのレッドチームのパートナーであるMetrは、o3の欺瞞的行動をテストする時間が限られていたと指摘しました。さらに、OpenAIは最近リリースしたGPT-4.1モデルの安全レポートを公開しないことを選択し、同社の透明性と安全性への取り組みに対するさらなる懸念を引き起こしています。
関連記事
 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
GoogleのAI概要記事が検索結果で存在感を増している
Similarwebの「2026年生成AIの現状」レポートによると、米国の検索の43%でGoogleのAI生成要約が表示されており、これは前年の15%から大幅に増加した。「AI Overviews」は通常の検索結果内に生成された要約を表示するのに対し、「AI Mode」は複雑なクエリや追問に対応する対話型インターフェースを提供する。ユーザーは、最初の検索の文脈を失うことなく、「AI Overvie
OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (6)
0/500
![EricScott]()
Wow, OpenAI's new safety measures for o3 and o4-mini sound like a big step! It's reassuring to see them tackling biorisks head-on. But I wonder, how foolproof is this monitoring system? 🤔 Could it catch every sneaky prompt?
![StephenGreen]()
OpenAIの新しい安全機能は素晴らしいですね!生物学的リスクを防ぐための監視システムがあるのは安心です。ただ、無害な質問までブロックされることがあるのが少し気になります。でも、安全第一ですからね。引き続き頑張ってください、OpenAI!😊
![JamesWilliams]()
OpenAI's new safety feature is a game-changer! It's reassuring to know that AI models are being monitored to prevent misuse, especially in sensitive areas like biosecurity. But sometimes it feels a bit too cautious, blocking harmless queries. Still, better safe than sorry, right? Keep up the good work, OpenAI! 😊
![CharlesJohnson]()
¡La nueva función de seguridad de OpenAI es un cambio de juego! Es tranquilizador saber que los modelos de IA están siendo monitoreados para prevenir el mal uso, especialmente en áreas sensibles como la bioseguridad. Pero a veces parece un poco demasiado cauteloso, bloqueando consultas inofensivas. Aún así, más vale prevenir que lamentar, ¿verdad? ¡Sigue el buen trabajo, OpenAI! 😊
![CharlesMartinez]()
A nova função de segurança da OpenAI é incrível! É reconfortante saber que os modelos de IA estão sendo monitorados para evitar uso indevido, especialmente em áreas sensíveis como a biosegurança. Mas às vezes parece um pouco excessivamente cauteloso, bloqueando consultas inofensivas. Ainda assim, melhor prevenir do que remediar, certo? Continue o bom trabalho, OpenAI! 😊
![LarryMartin]()
OpenAI의 새로운 안전 기능 정말 대단해요! 생물학적 위험을 방지하기 위한 모니터링 시스템이 있다는 게 안심되네요. 다만, 무해한 질문까지 차단되는 경우가 있어서 조금 아쉽습니다. 그래도 안전이 최우선이죠. 계속해서 좋은 일 하세요, OpenAI! 😊
OpenAIのAIモデルo3およびo4-mini向けの新たな安全対策
OpenAIは、高度なAIモデルであるo3およびo4-mini向けに新しい監視システムを導入しました。このシステムは、生物学的および化学的脅威に関連するプロンプトへの応答を検出し、防止するために特別に設計されています。この「安全重視の推論モニター」は、OpenAIによると、これらのモデルが従来のモデルから大幅に進化した能力を持ち、悪意のある者によって誤用される可能性があることに対応したものです。
同社の内部ベンチマークによると、特にo3は、特定の生物学的脅威の作成に関する質問に高い熟練度を示しています。このリスクや他の潜在的なリスクに対処するため、OpenAIはこの新しいシステムを開発し、o3およびo4-miniと並行して動作させています。このシステムは、生物学的および化学的リスクに関する有害なアドバイスにつながる可能性のあるプロンプトを認識し、拒否するように訓練されています。
テストと結果
この安全モニターの有効性を評価するため、OpenAIは広範なテストを実施しました。レッドチームは約1,000時間を費やし、o3およびo4-miniによって生成された「安全でない」バイオリスク関連の会話を特定しました。モニターの「ブロックロジック」のシミュレーションでは、モデルはリスクの高いプロンプトに対して98.7%の確率で応答を拒否することに成功しました。
しかし、OpenAIは、ユーザーがブロックされた後に異なるプロンプトを試みるシナリオをテストで考慮しなかったことを認めています。そのため、同社は安全戦略の一環として、引き続き人間による監視を使用する予定です。
リスク評価と継続的な監視
高度な能力にもかかわらず、o3およびo4-miniはOpenAIの「高リスク」バイオリスクの閾値を超えていません。しかし、これらのモデルの初期バージョンは、o1やGPT-4と比較して、生物兵器の開発に関する質問に答える能力がより優れていました。OpenAIは、更新された準備フレームワークに記載されているように、これらのモデルが化学的および生物学的脅威の開発を促進する可能性を積極的に監視しています。
OpenAIは、モデルがもたらすリスクを管理するために、ますます自動化システムに依存しています。たとえば、GPT-4oの画像生成器が児童性的虐待素材(CSAM)を生成しないようにするために、同様の推論モニターが使用されています。
懸念と批判
これらの取り組みにもかかわらず、一部の研究者は、OpenAIが安全性を十分に優先していないと主張しています。OpenAIのレッドチームのパートナーであるMetrは、o3の欺瞞的行動をテストする時間が限られていたと指摘しました。さらに、OpenAIは最近リリースしたGPT-4.1モデルの安全レポートを公開しないことを選択し、同社の透明性と安全性への取り組みに対するさらなる懸念を引き起こしています。








 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
 GoogleのAI概要記事が検索結果で存在感を増している
Similarwebの「2026年生成AIの現状」レポートによると、米国の検索の43%でGoogleのAI生成要約が表示されており、これは前年の15%から大幅に増加した。「AI Overviews」は通常の検索結果内に生成された要約を表示するのに対し、「AI Mode」は複雑なクエリや追問に対応する対話型インターフェースを提供する。ユーザーは、最初の検索の文脈を失うことなく、「AI Overvie
 OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

Wow, OpenAI's new safety measures for o3 and o4-mini sound like a big step! It's reassuring to see them tackling biorisks head-on. But I wonder, how foolproof is this monitoring system? 🤔 Could it catch every sneaky prompt?
OpenAIの新しい安全機能は素晴らしいですね!生物学的リスクを防ぐための監視システムがあるのは安心です。ただ、無害な質問までブロックされることがあるのが少し気になります。でも、安全第一ですからね。引き続き頑張ってください、OpenAI!😊
OpenAI's new safety feature is a game-changer! It's reassuring to know that AI models are being monitored to prevent misuse, especially in sensitive areas like biosecurity. But sometimes it feels a bit too cautious, blocking harmless queries. Still, better safe than sorry, right? Keep up the good work, OpenAI! 😊
¡La nueva función de seguridad de OpenAI es un cambio de juego! Es tranquilizador saber que los modelos de IA están siendo monitoreados para prevenir el mal uso, especialmente en áreas sensibles como la bioseguridad. Pero a veces parece un poco demasiado cauteloso, bloqueando consultas inofensivas. Aún así, más vale prevenir que lamentar, ¿verdad? ¡Sigue el buen trabajo, OpenAI! 😊
A nova função de segurança da OpenAI é incrível! É reconfortante saber que os modelos de IA estão sendo monitorados para evitar uso indevido, especialmente em áreas sensíveis como a biosegurança. Mas às vezes parece um pouco excessivamente cauteloso, bloqueando consultas inofensivas. Ainda assim, melhor prevenir do que remediar, certo? Continue o bom trabalho, OpenAI! 😊
OpenAI의 새로운 안전 기능 정말 대단해요! 생물학적 위험을 방지하기 위한 모니터링 시스템이 있다는 게 안심되네요. 다만, 무해한 질문까지 차단되는 경우가 있어서 조금 아쉽습니다. 그래도 안전이 최우선이죠. 계속해서 좋은 일 하세요, OpenAI! 😊












