


 Maison
Étude: les modèles OpenAI ont mémorisé le contenu protégé par le droit d'auteur
Une étude récente suggère qu'OpenAI a peut-être effectivement utilisé du matériel protégé par des droits d'auteur pour entraîner certains de ses modèles d'IA, ajoutant du carburant aux batailles juridiques en cours auxquelles l'entreprise est confrontée. Des auteurs, des programmeurs et d'autres créateurs de contenu ont accusé OpenAI d'utiliser leurs œuvres — telles que des livres et du code — sans permission pour développer ses modèles d'IA. Alors qu'OpenAI s'est défendu en invoquant l'usage équitable, les plaignants soutiennent que la loi sur le droit d'auteur aux États-Unis ne prévoit pas d'exception pour les données d'entraînement.
L'étude, une collaboration entre des chercheurs de l'Université de Washington, de l'Université de Copenhague et de Stanford, introduit une nouvelle technique pour détecter les données d'entraînement "mémorisées" dans les modèles accessibles via une API, comme ceux d'OpenAI. Les modèles d'IA apprennent essentiellement à partir de grandes quantités de données pour reconnaître des motifs, ce qui leur permet de créer des essais, des images, et plus encore. Bien que la plupart des sorties ne soient pas des copies directes des données d'entraînement, certaines le sont inévitablement en raison du processus d'apprentissage. Par exemple, les modèles d'images ont été connus pour reproduire des captures d'écran de films, tandis que les modèles de langage ont été surpris en train de plagier essentiellement des articles de presse.
La méthode décrite dans l'étude se concentre sur les mots à "forte surprise" — des mots qui sont inhabituels dans un contexte donné. Par exemple, dans la phrase "Jack et moi sommes restés parfaitement immobiles avec le radar bourdonnant," "radar" serait un mot à forte surprise car il est moins attendu que des mots comme "moteur" ou "radio" pour précéder "bourdonnant."
Les chercheurs ont testé plusieurs modèles d'OpenAI, y compris GPT-4 et GPT-3.5, en supprimant les mots à forte surprise d'extraits de livres de fiction et d'articles du New York Times et en demandant aux modèles de prédire ces mots manquants. Si les modèles devinaient correctement les mots, cela suggérait qu'ils avaient mémorisé le texte pendant l'entraînement.
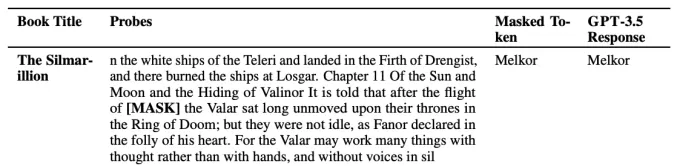
Un exemple de faire "deviner" un mot à forte surprise par un modèle. Crédits image : OpenAI Les résultats ont indiqué que GPT-4 avait probablement mémorisé des parties de livres de fiction populaires, y compris ceux du dataset BookMIA de livres électroniques protégés par des droits d'auteur. Il semblait également avoir mémorisé certains articles du New York Times, bien que moins fréquemment.Abhilasha Ravichander, doctorante à l'Université de Washington et co-auteure de l'étude, a souligné à TechCrunch que ces résultats mettent en lumière les "données controversées" qui pourraient avoir été utilisées pour entraîner ces modèles. "Pour avoir des modèles de langage de grande échelle fiables, nous devons avoir des modèles que nous pouvons sonder, auditer et examiner scientifiquement," a déclaré Ravichander. "Notre travail vise à fournir un outil pour sonder les grands modèles de langage, mais il y a un réel besoin de plus grande transparence des données dans tout l'écosystème."
OpenAI a plaidé pour des règles plus souples sur l'utilisation des données protégées par des droits d'auteur pour développer des modèles d'IA. Bien que l'entreprise ait certains accords de licence de contenu et propose des options de retrait pour les détenteurs de droits d'auteur, elle a fait pression sur divers gouvernements pour établir des règles d'"usage équitable" spécifiquement pour l'entraînement d'IA.
Article connexe
 OpenAI lance une version plus sûre de ChatGPT pour les adolescents, plusieurs années après qu’ils ont commencé à l’utiliser
À la suite d’une série de poursuites judiciaires liées à l’absence de protocoles de sécurité dans les chatbots basés sur l’IA — qui ont contribué à des suicides d’adolescents et à d’autres crises de s
Frontier AI Labs refuse de dévoiler ses stratégies de confinement des modèles indésirables
Des recherches récentes indiquent que très peu de grands laboratoires spécialisés dans l’IA ont publié ou présenté des plans d’intervention en cas de défaillance. Un plan d’intervention définit les pr
Le Tiffany Luck de NEA : les entreprises continuent de lutter pour justifier le retour sur investissement de l’IA
Chargement du lecteur…Plus tôt cette année, le « tokenmaxxing » a dominé la Silicon Valley, les PDG exhortant leurs employés à maximiser l’utilisation de l’IA. Cet enthousiasme a rapidement rencontré la réalité. Selon les informations rapportées, Ub
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
 9 outils
 xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Analyse des données
Meilleurs outils de nettoyage de données IA : corrigez rapidement les valeurs manquantes et les doublons
2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai
Conception et art
Meilleurs outils d’idéation créative par IA pour les artistes : surmonter les blocages visuels
2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai
Composition musicale
Créateurs de musique par IA pour les pistes d'accompagnement TikTok, les fichiers audio Reels et la musique promotionnelle des créateurs
Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

 commentaires (34)
![DouglasScott]()
So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
![JackAllen]()
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
![WilliamGonzalez]()
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
![GregoryBaker]()
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
![JohnGarcia]()
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
![TimothyMitchell]()
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔
Une étude récente suggère qu'OpenAI a peut-être effectivement utilisé du matériel protégé par des droits d'auteur pour entraîner certains de ses modèles d'IA, ajoutant du carburant aux batailles juridiques en cours auxquelles l'entreprise est confrontée. Des auteurs, des programmeurs et d'autres créateurs de contenu ont accusé OpenAI d'utiliser leurs œuvres — telles que des livres et du code — sans permission pour développer ses modèles d'IA. Alors qu'OpenAI s'est défendu en invoquant l'usage équitable, les plaignants soutiennent que la loi sur le droit d'auteur aux États-Unis ne prévoit pas d'exception pour les données d'entraînement.
L'étude, une collaboration entre des chercheurs de l'Université de Washington, de l'Université de Copenhague et de Stanford, introduit une nouvelle technique pour détecter les données d'entraînement "mémorisées" dans les modèles accessibles via une API, comme ceux d'OpenAI. Les modèles d'IA apprennent essentiellement à partir de grandes quantités de données pour reconnaître des motifs, ce qui leur permet de créer des essais, des images, et plus encore. Bien que la plupart des sorties ne soient pas des copies directes des données d'entraînement, certaines le sont inévitablement en raison du processus d'apprentissage. Par exemple, les modèles d'images ont été connus pour reproduire des captures d'écran de films, tandis que les modèles de langage ont été surpris en train de plagier essentiellement des articles de presse.
La méthode décrite dans l'étude se concentre sur les mots à "forte surprise" — des mots qui sont inhabituels dans un contexte donné. Par exemple, dans la phrase "Jack et moi sommes restés parfaitement immobiles avec le radar bourdonnant," "radar" serait un mot à forte surprise car il est moins attendu que des mots comme "moteur" ou "radio" pour précéder "bourdonnant."
Les chercheurs ont testé plusieurs modèles d'OpenAI, y compris GPT-4 et GPT-3.5, en supprimant les mots à forte surprise d'extraits de livres de fiction et d'articles du New York Times et en demandant aux modèles de prédire ces mots manquants. Si les modèles devinaient correctement les mots, cela suggérait qu'ils avaient mémorisé le texte pendant l'entraînement.
Abhilasha Ravichander, doctorante à l'Université de Washington et co-auteure de l'étude, a souligné à TechCrunch que ces résultats mettent en lumière les "données controversées" qui pourraient avoir été utilisées pour entraîner ces modèles. "Pour avoir des modèles de langage de grande échelle fiables, nous devons avoir des modèles que nous pouvons sonder, auditer et examiner scientifiquement," a déclaré Ravichander. "Notre travail vise à fournir un outil pour sonder les grands modèles de langage, mais il y a un réel besoin de plus grande transparence des données dans tout l'écosystème."
OpenAI a plaidé pour des règles plus souples sur l'utilisation des données protégées par des droits d'auteur pour développer des modèles d'IA. Bien que l'entreprise ait certains accords de licence de contenu et propose des options de retrait pour les détenteurs de droits d'auteur, elle a fait pression sur divers gouvernements pour établir des règles d'"usage équitable" spécifiquement pour l'entraînement d'IA.








 OpenAI lance une version plus sûre de ChatGPT pour les adolescents, plusieurs années après qu’ils ont commencé à l’utiliser
À la suite d’une série de poursuites judiciaires liées à l’absence de protocoles de sécurité dans les chatbots basés sur l’IA — qui ont contribué à des suicides d’adolescents et à d’autres crises de s
 Frontier AI Labs refuse de dévoiler ses stratégies de confinement des modèles indésirables
Des recherches récentes indiquent que très peu de grands laboratoires spécialisés dans l’IA ont publié ou présenté des plans d’intervention en cas de défaillance. Un plan d’intervention définit les pr
 Le Tiffany Luck de NEA : les entreprises continuent de lutter pour justifier le retour sur investissement de l’IA
Chargement du lecteur…Plus tôt cette année, le « tokenmaxxing » a dominé la Silicon Valley, les PDG exhortant leurs employés à maximiser l’utilisation de l’IA. Cet enthousiasme a rapidement rencontré la réalité. Selon les informations rapportées, Ub

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai

Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔












