


 Дом
Исследование: модели OpenAI запомнили контент, защищенные авторским правом
Недавнее исследование предполагает, что OpenAI действительно могла использовать материалы, защищенные авторским правом, для обучения некоторых своих моделей ИИ, что подогревает продолжающиеся судебные тяжбы, с которыми сталкивается компания. Авторы, программисты и другие создатели контента обвиняют OpenAI в использовании их произведений — таких как книги и код — без разрешения для разработки своих моделей ИИ. Хотя OpenAI защищается, ссылаясь на добросовестное использование, истцы утверждают, что закон США об авторском праве не предусматривает исключений для обучающих данных.
Исследование, проведенное в сотрудничестве между исследователями из Вашингтонского университета, Копенгагенского университета и Стэнфорда, представляет новую технику для обнаружения «запомненных» обучающих данных в моделях, доступных через API, таких как модели от OpenAI. Модели ИИ по сути обучаются на огромных объемах данных, чтобы распознавать шаблоны, что позволяет им создавать эссе, изображения и многое другое. Хотя большинство выходных данных не являются прямыми копиями обучающих данных, некоторые неизбежно оказываются таковыми из-за процесса обучения. Например, известно, что модели изображений воспроизводят скриншоты из фильмов, а языковые модели уличены в практически плагиате новостных статей.
Метод, описанный в исследовании, фокусируется на «высокоудивительных» словах — словах, которые необычны в данном контексте. Например, в предложении «Джек и я сидели совершенно неподвижно, пока радар гудел», слово «радар» будет высокоудивительным, поскольку оно менее ожидаемо, чем слова вроде «двигатель» или «радио» перед словом «гудел».
Исследователи протестировали несколько моделей OpenAI, включая GPT-4 и GPT-3.5, удаляя высокоудивительные слова из отрывков художественных книг и статей New York Times и прося модели предсказать эти пропущенные слова. Если модели точно угадывали слова, это указывало на то, что они запомнили текст во время обучения.
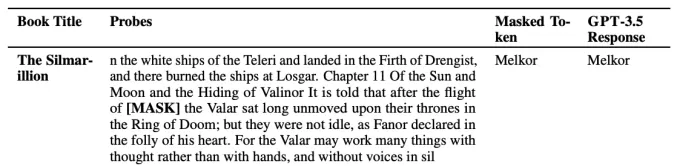
Пример того, как модель «угадывает» высокоудивительное слово. Источник изображения: OpenAI Результаты показали, что GPT-4, вероятно, запомнила части популярных художественных книг, включая те, что находятся в наборе данных BookMIA с защищенными авторским правом электронными книгами. Также оказалось, что она запомнила некоторые статьи New York Times, хотя и с меньшей частотой.Абилаша Равичандер, докторант Вашингтонского университета и соавтор исследования, подчеркнула в беседе с TechCrunch, что эти результаты подчеркивают «спорные данные», которые могли быть использованы для обучения этих моделей. «Чтобы иметь большие языковые модели, которым можно доверять, нам нужны модели, которые мы можем исследовать, проверять и изучать научно», — заявила Равичандер. «Наша работа направлена на предоставление инструмента для исследования больших языковых моделей, но существует реальная потребность в большей прозрачности данных во всей экосистеме».
OpenAI настаивает на более мягких правилах использования данных, защищенных авторским правом, для разработки моделей ИИ. Хотя у компании есть некоторые соглашения о лицензировании контента и она предлагает варианты отказа для правообладателей, она лоббировала различные правительства, чтобы установить правила «добросовестного использования» специально для обучения ИИ.
Связанная статья
 OpenAI запускает более безопасную версию ChatGPT для подростков спустя несколько лет после того, как они начали ею пользоваться
После серии судебных исков, связанных с отсутствием протоколов безопасности в чат-ботах на базе ИИ — что стало одной из причин самоубийств подростков и других кризисов, связанных с психическим здоровь
Frontier AI Labs отказывается раскрывать стратегии локализации неконтролируемых моделей
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдержи
Tiffany Luck из NEA: Компании по-прежнему борются с вопросами окупаемости инвестиций в ИИ
Загрузка плеера…Ранее в этом году «токеномаксимизация» доминировала в Кремниевой долине, когда генеральные директора призывали сотрудников максимально использовать возможности искусственного интеллекта. Однако этот энтузиазм быстро столкнулся с реал
Рекомендации по связанным специальным темам
Музыкальная композиция
 Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
 8 инструментов
 xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai
Помощник по встречам
Лучшие инструменты для составления отчетов о встречах с использованием ИИ: четкое отслеживание решений и последующих действий
2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai
Анализ данных
Лучшие инструменты для очистки данных с использованием ИИ: быстрое устранение пропущенных значений и дубликатов
2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai

 Комментарии (34)
![DouglasScott]()
So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
![JackAllen]()
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
![WilliamGonzalez]()
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
![GregoryBaker]()
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
![JohnGarcia]()
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
![TimothyMitchell]()
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔
Недавнее исследование предполагает, что OpenAI действительно могла использовать материалы, защищенные авторским правом, для обучения некоторых своих моделей ИИ, что подогревает продолжающиеся судебные тяжбы, с которыми сталкивается компания. Авторы, программисты и другие создатели контента обвиняют OpenAI в использовании их произведений — таких как книги и код — без разрешения для разработки своих моделей ИИ. Хотя OpenAI защищается, ссылаясь на добросовестное использование, истцы утверждают, что закон США об авторском праве не предусматривает исключений для обучающих данных.
Исследование, проведенное в сотрудничестве между исследователями из Вашингтонского университета, Копенгагенского университета и Стэнфорда, представляет новую технику для обнаружения «запомненных» обучающих данных в моделях, доступных через API, таких как модели от OpenAI. Модели ИИ по сути обучаются на огромных объемах данных, чтобы распознавать шаблоны, что позволяет им создавать эссе, изображения и многое другое. Хотя большинство выходных данных не являются прямыми копиями обучающих данных, некоторые неизбежно оказываются таковыми из-за процесса обучения. Например, известно, что модели изображений воспроизводят скриншоты из фильмов, а языковые модели уличены в практически плагиате новостных статей.
Метод, описанный в исследовании, фокусируется на «высокоудивительных» словах — словах, которые необычны в данном контексте. Например, в предложении «Джек и я сидели совершенно неподвижно, пока радар гудел», слово «радар» будет высокоудивительным, поскольку оно менее ожидаемо, чем слова вроде «двигатель» или «радио» перед словом «гудел».
Исследователи протестировали несколько моделей OpenAI, включая GPT-4 и GPT-3.5, удаляя высокоудивительные слова из отрывков художественных книг и статей New York Times и прося модели предсказать эти пропущенные слова. Если модели точно угадывали слова, это указывало на то, что они запомнили текст во время обучения.
Абилаша Равичандер, докторант Вашингтонского университета и соавтор исследования, подчеркнула в беседе с TechCrunch, что эти результаты подчеркивают «спорные данные», которые могли быть использованы для обучения этих моделей. «Чтобы иметь большие языковые модели, которым можно доверять, нам нужны модели, которые мы можем исследовать, проверять и изучать научно», — заявила Равичандер. «Наша работа направлена на предоставление инструмента для исследования больших языковых моделей, но существует реальная потребность в большей прозрачности данных во всей экосистеме».
OpenAI настаивает на более мягких правилах использования данных, защищенных авторским правом, для разработки моделей ИИ. Хотя у компании есть некоторые соглашения о лицензировании контента и она предлагает варианты отказа для правообладателей, она лоббировала различные правительства, чтобы установить правила «добросовестного использования» специально для обучения ИИ.








 OpenAI запускает более безопасную версию ChatGPT для подростков спустя несколько лет после того, как они начали ею пользоваться
После серии судебных исков, связанных с отсутствием протоколов безопасности в чат-ботах на базе ИИ — что стало одной из причин самоубийств подростков и других кризисов, связанных с психическим здоровь
 Frontier AI Labs отказывается раскрывать стратегии локализации неконтролируемых моделей
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдержи
 Tiffany Luck из NEA: Компании по-прежнему борются с вопросами окупаемости инвестиций в ИИ
Загрузка плеера…Ранее в этом году «токеномаксимизация» доминировала в Кремниевой долине, когда генеральные директора призывали сотрудников максимально использовать возможности искусственного интеллекта. Однако этот энтузиазм быстро столкнулся с реал

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai

So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔












