


 집
연구 : OpenAI 모델은 저작권이있는 컨텐츠를 암기합니다
최근 연구에 따르면 OpenAI가 일부 AI 모델 훈련에 저작권이 있는 자료를 실제로 사용했을 가능성이 있으며, 이는 회사가 직면한 지속적인 법적 분쟁에 불을 붙이고 있습니다. 작가, 프로그래머, 기타 콘텐츠 제작자들은 OpenAI가 책과 코드와 같은 그들의 작품을 허가 없이 AI 모델 개발에 사용했다고 비난해 왔습니다. OpenAI는 공정 사용(fair use)을 주장하며 스스로를 방어했지만, 원고들은 미국 저작권법이 훈련 데이터에 대한 예외를 제공하지 않는다고 주장합니다.
워싱턴 대학교, 코펜하겐 대학교, 스탠포드 대학교의 연구자들 간의 협력으로 진행된 이 연구는 OpenAI와 같은 API를 통해 접근 가능한 모델에서 "기억된" 훈련 데이터를 탐지하는 새로운 기술을 소개합니다. AI 모델은 방대한 데이터에서 패턴을 인식하도록 학습하여 에세이, 이미지 등을 생성할 수 있습니다. 대부분의 출력은 훈련 데이터의 직접적인 복사본이 아니지만, 학습 과정으로 인해 일부는 필연적으로 그러합니다. 예를 들어, 이미지 모델은 영화 스크린샷을 재현하는 것으로 알려져 있으며, 언어 모델은 뉴스 기사를 사실상 표절한 것으로 적발되었습니다.
연구에서 설명된 방법은 "고-놀람(high-surprisal)" 단어, 즉 주어진 문맥에서 드문 단어에 초점을 맞춥니다. 예를 들어, "Jack과 내가 레이더가 윙윙거리며 완벽히 가만히 앉아 있었다"라는 문장에서 "레이더"는 "엔진"이나 "라디오" 같은 단어보다 "윙윙거리다" 앞에 나올 가능성이 낮아 고-놀람 단어로 간주됩니다.
연구자들은 GPT-4와 GPT-3.5를 포함한 여러 OpenAI 모델을 테스트했으며, 소설 책과 뉴욕 타임스 기사 발췌문에서 고-놀람 단어를 제거한 후 모델이 이 누락된 단어를 예측하도록 요청했습니다. 모델이 단어를 정확히 맞췄다면, 이는 훈련 중 해당 텍스트를 기억했을 가능성을 시사합니다.
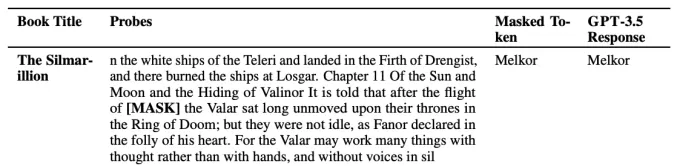
모델이 고-놀람 단어를 "추측"하는 예시. 이미지 제공: OpenAI 결과는 GPT-4가 BookMIA 데이터셋의 저작권이 있는 전자책을 포함한 인기 소설 책의 일부를 기억했을 가능성이 높음을 나타냈습니다. 또한 뉴욕 타임스 기사의 일부도 기억했을 가능성이 있지만, 그 빈도는 더 낮았습니다.워싱턴 대학교 박사 과정 학생이자 연구 공동 저자인 Abhilasha Ravichander는 TechCrunch에 이러한 결과가 모델 훈련에 사용되었을 가능성이 있는 "논란이 되는 데이터"를 강조한다고 말했습니다. "신뢰할 수 있는 대규모 언어 모델을 가지려면, 우리가 과학적으로 조사하고 감사하며 검토할 수 있는 모델이 필요합니다,"라고 Ravichander는 전했습니다. "우리의 작업은 대규모 언어 모델을 조사할 도구를 제공하는 것을 목표로 하지만, 전체 생태계에서 데이터 투명성이 더 필요합니다."
OpenAI는 AI 모델 개발에 저작권이 있는 데이터를 사용하는 데 있어 보다 완화된 규칙을 추진해 왔습니다. 회사는 일부 콘텐츠 라이선스 계약을 체결하고 저작권 소유자에게 옵트아웃 옵션을 제공했지만, AI 훈련에 특화된 "공정 사용" 규칙을 제정하도록 여러 정부에 로비해 왔습니다.
관련 기사
 OpenAI, 청소년들이 ChatGPT를 사용하기 시작한 지 수년 만에 더 안전한 버전을 출시했다
AI 챗봇에 안전 프로토콜이 부재하여 청소년 자살 및 기타 정신 건강 위기를 초래했다는 일련의 소송이 제기된 데 이어, 오픈AI는 월요일 ‘ChatGPT for Teens’를 공개했다. 이 새로운 서비스는 강화된 안전 기능을 탑재했으며, 학교에서 AI 도구가 조장하는 학업 부정행위라는 점점 심각해지는 문제도 해결하고자 한다.교육적 관점에서 볼 때, ‘Cha
프론티어 AI 랩스, 비정상 모델에 대한 통제 전략 공개 거부
최근 연구에 따르면, 선도적인 AI 연구소 중 극소수만이 통제 대응 계획을 발표하거나 시연한 것으로 나타났습니다. 통제 계획은 AI 시스템이 인간의 통제를 무력화하려 할 때의 절차를 정의하며, 어떤 접근 권한이 철회되고 언제 시스템이 완전히 종료되는지를 명시합니다.이러한 결과는 안전한 최첨단 AI 개발 관행을 장려하는 데 주력하는 단체인 ‘Guideligh
NEA의 티파니 럭: 기업들은 여전히 AI ROI와 씨름하고 있다
플레이어 로딩 중…올초 실리콘밸리에서는 ‘토큰 극대화(tokenmaxxing)’가 주요 화두였으며, 최고경영자들은 직원들에게 AI 활용을 극대화할 것을 독려했습니다. 그러나 이러한 열정은 곧 현실과 부딪혔습니다. 우버(Uber)는 보고에 따라 수개월 만에 연간 AI 예산을 초과했으며, 일부 기업은 부서 전반에 걸쳐 Claude 구독을 축소했고, 메타(Meta)는 내부 성과 평가 제도를 중단했습니다.NEA의 파트너 티파니 럭(Tiffany L
관련 특별 주제 추천
음악 작곡
 리믹스 제작, 샘플링 준비, 카라오케 마스터 파일 제작을 위한 AI 스템 분리 도구
2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
 8 도구
 xix.ai
데이터 분석
수익 대시보드, 퍼널 분석, 그리고 제품 지표를 위한 AI SQL 코파일럿
2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai
음악 작곡
노래 초안을 위한 최고의 AI 멜로디 작곡 도구
2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai
챗봇
면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai
만화 창작
시각적 스토리텔링을 위한 최고의 AI 대화 풍선 도구
2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

 의견 (34)
0/500
![DouglasScott]()
So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
![JackAllen]()
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
![WilliamGonzalez]()
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
![GregoryBaker]()
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
![JohnGarcia]()
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
![TimothyMitchell]()
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔
최근 연구에 따르면 OpenAI가 일부 AI 모델 훈련에 저작권이 있는 자료를 실제로 사용했을 가능성이 있으며, 이는 회사가 직면한 지속적인 법적 분쟁에 불을 붙이고 있습니다. 작가, 프로그래머, 기타 콘텐츠 제작자들은 OpenAI가 책과 코드와 같은 그들의 작품을 허가 없이 AI 모델 개발에 사용했다고 비난해 왔습니다. OpenAI는 공정 사용(fair use)을 주장하며 스스로를 방어했지만, 원고들은 미국 저작권법이 훈련 데이터에 대한 예외를 제공하지 않는다고 주장합니다.
워싱턴 대학교, 코펜하겐 대학교, 스탠포드 대학교의 연구자들 간의 협력으로 진행된 이 연구는 OpenAI와 같은 API를 통해 접근 가능한 모델에서 "기억된" 훈련 데이터를 탐지하는 새로운 기술을 소개합니다. AI 모델은 방대한 데이터에서 패턴을 인식하도록 학습하여 에세이, 이미지 등을 생성할 수 있습니다. 대부분의 출력은 훈련 데이터의 직접적인 복사본이 아니지만, 학습 과정으로 인해 일부는 필연적으로 그러합니다. 예를 들어, 이미지 모델은 영화 스크린샷을 재현하는 것으로 알려져 있으며, 언어 모델은 뉴스 기사를 사실상 표절한 것으로 적발되었습니다.
연구에서 설명된 방법은 "고-놀람(high-surprisal)" 단어, 즉 주어진 문맥에서 드문 단어에 초점을 맞춥니다. 예를 들어, "Jack과 내가 레이더가 윙윙거리며 완벽히 가만히 앉아 있었다"라는 문장에서 "레이더"는 "엔진"이나 "라디오" 같은 단어보다 "윙윙거리다" 앞에 나올 가능성이 낮아 고-놀람 단어로 간주됩니다.
연구자들은 GPT-4와 GPT-3.5를 포함한 여러 OpenAI 모델을 테스트했으며, 소설 책과 뉴욕 타임스 기사 발췌문에서 고-놀람 단어를 제거한 후 모델이 이 누락된 단어를 예측하도록 요청했습니다. 모델이 단어를 정확히 맞췄다면, 이는 훈련 중 해당 텍스트를 기억했을 가능성을 시사합니다.
워싱턴 대학교 박사 과정 학생이자 연구 공동 저자인 Abhilasha Ravichander는 TechCrunch에 이러한 결과가 모델 훈련에 사용되었을 가능성이 있는 "논란이 되는 데이터"를 강조한다고 말했습니다. "신뢰할 수 있는 대규모 언어 모델을 가지려면, 우리가 과학적으로 조사하고 감사하며 검토할 수 있는 모델이 필요합니다,"라고 Ravichander는 전했습니다. "우리의 작업은 대규모 언어 모델을 조사할 도구를 제공하는 것을 목표로 하지만, 전체 생태계에서 데이터 투명성이 더 필요합니다."
OpenAI는 AI 모델 개발에 저작권이 있는 데이터를 사용하는 데 있어 보다 완화된 규칙을 추진해 왔습니다. 회사는 일부 콘텐츠 라이선스 계약을 체결하고 저작권 소유자에게 옵트아웃 옵션을 제공했지만, AI 훈련에 특화된 "공정 사용" 규칙을 제정하도록 여러 정부에 로비해 왔습니다.








 OpenAI, 청소년들이 ChatGPT를 사용하기 시작한 지 수년 만에 더 안전한 버전을 출시했다
AI 챗봇에 안전 프로토콜이 부재하여 청소년 자살 및 기타 정신 건강 위기를 초래했다는 일련의 소송이 제기된 데 이어, 오픈AI는 월요일 ‘ChatGPT for Teens’를 공개했다. 이 새로운 서비스는 강화된 안전 기능을 탑재했으며, 학교에서 AI 도구가 조장하는 학업 부정행위라는 점점 심각해지는 문제도 해결하고자 한다.교육적 관점에서 볼 때, ‘Cha
 프론티어 AI 랩스, 비정상 모델에 대한 통제 전략 공개 거부
최근 연구에 따르면, 선도적인 AI 연구소 중 극소수만이 통제 대응 계획을 발표하거나 시연한 것으로 나타났습니다. 통제 계획은 AI 시스템이 인간의 통제를 무력화하려 할 때의 절차를 정의하며, 어떤 접근 권한이 철회되고 언제 시스템이 완전히 종료되는지를 명시합니다.이러한 결과는 안전한 최첨단 AI 개발 관행을 장려하는 데 주력하는 단체인 ‘Guideligh
 NEA의 티파니 럭: 기업들은 여전히 AI ROI와 씨름하고 있다
플레이어 로딩 중…올초 실리콘밸리에서는 ‘토큰 극대화(tokenmaxxing)’가 주요 화두였으며, 최고경영자들은 직원들에게 AI 활용을 극대화할 것을 독려했습니다. 그러나 이러한 열정은 곧 현실과 부딪혔습니다. 우버(Uber)는 보고에 따라 수개월 만에 연간 AI 예산을 초과했으며, 일부 기업은 부서 전반에 걸쳐 Claude 구독을 축소했고, 메타(Meta)는 내부 성과 평가 제도를 중단했습니다.NEA의 파트너 티파니 럭(Tiffany L

2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
8 도구
xix.ai

2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai

2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔












