


 首頁
研究:OpenAI模型記憶的受版權保護內容
近期一項研究表明,OpenAI確實可能使用了受版權保護的材料來訓練其部分AI模型,為該公司面臨的持續法律爭議增添了燃料。作者、程式設計師和其他內容創作者指控OpenAI未經許可使用他們的作品(如書籍和程式碼)來開發其AI模型。雖然OpenAI以合理使用為由進行辯護,但原告認為美國版權法並未為訓練數據提供例外。
這項研究由華盛頓大學、哥本哈根大學和史丹佛大學的研究人員合作進行,介紹了一種新技術,用於檢測通過API存取的模型(如OpenAI的模型)中「記憶」的訓練數據。AI模型基本上從大量數據中學習以識別模式,使其能夠創作文稿、圖像等。雖然大多數輸出並非訓練數據的直接複製品,但由於學習過程,某些輸出難免是複製品。例如,圖像模型已知會重現電影截圖,而語言模型則被發現幾乎是在抄襲新聞文章。
研究中描述的方法聚焦於「高驚訝度」詞彙——在特定情境中不常見的詞。例如,在句子「Jack和我靜坐不動,雷達嗡嗡作響」中,「雷達」是一個高驚訝度詞,因為相較於「引擎」或「收音機」等詞,它較不常與「嗡嗡作響」連繫。
研究人員測試了多個OpenAI模型,包括GPT-4和GPT-3.5,方法是從小說書籍和新紐約時報文章的摘錄中移除高驚訝度詞彙,並要求模型預測這些缺失的詞。如果模型能準確猜出這些詞,則表明它們在訓練過程中記憶了這些文本。
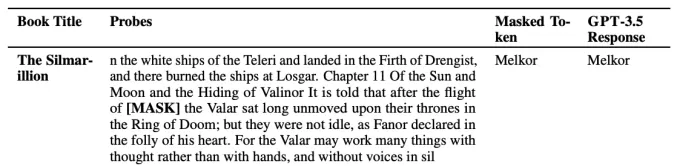
一個讓模型「猜測」高驚訝度詞的例子。圖片來源:OpenAI 結果顯示,GPT-4很可能記憶了受版權保護的電子書數據集BookMIA中的部分熱門小說書籍內容。它似乎也記憶了一些紐約時報的文章,儘管頻率較低。華盛頓大學博士生兼研究合著者Abhilasha Ravichander向TechCrunch強調,這些發現凸顯了可能用於訓練這些模型的「具爭議性數據」。「為了擁有值得信賴的大型語言模型,我們需要能夠探查、審計和科學檢驗的模型,」Ravichander表示。「我們的工作旨在提供一個探查大型語言模型的工具,但整個生態系統對數據透明度的需求確實很大。」
OpenAI一直推動放寬使用受版權保護數據來開發AI模型的規則。雖然該公司已與一些內容持有者簽訂了授權協議,並為版權持有人提供退出選項,但它也向各國政府遊說,試圖為AI訓練建立「合理使用」規則。
相關文章
 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
NEA的蒂芙尼·拉克:企業仍在努力應對人工智慧的投資回報率
正在載入播放器…今年早些時候,“token最大化”(tokenmaxxing)在矽谷佔據主導地位,執行長們敦促員工最大限度地利用人工智慧。然而,這種熱情很快遭遇了現實。據報道,Uber在幾個月內就超出了其年度人工智慧預算,一些公司跨部門削減了Claude許可證,而Meta則取消了內部績效排名。NEA合夥人蒂芙尼·拉克(Tiffany Luck)每天都在應對這種興奮與實際回報之間的差距。她此前曾成功說服企業電子商務是未來,如今她完全專注於人工智慧,特別是其為消費者創造“神奇時刻”的潛力。
相關專題推薦
聊天機器人
 用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
 10 個工具
 xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

 評論 (34)
0/500
![DouglasScott]()
So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
![JackAllen]()
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
![WilliamGonzalez]()
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
![GregoryBaker]()
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
![JohnGarcia]()
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
![TimothyMitchell]()
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔
近期一項研究表明,OpenAI確實可能使用了受版權保護的材料來訓練其部分AI模型,為該公司面臨的持續法律爭議增添了燃料。作者、程式設計師和其他內容創作者指控OpenAI未經許可使用他們的作品(如書籍和程式碼)來開發其AI模型。雖然OpenAI以合理使用為由進行辯護,但原告認為美國版權法並未為訓練數據提供例外。
這項研究由華盛頓大學、哥本哈根大學和史丹佛大學的研究人員合作進行,介紹了一種新技術,用於檢測通過API存取的模型(如OpenAI的模型)中「記憶」的訓練數據。AI模型基本上從大量數據中學習以識別模式,使其能夠創作文稿、圖像等。雖然大多數輸出並非訓練數據的直接複製品,但由於學習過程,某些輸出難免是複製品。例如,圖像模型已知會重現電影截圖,而語言模型則被發現幾乎是在抄襲新聞文章。
研究中描述的方法聚焦於「高驚訝度」詞彙——在特定情境中不常見的詞。例如,在句子「Jack和我靜坐不動,雷達嗡嗡作響」中,「雷達」是一個高驚訝度詞,因為相較於「引擎」或「收音機」等詞,它較不常與「嗡嗡作響」連繫。
研究人員測試了多個OpenAI模型,包括GPT-4和GPT-3.5,方法是從小說書籍和新紐約時報文章的摘錄中移除高驚訝度詞彙,並要求模型預測這些缺失的詞。如果模型能準確猜出這些詞,則表明它們在訓練過程中記憶了這些文本。
華盛頓大學博士生兼研究合著者Abhilasha Ravichander向TechCrunch強調,這些發現凸顯了可能用於訓練這些模型的「具爭議性數據」。「為了擁有值得信賴的大型語言模型,我們需要能夠探查、審計和科學檢驗的模型,」Ravichander表示。「我們的工作旨在提供一個探查大型語言模型的工具,但整個生態系統對數據透明度的需求確實很大。」
OpenAI一直推動放寬使用受版權保護數據來開發AI模型的規則。雖然該公司已與一些內容持有者簽訂了授權協議,並為版權持有人提供退出選項,但它也向各國政府遊說,試圖為AI訓練建立「合理使用」規則。








 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
 Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
 NEA的蒂芙尼·拉克:企業仍在努力應對人工智慧的投資回報率
正在載入播放器…今年早些時候,“token最大化”(tokenmaxxing)在矽谷佔據主導地位,執行長們敦促員工最大限度地利用人工智慧。然而,這種熱情很快遭遇了現實。據報道,Uber在幾個月內就超出了其年度人工智慧預算,一些公司跨部門削減了Claude許可證,而Meta則取消了內部績效排名。NEA合夥人蒂芙尼·拉克(Tiffany Luck)每天都在應對這種興奮與實際回報之間的差距。她此前曾成功說服企業電子商務是未來,如今她完全專注於人工智慧,特別是其為消費者創造“神奇時刻”的潛力。

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔












