


 家
調査:Openaiモデルは著作権で保護されたコンテンツを記憶しました
最近の研究によると、OpenAIがそのAIモデルの一部を訓練するために著作権のある素材を使用した可能性があることが示唆されており、 同社が直面している進行中の法廷闘争にさらなる火種を投じています。作家、プログラマー、その他のコンテンツクリエイターは、OpenAIがそのAIモデルを開発するために、 本やコードなどの彼らの作品を許可なく使用したと非難しています。OpenAIはフェアユースを主張して自らを弁護していますが、 原告側は米国著作権法には訓練データに対する例外規定がないと主張しています。
この研究は、ワシントン大学、コペンハーゲン大学、スタンフォード大学の研究者による共同研究であり、 OpenAIのようなAPIを通じてアクセスされるモデルで「記憶された」訓練データを検出する新しい技術を導入しています。 AIモデルは、膨大なデータからパターンを認識することを学び、エッセイや画像などを生成できるようになります。 ほとんどの出力は訓練データの直接のコピーではありませんが、学習プロセスのため、一部は必然的にそうなることがあります。 例えば、画像モデルは映画のスクリーンショットを再現することが知られており、言語モデルはニュース記事をほぼ剽窃していると指摘されています。
研究で説明されている手法は、「高サプライザル」な単語、つまり特定の文脈で異常な単語に焦点を当てています。 例えば、「ジャックと私はレーダーがブーンと鳴る中、完全に静かに座っていた」という文で、「レーダー」は「エンジン」や「ラジオ」などの単語が「ブーンと鳴る」に先行することが期待されるよりも予測しにくいため、高サプライザルな単語となります。
研究者たちは、GPT-4やGPT-3.5を含むいくつかのOpenAIモデルをテストしました。フィクションの本やニューヨーク・タイムズの記事から高サプライザルな単語を削除し、モデルにその欠落した単語を予測させました。モデルが正確に単語を推測した場合、それは訓練中にそのテキストを記憶していたことを示唆しています。
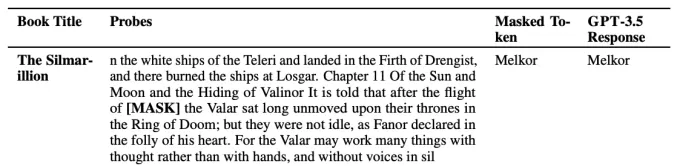
モデルが「高サプライザル」な単語を「推測」する例。画像クレジット:OpenAI 研究の結果、GPT-4がBookMIAデータセットの著作権付き電子書籍を含む人気のフィクション本の一部を記憶していた可能性が高いことが示されました。また、ニューヨーク・タイムズの記事もいくつか記憶していたようですが、その頻度は低かったです。
ワシントン大学の博士課程学生であり、研究の共著者であるアビラシャ・ラビチャンダー氏は、TechCrunchに対し、これらの発見がこれらのモデルを訓練するために使用された可能性のある「問題のあるデータ」を強調していると述べました。「信頼できる大規模言語モデルを持つためには、科学的かつ監査可能で調査可能なモデルが必要です」とラビチャンダー氏は述べました。「私たちの研究は大規模言語モデルを調査するツールを提供することを目指していますが、エコシステム全体でデータの透明性を高める必要が本当にあるのです。」
OpenAIは、AIモデルの開発に著作権のあるデータを使用するルールを緩和することを推進しています。同社は一部のコンテンツライセンス契約を持ち、著作権者にオプトアウトのオプションを提供していますが、AI訓練に特化した「フェアユース」のルールを確立するよう、さまざまな政府に働きかけています。
関連記事
 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面
Nvidia、来年の売上高の25%を資金提供を受けた研究所から得る見込み
Nvidiaは、同社のチップを購入するAI研究所に500億米ドル近くを投入し、総額5,000億米ドルを超える契約を確保した。8月26日、CFOのコレット・クレス氏はアナリストに対し、Nvidiaの財務基盤に支えられたこれらの研究所が、来年の同社事業の約4分の1を占める見込みであると伝えた。この仕組みは、しばしば「循環型資金調達」と呼ばれるが、アナリストがこの用語を考案する以前からNvidiaはこれ
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (34)
0/500
![DouglasScott]()
So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
![JackAllen]()
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
![WilliamGonzalez]()
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
![GregoryBaker]()
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
![JohnGarcia]()
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
![TimothyMitchell]()
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔
最近の研究によると、OpenAIがそのAIモデルの一部を訓練するために著作権のある素材を使用した可能性があることが示唆されており、 同社が直面している進行中の法廷闘争にさらなる火種を投じています。作家、プログラマー、その他のコンテンツクリエイターは、OpenAIがそのAIモデルを開発するために、 本やコードなどの彼らの作品を許可なく使用したと非難しています。OpenAIはフェアユースを主張して自らを弁護していますが、 原告側は米国著作権法には訓練データに対する例外規定がないと主張しています。
この研究は、ワシントン大学、コペンハーゲン大学、スタンフォード大学の研究者による共同研究であり、 OpenAIのようなAPIを通じてアクセスされるモデルで「記憶された」訓練データを検出する新しい技術を導入しています。 AIモデルは、膨大なデータからパターンを認識することを学び、エッセイや画像などを生成できるようになります。 ほとんどの出力は訓練データの直接のコピーではありませんが、学習プロセスのため、一部は必然的にそうなることがあります。 例えば、画像モデルは映画のスクリーンショットを再現することが知られており、言語モデルはニュース記事をほぼ剽窃していると指摘されています。
研究で説明されている手法は、「高サプライザル」な単語、つまり特定の文脈で異常な単語に焦点を当てています。 例えば、「ジャックと私はレーダーがブーンと鳴る中、完全に静かに座っていた」という文で、「レーダー」は「エンジン」や「ラジオ」などの単語が「ブーンと鳴る」に先行することが期待されるよりも予測しにくいため、高サプライザルな単語となります。
研究者たちは、GPT-4やGPT-3.5を含むいくつかのOpenAIモデルをテストしました。フィクションの本やニューヨーク・タイムズの記事から高サプライザルな単語を削除し、モデルにその欠落した単語を予測させました。モデルが正確に単語を推測した場合、それは訓練中にそのテキストを記憶していたことを示唆しています。
ワシントン大学の博士課程学生であり、研究の共著者であるアビラシャ・ラビチャンダー氏は、TechCrunchに対し、これらの発見がこれらのモデルを訓練するために使用された可能性のある「問題のあるデータ」を強調していると述べました。「信頼できる大規模言語モデルを持つためには、科学的かつ監査可能で調査可能なモデルが必要です」とラビチャンダー氏は述べました。「私たちの研究は大規模言語モデルを調査するツールを提供することを目指していますが、エコシステム全体でデータの透明性を高める必要が本当にあるのです。」
OpenAIは、AIモデルの開発に著作権のあるデータを使用するルールを緩和することを推進しています。同社は一部のコンテンツライセンス契約を持ち、著作権者にオプトアウトのオプションを提供していますが、AI訓練に特化した「フェアユース」のルールを確立するよう、さまざまな政府に働きかけています。








 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
 OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面
 Nvidia、来年の売上高の25%を資金提供を受けた研究所から得る見込み
Nvidiaは、同社のチップを購入するAI研究所に500億米ドル近くを投入し、総額5,000億米ドルを超える契約を確保した。8月26日、CFOのコレット・クレス氏はアナリストに対し、Nvidiaの財務基盤に支えられたこれらの研究所が、来年の同社事業の約4分の1を占める見込みであると伝えた。この仕組みは、しばしば「循環型資金調達」と呼ばれるが、アナリストがこの用語を考案する以前からNvidiaはこれ

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔












