


 Hogar
Estudio: los modelos de OpenAI memorizaron contenido con derechos de autor
Un estudio reciente sugiere que OpenAI podría haber utilizado material protegido por derechos de autor para entrenar algunos de sus modelos de IA, añadiendo más leña al fuego de las batallas legales que enfrenta la compañía. Autores, programadores y otros creadores de contenido han acusado a OpenAI de usar sus obras —como libros y código— sin permiso para desarrollar sus modelos de IA. Aunque OpenAI se ha defendido alegando el uso justo, los demandantes argumentan que la ley de derechos de autor de EE. UU. no proporciona una excepción para los datos de entrenamiento.
El estudio, una colaboración entre investigadores de la Universidad de Washington, la Universidad de Copenhague y Stanford, presenta una nueva técnica para detectar datos de entrenamiento "memorizados" en modelos a los que se accede a través de una API, como los de OpenAI. Los modelos de IA esencialmente aprenden de grandes cantidades de datos para reconocer patrones, lo que les permite crear ensayos, imágenes y más. Aunque la mayoría de los resultados no son copias directas de los datos de entrenamiento, algunos lo son inevitablemente debido al proceso de aprendizaje. Por ejemplo, se sabe que los modelos de imágenes han reproducido capturas de pantalla de películas, mientras que los modelos de lenguaje han sido sorprendidos prácticamente plagiando artículos de noticias.
El método descrito en el estudio se centra en palabras de "alta sorpresa" —palabras que son inusuales en un contexto dado. Por ejemplo, en la frase "Jack y yo nos sentamos perfectamente quietos con el radar zumbando," "radar" sería una palabra de alta sorpresa porque es menos esperada que palabras como "motor" o "radio" para preceder a "zumbando."
Los investigadores probaron varios modelos de OpenAI, incluyendo GPT-4 y GPT-3.5, eliminando palabras de alta sorpresa de extractos de libros de ficción y artículos del New York Times y pidiendo a los modelos que predijeran estas palabras faltantes. Si los modelos adivinaban correctamente las palabras, esto sugería que habían memorizado el texto durante el entrenamiento.
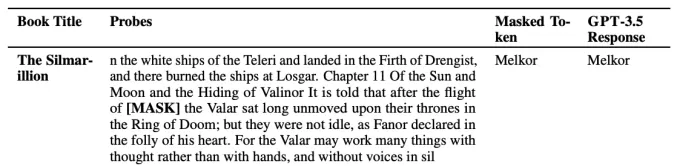
Un ejemplo de hacer que un modelo "adivine" una palabra de alta sorpresa. Créditos de la imagen: OpenAI Los resultados indicaron que GPT-4 probablemente había memorizado partes de libros de ficción populares, incluyendo aquellos en el conjunto de datos BookMIA de libros electrónicos protegidos por derechos de autor. También parecía haber memorizado algunos artículos del New York Times, aunque con una frecuencia menor.Abhilasha Ravichander, estudiante de doctorado en la Universidad de Washington y coautora del estudio, enfatizó a TechCrunch que estos hallazgos destacan los "datos controvertidos" que podrían haber sido utilizados para entrenar estos modelos. "Para tener modelos de lenguaje grandes que sean confiables, necesitamos modelos que podamos sondear, auditar y examinar científicamente," afirmó Ravichander. "Nuestro trabajo busca proporcionar una herramienta para sondear modelos de lenguaje grandes, pero hay una necesidad real de mayor transparencia de datos en todo el ecosistema."
OpenAI ha presionado por reglas más relajadas sobre el uso de datos protegidos por derechos de autor para desarrollar modelos de IA. Aunque la compañía tiene algunos acuerdos de licencia de contenido y ofrece opciones de exclusión para los titulares de derechos de autor, ha presionado a varios gobiernos para establecer reglas de "uso justo" específicamente para el entrenamiento de IA.
Artículo relacionado
 OpenAI lanza una versión más segura de ChatGPT para adolescentes, años después de que estos empezaran a utilizarla
Tras una serie de demandas relacionadas con la ausencia de protocolos de seguridad en los chatbots de IA —que contribuyeron a suicidios de adolescentes y otras crisis de salud mental—, OpenAI presentó
Frontier AI Labs se niega a revelar las estrategias de contención para los modelos rebeldes
Investigaciones recientes indican que muy pocos laboratorios líderes en IA han publicado o demostrado planes de respuesta de contención. Un plan de contención define los procedimientos a seguir cuando
El Tiffany de NEA: Las empresas aún luchan con el ROI de la IA
Cargando el reproductor…A principios de este año, el «tokenmaxxing» dominó Silicon Valley, con directores generales instando al personal a maximizar el uso de la inteligencia artificial. Ese entusiasmo se topó rápidamente con la realidad. Según info
Recomendaciones de temas especiales relacionados
composicion musical
 Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
 8 herramientas
 xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai
Creación de cómics
Las mejores herramientas de burbujas de diálogo con IA para la narración visual
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai
Asistente de reuniones
Las mejores herramientas de resumen de reuniones con IA: realiza un seguimiento claro de las decisiones y las acciones de seguimiento
Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai
Análisis de datos
Mejores herramientas de limpieza de datos con IA: corrige valores faltantes y duplicados rápidamente
2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai

 comentario (34)
0/500
![DouglasScott]()
So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
![JackAllen]()
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
![WilliamGonzalez]()
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
![GregoryBaker]()
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
![JohnGarcia]()
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
![TimothyMitchell]()
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔
Un estudio reciente sugiere que OpenAI podría haber utilizado material protegido por derechos de autor para entrenar algunos de sus modelos de IA, añadiendo más leña al fuego de las batallas legales que enfrenta la compañía. Autores, programadores y otros creadores de contenido han acusado a OpenAI de usar sus obras —como libros y código— sin permiso para desarrollar sus modelos de IA. Aunque OpenAI se ha defendido alegando el uso justo, los demandantes argumentan que la ley de derechos de autor de EE. UU. no proporciona una excepción para los datos de entrenamiento.
El estudio, una colaboración entre investigadores de la Universidad de Washington, la Universidad de Copenhague y Stanford, presenta una nueva técnica para detectar datos de entrenamiento "memorizados" en modelos a los que se accede a través de una API, como los de OpenAI. Los modelos de IA esencialmente aprenden de grandes cantidades de datos para reconocer patrones, lo que les permite crear ensayos, imágenes y más. Aunque la mayoría de los resultados no son copias directas de los datos de entrenamiento, algunos lo son inevitablemente debido al proceso de aprendizaje. Por ejemplo, se sabe que los modelos de imágenes han reproducido capturas de pantalla de películas, mientras que los modelos de lenguaje han sido sorprendidos prácticamente plagiando artículos de noticias.
El método descrito en el estudio se centra en palabras de "alta sorpresa" —palabras que son inusuales en un contexto dado. Por ejemplo, en la frase "Jack y yo nos sentamos perfectamente quietos con el radar zumbando," "radar" sería una palabra de alta sorpresa porque es menos esperada que palabras como "motor" o "radio" para preceder a "zumbando."
Los investigadores probaron varios modelos de OpenAI, incluyendo GPT-4 y GPT-3.5, eliminando palabras de alta sorpresa de extractos de libros de ficción y artículos del New York Times y pidiendo a los modelos que predijeran estas palabras faltantes. Si los modelos adivinaban correctamente las palabras, esto sugería que habían memorizado el texto durante el entrenamiento.
Abhilasha Ravichander, estudiante de doctorado en la Universidad de Washington y coautora del estudio, enfatizó a TechCrunch que estos hallazgos destacan los "datos controvertidos" que podrían haber sido utilizados para entrenar estos modelos. "Para tener modelos de lenguaje grandes que sean confiables, necesitamos modelos que podamos sondear, auditar y examinar científicamente," afirmó Ravichander. "Nuestro trabajo busca proporcionar una herramienta para sondear modelos de lenguaje grandes, pero hay una necesidad real de mayor transparencia de datos en todo el ecosistema."
OpenAI ha presionado por reglas más relajadas sobre el uso de datos protegidos por derechos de autor para desarrollar modelos de IA. Aunque la compañía tiene algunos acuerdos de licencia de contenido y ofrece opciones de exclusión para los titulares de derechos de autor, ha presionado a varios gobiernos para establecer reglas de "uso justo" específicamente para el entrenamiento de IA.








 OpenAI lanza una versión más segura de ChatGPT para adolescentes, años después de que estos empezaran a utilizarla
Tras una serie de demandas relacionadas con la ausencia de protocolos de seguridad en los chatbots de IA —que contribuyeron a suicidios de adolescentes y otras crisis de salud mental—, OpenAI presentó
 Frontier AI Labs se niega a revelar las estrategias de contención para los modelos rebeldes
Investigaciones recientes indican que muy pocos laboratorios líderes en IA han publicado o demostrado planes de respuesta de contención. Un plan de contención define los procedimientos a seguir cuando
 El Tiffany de NEA: Las empresas aún luchan con el ROI de la IA
Cargando el reproductor…A principios de este año, el «tokenmaxxing» dominó Silicon Valley, con directores generales instando al personal a maximizar el uso de la inteligencia artificial. Ese entusiasmo se topó rápidamente con la realidad. Según info

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai

Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai

2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai

So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔












