


 Heim
Studie: OpenAI -Modelle merkten aus dem urheberrechtlich geschützten Inhalt aus
Eine kürzliche Studie legt nahe, dass OpenAI tatsächlich urheberrechtlich geschütztes Material verwendet haben könnte, um einige seiner KI-Modelle zu trainieren, was die laufenden rechtlichen Auseinandersetzungen des Unternehmens weiter anheizt. Autoren, Programmierer und andere Inhaltsersteller haben OpenAI beschuldigt, ihre Werke – wie Bücher und Code – ohne Erlaubnis verwendet zu haben, um seine KI-Modelle zu entwickeln. Während OpenAI sich mit dem Argument der fairen Nutzung verteidigt, argumentieren die Kläger, dass das US-Urheberrecht keine Ausnahme für Trainingsdaten vorsieht.
Die Studie, eine Zusammenarbeit von Forschern der University of Washington, der University of Copenhagen und Stanford, stellt eine neue Technik vor, um „gespeicherte“ Trainingsdaten in Modellen zu erkennen, die über eine API zugänglich sind, wie jene von OpenAI. KI-Modelle lernen im Wesentlichen aus riesigen Datenmengen, um Muster zu erkennen, was ihnen ermöglicht, Essays, Bilder und mehr zu erstellen. Obwohl die meisten Ausgaben keine direkten Kopien der Trainingsdaten sind, sind einige aufgrund des Lernprozesses unvermeidlich. Zum Beispiel ist bekannt, dass Bildmodelle Filmscreenshots reproduzieren, während Sprachmodelle Nachrichtenartikel im Wesentlichen plagiiert haben.
Die in der Studie beschriebene Methode konzentriert sich auf „hoch überraschende“ Wörter – Wörter, die in einem bestimmten Kontext ungewöhnlich sind. Zum Beispiel wäre in dem Satz „Jack und ich saßen völlig still, während das Radar summte“ das Wort „Radar“ ein hoch überraschendes Wort, da es weniger erwartet wird als Wörter wie „Motor“ oder „Radio“ vor „summte“.
Die Forscher testeten mehrere OpenAI-Modelle, einschließlich GPT-4 und GPT-3.5, indem sie hoch überraschende Wörter aus Auszügen von Fiktionsbüchern und Artikeln der New York Times entfernten und die Modelle aufforderten, diese fehlenden Wörter vorherzusagen. Wenn die Modelle die Wörter korrekt erraten, deutete dies darauf hin, dass sie den Text während des Trainings gespeichert hatten.
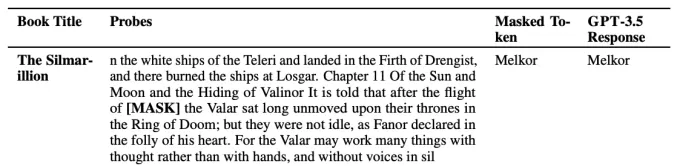
Ein Beispiel dafür, wie ein Modell ein hoch überraschendes Wort „errät“. Bildnachweis: OpenAI Die Ergebnisse zeigten, dass GPT-4 wahrscheinlich Teile populärer Fiktionsbücher gespeichert hatte, einschließlich solcher im BookMIA-Datensatz urheberrechtlich geschützter E-Books. Es schien auch einige Artikel der New York Times gespeichert zu haben, allerdings in geringerem Umfang.Abhilasha Ravichander, eine Doktorandin an der University of Washington und Mitautorin der Studie, betonte gegenüber TechCrunch, dass diese Ergebnisse die „umstrittenen Daten“ hervorheben, die möglicherweise zum Trainieren dieser Modelle verwendet wurden. „Um große Sprachmodelle zu haben, die vertrauenswürdig sind, brauchen wir Modelle, die wir untersuchen, prüfen und wissenschaftlich analysieren können“, erklärte Ravichander. „Unsere Arbeit zielt darauf ab, ein Werkzeug bereitzustellen, um große Sprachmodelle zu untersuchen, aber es gibt ein echtes Bedürfnis nach größerer Datentransparenz im gesamten Ökosystem.“
OpenAI hat sich für lockerere Regeln zur Verwendung urheberrechtlich geschützter Daten zur Entwicklung von KI-Modellen eingesetzt. Obwohl das Unternehmen einige Lizenzvereinbarungen für Inhalte hat und Opt-out-Optionen für Urheberrechtsinhaber anbietet, hat es verschiedene Regierungen dazu gedrängt, spezifische „Fair Use“-Regeln für das KI-Training einzuführen.
Verwandter Artikel
 OpenAI bringt eine sicherere Version von ChatGPT für Jugendliche auf den Markt, Jahre nachdem diese begonnen hatten, die Plattform zu nutzen
Nach einer Reihe von Gerichtsverfahren wegen fehlender Sicherheitsvorkehrungen bei KI-Chatbots – die zu Selbstmorden unter Jugendlichen und anderen psychischen Krisen beigetragen hatten – stellte Open
Frontier AI Labs weigert sich, Eindämmungsstrategien für außer Kontrolle geratene Modelle offenzulegen
Jüngste Untersuchungen zeigen, dass nur sehr wenige führende KI-Forschungslabore Maßnahmenpläne zur Eindämmung veröffentlicht oder vorgeführt haben. Ein solcher Eindämmungsplan legt die Vorgehensweise
NEAs Tiffany Luck: Unternehmen kämpfen weiterhin mit der ROI von KI
Laden des Players…Anfang dieses Jahres dominierte „Tokenmaxxing“ das Silicon Valley, wobei CEOs ihre Mitarbeiter aufforderten, die Nutzung von KI zu maximieren. Diese Begeisterung stieß jedoch schnell auf die Realität. Berichten zufolge hat Uber sei
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

 Kommentare (34)
![DouglasScott]()
So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
![JackAllen]()
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
![WilliamGonzalez]()
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
![GregoryBaker]()
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
![JohnGarcia]()
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
![TimothyMitchell]()
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔
Eine kürzliche Studie legt nahe, dass OpenAI tatsächlich urheberrechtlich geschütztes Material verwendet haben könnte, um einige seiner KI-Modelle zu trainieren, was die laufenden rechtlichen Auseinandersetzungen des Unternehmens weiter anheizt. Autoren, Programmierer und andere Inhaltsersteller haben OpenAI beschuldigt, ihre Werke – wie Bücher und Code – ohne Erlaubnis verwendet zu haben, um seine KI-Modelle zu entwickeln. Während OpenAI sich mit dem Argument der fairen Nutzung verteidigt, argumentieren die Kläger, dass das US-Urheberrecht keine Ausnahme für Trainingsdaten vorsieht.
Die Studie, eine Zusammenarbeit von Forschern der University of Washington, der University of Copenhagen und Stanford, stellt eine neue Technik vor, um „gespeicherte“ Trainingsdaten in Modellen zu erkennen, die über eine API zugänglich sind, wie jene von OpenAI. KI-Modelle lernen im Wesentlichen aus riesigen Datenmengen, um Muster zu erkennen, was ihnen ermöglicht, Essays, Bilder und mehr zu erstellen. Obwohl die meisten Ausgaben keine direkten Kopien der Trainingsdaten sind, sind einige aufgrund des Lernprozesses unvermeidlich. Zum Beispiel ist bekannt, dass Bildmodelle Filmscreenshots reproduzieren, während Sprachmodelle Nachrichtenartikel im Wesentlichen plagiiert haben.
Die in der Studie beschriebene Methode konzentriert sich auf „hoch überraschende“ Wörter – Wörter, die in einem bestimmten Kontext ungewöhnlich sind. Zum Beispiel wäre in dem Satz „Jack und ich saßen völlig still, während das Radar summte“ das Wort „Radar“ ein hoch überraschendes Wort, da es weniger erwartet wird als Wörter wie „Motor“ oder „Radio“ vor „summte“.
Die Forscher testeten mehrere OpenAI-Modelle, einschließlich GPT-4 und GPT-3.5, indem sie hoch überraschende Wörter aus Auszügen von Fiktionsbüchern und Artikeln der New York Times entfernten und die Modelle aufforderten, diese fehlenden Wörter vorherzusagen. Wenn die Modelle die Wörter korrekt erraten, deutete dies darauf hin, dass sie den Text während des Trainings gespeichert hatten.
Abhilasha Ravichander, eine Doktorandin an der University of Washington und Mitautorin der Studie, betonte gegenüber TechCrunch, dass diese Ergebnisse die „umstrittenen Daten“ hervorheben, die möglicherweise zum Trainieren dieser Modelle verwendet wurden. „Um große Sprachmodelle zu haben, die vertrauenswürdig sind, brauchen wir Modelle, die wir untersuchen, prüfen und wissenschaftlich analysieren können“, erklärte Ravichander. „Unsere Arbeit zielt darauf ab, ein Werkzeug bereitzustellen, um große Sprachmodelle zu untersuchen, aber es gibt ein echtes Bedürfnis nach größerer Datentransparenz im gesamten Ökosystem.“
OpenAI hat sich für lockerere Regeln zur Verwendung urheberrechtlich geschützter Daten zur Entwicklung von KI-Modellen eingesetzt. Obwohl das Unternehmen einige Lizenzvereinbarungen für Inhalte hat und Opt-out-Optionen für Urheberrechtsinhaber anbietet, hat es verschiedene Regierungen dazu gedrängt, spezifische „Fair Use“-Regeln für das KI-Training einzuführen.








 OpenAI bringt eine sicherere Version von ChatGPT für Jugendliche auf den Markt, Jahre nachdem diese begonnen hatten, die Plattform zu nutzen
Nach einer Reihe von Gerichtsverfahren wegen fehlender Sicherheitsvorkehrungen bei KI-Chatbots – die zu Selbstmorden unter Jugendlichen und anderen psychischen Krisen beigetragen hatten – stellte Open
 Frontier AI Labs weigert sich, Eindämmungsstrategien für außer Kontrolle geratene Modelle offenzulegen
Jüngste Untersuchungen zeigen, dass nur sehr wenige führende KI-Forschungslabore Maßnahmenpläne zur Eindämmung veröffentlicht oder vorgeführt haben. Ein solcher Eindämmungsplan legt die Vorgehensweise
 NEAs Tiffany Luck: Unternehmen kämpfen weiterhin mit der ROI von KI
Laden des Players…Anfang dieses Jahres dominierte „Tokenmaxxing“ das Silicon Valley, wobei CEOs ihre Mitarbeiter aufforderten, die Nutzung von KI zu maximieren. Diese Begeisterung stieß jedoch schnell auf die Realität. Berichten zufolge hat Uber sei

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔












