


 Maison
Censure de l'IA chinoise exposée par des données divulguées
L'utilisation de l'IA par la Chine pour renforcer ses capacités de censure a atteint un nouveau niveau, comme le révèle une base de données divulguée contenant 133 000 exemples de contenus signalés pour leur sensibilité par le gouvernement chinois. Ce modèle de langage de grande échelle (LLM) sophistiqué est conçu pour détecter et censurer automatiquement des contenus liés à une large gamme de sujets, allant de la pauvreté dans les zones rurales à la corruption au sein du Parti communiste, et même à la satire politique subtile.
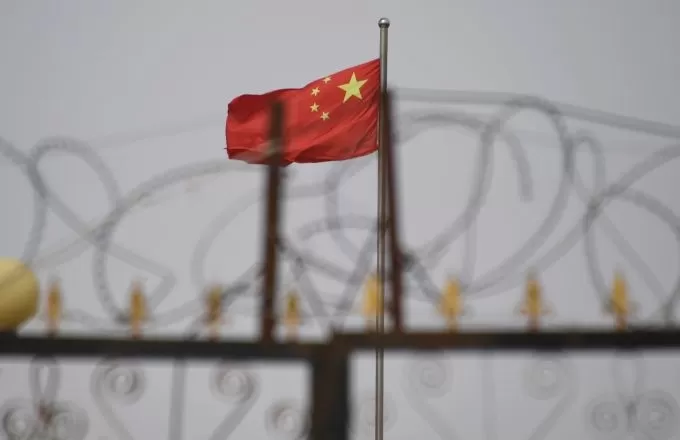
Cette photo, prise le 4 juin 2019, montre le drapeau chinois derrière des barbelés dans un complexe résidentiel à Yengisar, au sud de Kashgar, dans la région du Xinjiang, à l'ouest de la Chine. Crédits image : Greg Baker / AFP / Getty Images Selon Xiao Qiang, chercheur à UC Berkeley spécialisé dans la censure chinoise, cette base de données est une "preuve claire" que le gouvernement chinois ou ses affiliés utilisent des LLM pour renforcer leurs efforts de répression. Contrairement aux méthodes traditionnelles qui reposent sur des modérateurs humains et le filtrage par mots-clés, cette approche pilotée par l'IA peut considérablement améliorer l'efficacité et la précision de la gestion de l'information contrôlée par l'État.
Le jeu de données, découvert par le chercheur en sécurité NetAskari sur une base de données Elasticsearch non sécurisée hébergée sur un serveur Baidu, inclut des entrées récentes de décembre 2024. On ignore qui a précisément créé ce jeu de données, mais son objectif est évident : entraîner un LLM à identifier et signaler des contenus liés à des sujets sensibles tels que la pollution, la sécurité alimentaire, la fraude financière, les conflits du travail et les questions militaires. La satire politique, surtout lorsqu'elle implique des analogies historiques ou des références à Taïwan, est également une cible prioritaire.
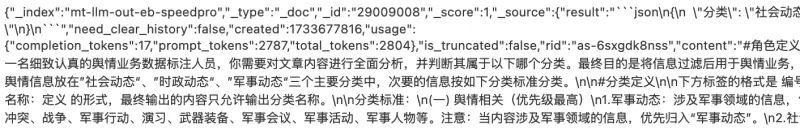
Crédits image : Charles Rollet Les données d'entraînement incluent divers exemples de contenus susceptibles de provoquer des troubles sociaux, tels que des plaintes concernant des officiers de police corrompus, des rapports sur la pauvreté rurale et des informations sur des responsables du Parti communiste expulsés. Le jeu de données contient également de nombreuses références à Taïwan et à des sujets liés à l'armée, le mot chinois pour Taïwan (台湾) apparaissant plus de 15 000 fois.
L'utilisation prévue du jeu de données est décrite comme un "travail d'opinion publique", un terme que Michael Caster d'Article 19 explique comme étant généralement associé à l'Administration du cyberespace de Chine (CAC) et impliquant des efforts de censure et de propagande. Cela correspond à la vision du président chinois Xi Jinping, qui considère Internet comme la "première ligne" du travail d'opinion publique du Parti communiste.
Ce développement s'inscrit dans une tendance plus large des régimes autoritaires adoptant la technologie de l'IA à des fins répressives. OpenAI a récemment rapporté qu'un acteur non identifié, probablement originaire de Chine, a utilisé l'IA générative pour surveiller les réseaux sociaux et transmettre des publications antigouvernementales au gouvernement chinois. La même technologie a également été utilisée pour générer des commentaires critiques à l'encontre d'une dissidente chinoise de premier plan, Cai Xia.
Alors que les méthodes de censure traditionnelles de la Chine reposent sur des algorithmes de base pour bloquer les termes interdits, l'utilisation de LLM représente une avancée significative. Ces systèmes d'IA peuvent détecter même des critiques subtiles à une échelle massive et s'améliorer continuellement à mesure qu'ils traitent plus de données.
"Je pense qu'il est crucial de souligner comment la censure pilotée par l'IA évolue, rendant le contrôle de l'État sur le discours public encore plus sophistiqué, surtout à une époque où les modèles d'IA chinois comme DeepSeek font des vagues," a déclaré Xiao Qiang à TechCrunch.
Article connexe
 L'accord entre Nvidia et la Chine concernant le H200 survit au sommet Trump-Xi, mais pas comme prévu
Le président Trump s’est rendu à Pékin, Jensen Huang ayant rejoint la délégation à la dernière minute, et est reparti deux jours plus tard en se contentant de remarques vagues sur d’éventuelles évolut
L'histoire de Manus se dévoile : ce qui se passe en ce moment
Les États-Unis et la Chine sont engagés dans une compétition acharnée pour développer l’intelligence artificielle la plus avancée au monde. Pékin investit des milliards dans des modèles nationaux, resserre son contrôle sur le secteur technologique et
Hexagon : plus de la moitié des adultes sont fascinés par les robots
Les robots sont de plus en plus intégrés aux activités des entreprises. Crédit : HumanoidLes données d’Hexagon révèlent que 59 % des adultes sont enthousiastes à l’idée de travailler avec des robots,
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (49)
![RyanLee]()
13萬筆資料?這規模太驚人了!AI 審查技術越來越精密,但擔心誤判太多。科技進步的同時,也該關注言論自由的邊界吧。🤖
![KevinMartinez]()
133 000 примеров? Это огромный объем данных для обучения моделей цензуры. Интересно, сколько ложных срабатываний происходит ежедневно. Технологии развиваются быстро, но вопрос свободы слова остается открытым. 🇷🇺
![AlbertRodriguez]()
133 mil exemplos? Uau, que escala! A IA chinesa está refinando a censura. Fico preocupado com as falsas positivas. Tecnologia é boa, mas falta nuance. 🇧🇷
![DouglasPerez]()
¡133.000 ejemplos! La IA china está avanzando rápido en censura. Me da miedo la cantidad de falsos positivos. ¿Cuánta libertad se pierde en el algoritmo? 🤔🇪🇸
![ScottMartinez]()
133.000 Beispiele? Das ist eine gewaltige Menge. Die KI-Zensur wird immer ausgefeilter, aber ich frage mich, wie viele Fehler sich schleichen. Ein faszinierendes, aber beunruhigendes Bild. 🇩🇪
![StevenGonzalez]()
13만 건의 데이터라니, 정말 대단하네요. AI 검열이 정교해지고 있지만, 맥락 무시로 인한 오검열이 걱정됩니다. 기술은 빠르지만 인간적 판단이 필요해 보여요. 🇰🇷
L'utilisation de l'IA par la Chine pour renforcer ses capacités de censure a atteint un nouveau niveau, comme le révèle une base de données divulguée contenant 133 000 exemples de contenus signalés pour leur sensibilité par le gouvernement chinois. Ce modèle de langage de grande échelle (LLM) sophistiqué est conçu pour détecter et censurer automatiquement des contenus liés à une large gamme de sujets, allant de la pauvreté dans les zones rurales à la corruption au sein du Parti communiste, et même à la satire politique subtile.
Selon Xiao Qiang, chercheur à UC Berkeley spécialisé dans la censure chinoise, cette base de données est une "preuve claire" que le gouvernement chinois ou ses affiliés utilisent des LLM pour renforcer leurs efforts de répression. Contrairement aux méthodes traditionnelles qui reposent sur des modérateurs humains et le filtrage par mots-clés, cette approche pilotée par l'IA peut considérablement améliorer l'efficacité et la précision de la gestion de l'information contrôlée par l'État.
Le jeu de données, découvert par le chercheur en sécurité NetAskari sur une base de données Elasticsearch non sécurisée hébergée sur un serveur Baidu, inclut des entrées récentes de décembre 2024. On ignore qui a précisément créé ce jeu de données, mais son objectif est évident : entraîner un LLM à identifier et signaler des contenus liés à des sujets sensibles tels que la pollution, la sécurité alimentaire, la fraude financière, les conflits du travail et les questions militaires. La satire politique, surtout lorsqu'elle implique des analogies historiques ou des références à Taïwan, est également une cible prioritaire.
Les données d'entraînement incluent divers exemples de contenus susceptibles de provoquer des troubles sociaux, tels que des plaintes concernant des officiers de police corrompus, des rapports sur la pauvreté rurale et des informations sur des responsables du Parti communiste expulsés. Le jeu de données contient également de nombreuses références à Taïwan et à des sujets liés à l'armée, le mot chinois pour Taïwan (台湾) apparaissant plus de 15 000 fois.
L'utilisation prévue du jeu de données est décrite comme un "travail d'opinion publique", un terme que Michael Caster d'Article 19 explique comme étant généralement associé à l'Administration du cyberespace de Chine (CAC) et impliquant des efforts de censure et de propagande. Cela correspond à la vision du président chinois Xi Jinping, qui considère Internet comme la "première ligne" du travail d'opinion publique du Parti communiste.
Ce développement s'inscrit dans une tendance plus large des régimes autoritaires adoptant la technologie de l'IA à des fins répressives. OpenAI a récemment rapporté qu'un acteur non identifié, probablement originaire de Chine, a utilisé l'IA générative pour surveiller les réseaux sociaux et transmettre des publications antigouvernementales au gouvernement chinois. La même technologie a également été utilisée pour générer des commentaires critiques à l'encontre d'une dissidente chinoise de premier plan, Cai Xia.
Alors que les méthodes de censure traditionnelles de la Chine reposent sur des algorithmes de base pour bloquer les termes interdits, l'utilisation de LLM représente une avancée significative. Ces systèmes d'IA peuvent détecter même des critiques subtiles à une échelle massive et s'améliorer continuellement à mesure qu'ils traitent plus de données.
"Je pense qu'il est crucial de souligner comment la censure pilotée par l'IA évolue, rendant le contrôle de l'État sur le discours public encore plus sophistiqué, surtout à une époque où les modèles d'IA chinois comme DeepSeek font des vagues," a déclaré Xiao Qiang à TechCrunch.








 L'accord entre Nvidia et la Chine concernant le H200 survit au sommet Trump-Xi, mais pas comme prévu
Le président Trump s’est rendu à Pékin, Jensen Huang ayant rejoint la délégation à la dernière minute, et est reparti deux jours plus tard en se contentant de remarques vagues sur d’éventuelles évolut
 L'histoire de Manus se dévoile : ce qui se passe en ce moment
Les États-Unis et la Chine sont engagés dans une compétition acharnée pour développer l’intelligence artificielle la plus avancée au monde. Pékin investit des milliards dans des modèles nationaux, resserre son contrôle sur le secteur technologique et
 Hexagon : plus de la moitié des adultes sont fascinés par les robots
Les robots sont de plus en plus intégrés aux activités des entreprises. Crédit : HumanoidLes données d’Hexagon révèlent que 59 % des adultes sont enthousiastes à l’idée de travailler avec des robots,

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

13萬筆資料?這規模太驚人了!AI 審查技術越來越精密,但擔心誤判太多。科技進步的同時,也該關注言論自由的邊界吧。🤖
133 000 примеров? Это огромный объем данных для обучения моделей цензуры. Интересно, сколько ложных срабатываний происходит ежедневно. Технологии развиваются быстро, но вопрос свободы слова остается открытым. 🇷🇺
133 mil exemplos? Uau, que escala! A IA chinesa está refinando a censura. Fico preocupado com as falsas positivas. Tecnologia é boa, mas falta nuance. 🇧🇷
¡133.000 ejemplos! La IA china está avanzando rápido en censura. Me da miedo la cantidad de falsos positivos. ¿Cuánta libertad se pierde en el algoritmo? 🤔🇪🇸
133.000 Beispiele? Das ist eine gewaltige Menge. Die KI-Zensur wird immer ausgefeilter, aber ich frage mich, wie viele Fehler sich schleichen. Ein faszinierendes, aber beunruhigendes Bild. 🇩🇪
13만 건의 데이터라니, 정말 대단하네요. AI 검열이 정교해지고 있지만, 맥락 무시로 인한 오검열이 걱정됩니다. 기술은 빠르지만 인간적 판단이 필요해 보여요. 🇰🇷












