


 Hogar
Censura de IA china expuesta por datos filtrados
El uso de la IA por parte de China para mejorar sus capacidades de censura ha alcanzado un nuevo nivel, según revela una base de datos filtrada que contiene 133,000 ejemplos de contenido marcado por su sensibilidad por el gobierno chino. Este sofisticado modelo de lenguaje grande (LLM) está diseñado para detectar y censurar automáticamente contenido relacionado con una amplia gama de temas, desde la pobreza en áreas rurales hasta la corrupción dentro del Partido Comunista e incluso sátiras políticas sutiles.
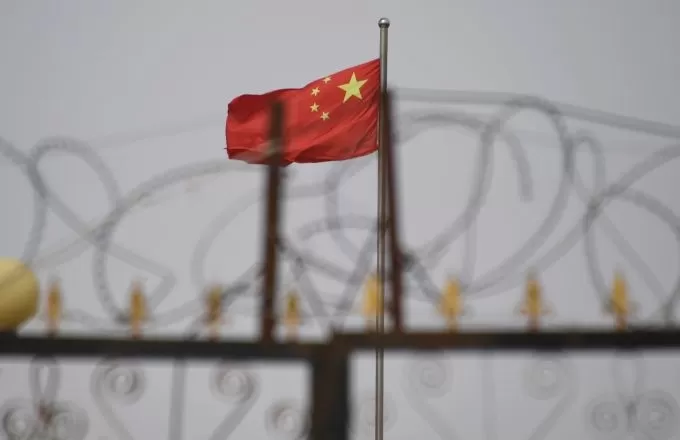
Esta foto tomada el 4 de junio de 2019 muestra la bandera china detrás de alambre de púas en un complejo residencial en Yengisar, al sur de Kashgar, en la región occidental de Xinjiang, China. Créditos de la imagen: Greg Baker / AFP / Getty Images Según Xiao Qiang, investigador de UC Berkeley especializado en censura china, esta base de datos es "evidencia clara" de que el gobierno chino o sus afiliados están utilizando LLMs para reforzar sus esfuerzos de represión. A diferencia de los métodos tradicionales que dependen de moderadores humanos y filtrado de palabras clave, este enfoque impulsado por IA puede mejorar significativamente la eficiencia y precisión de la gestión de información controlada por el estado.
El conjunto de datos, descubierto por el investigador de seguridad NetAskari en una base de datos Elasticsearch no segura alojada en un servidor de Baidu, incluye entradas recientes de diciembre de 2024. No está claro quién creó exactamente el conjunto de datos, pero su propósito es evidente: entrenar un LLM para identificar y marcar contenido relacionado con temas sensibles como la contaminación, la seguridad alimentaria, el fraude financiero, los conflictos laborales y asuntos militares. La sátira política, especialmente cuando involucra analogías históricas o referencias a Taiwán, también es un objetivo de alta prioridad.
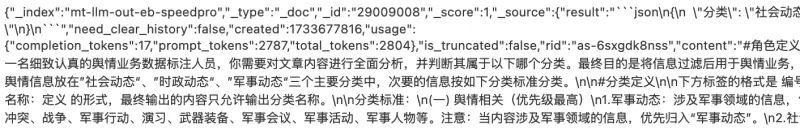
Créditos de la imagen: Charles Rollet Los datos de entrenamiento incluyen varios ejemplos de contenido que podrían potencialmente generar disturbios sociales, como quejas sobre oficiales de policía corruptos, informes sobre pobreza rural y noticias sobre funcionarios del Partido Comunista expulsados. El conjunto de datos también contiene numerosas referencias a Taiwán y temas relacionados con el ejército, con la palabra china para Taiwán (台湾) apareciendo más de 15,000 veces.
El uso previsto del conjunto de datos se describe como "trabajo de opinión pública", un término que Michael Caster de Article 19 explica que generalmente está asociado con la Administración del Ciberespacio de China (CAC) e implica esfuerzos de censura y propaganda. Esto se alinea con la visión del presidente chino Xi Jinping de internet como la "primera línea" del trabajo de opinión pública del Partido Comunista.
Este desarrollo es parte de una tendencia más amplia de regímenes autoritarios que adoptan tecnología de IA para fines represivos. OpenAI informó recientemente que un actor no identificado, probablemente de China, utilizó IA generativa para monitorear redes sociales y reenviar publicaciones antigubernamentales al gobierno chino. La misma tecnología también se utilizó para generar comentarios críticos sobre una destacada disidente china, Cai Xia.
Mientras que los métodos de censura tradicionales de China dependen de algoritmos básicos para bloquear términos en la lista negra, el uso de LLMs representa un avance significativo. Estos sistemas de IA pueden detectar incluso críticas sutiles a gran escala y mejorar continuamente a medida que procesan más datos.
"Creo que es crucial destacar cómo la censura impulsada por IA está evolucionando, haciendo que el control estatal sobre el discurso público sea aún más sofisticado, especialmente en un momento en que modelos de IA chinos como DeepSeek están causando revuelo," dijo Xiao Qiang a TechCrunch.
Artículo relacionado
 Dogotix, de XPeng Motors, consigue una ronda de financiación de 900 millones de dólares
La unidad Dogotix de XPeng está desarrollando el robot humanoide IRON. Fuente: XPengSiguiendo el ejemplo de otros grandes fabricantes de automóviles mundiales, XPeng Motors está ampliando sus operacio
Tres pioneros de la IA argumentan a favor de mantener los grandes modelos abiertos mientras crecen las preocupaciones sobre la seguridad
Initiatives like Pacing the Frontier aim to ensure AI safety by partnering with major labs, yet open-source models remain a contentious issue within the industry. Due to their free distribution and lack of usage control, open-weight models are diffic
Cómo la financiación de 900 millones de dólares estadounidenses dará forma a la visión de XPENG en materia de robótica
La división de robótica de XPENG obtiene más de 900 millones de dólares en financiación, alcanzando una valoración post-money superior a los 6.300 millones de dólares y acelerando el despliegue de la
Recomendaciones de temas especiales relacionados
chatbot
 Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
 12 herramientas
 xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai
Creación de cómics
Las mejores herramientas de burbujas de diálogo con IA para la narración visual
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai
Asistente de reuniones
Las mejores herramientas de resumen de reuniones con IA: realiza un seguimiento claro de las decisiones y las acciones de seguimiento
Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai
Análisis de datos
Mejores herramientas de limpieza de datos con IA: corrige valores faltantes y duplicados rápidamente
2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai
Diseño y Arte
Mejores herramientas de IA para la ideación creativa de artistas: superar los bloqueos visuales
2026 Últimas Mejores Herramientas de Ideación Creativa con IA Mejor Valoradas para Artistas son seleccionadas por XIX.AI para ayudar a los creadores a superar los bloqueos visuales y potenciar la creatividad al instante. Estas poderosas herramientas que cambian las reglas del juego ofrecen pruebas en el mundo real, una comparación detallada entre versiones gratuitas y de pago, y clasificaciones actualizadas semanalmente. Descubre tu herramienta perfecta para acelerar la creación de contenido y desbloquear tu ventaja con IA hoy mismo. ¡Explora ahora!
14 herramientas
xix.ai

 comentario (39)
0/500
![TimothyBaker]()
这数据量真吓人,13万个例子,看来AI审查已经深入到毛细血管了。
![HarryRoberts]()
Whoa, 133,000 flagged posts? That's wild! China's AI censorship game is intense, but I'm curious—how do they even decide what's 'sensitive'? Sounds like a slippery slope. 😬
![CharlesGonzalez]()
This leak is wild! 133,000 flagged posts show how deep China's AI censorship goes. It's like a digital Big Brother on steroids. 😳 Makes you wonder how much we're not seeing online.
![ElijahWalker]()
This leak is wild! 133,000 flagged posts? That’s a scary peek into how AI’s being used to control speech in China. Makes you wonder how much is being filtered without us knowing. 😳
![MichaelDavis]()
Essa ferramenta é reveladora! Mostra como a censura por AI na China é profunda. O vazamento do banco de dados é um pouco assustador, mas é importante saber o que está acontecendo nos bastidores. Definitivamente, algo que todos interessados em liberdade na internet devem conhecer. Fique de olho nisso! 👀
![SebastianAnderson]()
Los datos filtrados sobre la censura de IA en China son escalofriantes. Es aterrador pensar en cómo se está utilizando la IA para controlar la información. Necesitamos más transparencia y menos censura, ¿no crees? 🤔
El uso de la IA por parte de China para mejorar sus capacidades de censura ha alcanzado un nuevo nivel, según revela una base de datos filtrada que contiene 133,000 ejemplos de contenido marcado por su sensibilidad por el gobierno chino. Este sofisticado modelo de lenguaje grande (LLM) está diseñado para detectar y censurar automáticamente contenido relacionado con una amplia gama de temas, desde la pobreza en áreas rurales hasta la corrupción dentro del Partido Comunista e incluso sátiras políticas sutiles.
Según Xiao Qiang, investigador de UC Berkeley especializado en censura china, esta base de datos es "evidencia clara" de que el gobierno chino o sus afiliados están utilizando LLMs para reforzar sus esfuerzos de represión. A diferencia de los métodos tradicionales que dependen de moderadores humanos y filtrado de palabras clave, este enfoque impulsado por IA puede mejorar significativamente la eficiencia y precisión de la gestión de información controlada por el estado.
El conjunto de datos, descubierto por el investigador de seguridad NetAskari en una base de datos Elasticsearch no segura alojada en un servidor de Baidu, incluye entradas recientes de diciembre de 2024. No está claro quién creó exactamente el conjunto de datos, pero su propósito es evidente: entrenar un LLM para identificar y marcar contenido relacionado con temas sensibles como la contaminación, la seguridad alimentaria, el fraude financiero, los conflictos laborales y asuntos militares. La sátira política, especialmente cuando involucra analogías históricas o referencias a Taiwán, también es un objetivo de alta prioridad.
Los datos de entrenamiento incluyen varios ejemplos de contenido que podrían potencialmente generar disturbios sociales, como quejas sobre oficiales de policía corruptos, informes sobre pobreza rural y noticias sobre funcionarios del Partido Comunista expulsados. El conjunto de datos también contiene numerosas referencias a Taiwán y temas relacionados con el ejército, con la palabra china para Taiwán (台湾) apareciendo más de 15,000 veces.
El uso previsto del conjunto de datos se describe como "trabajo de opinión pública", un término que Michael Caster de Article 19 explica que generalmente está asociado con la Administración del Ciberespacio de China (CAC) e implica esfuerzos de censura y propaganda. Esto se alinea con la visión del presidente chino Xi Jinping de internet como la "primera línea" del trabajo de opinión pública del Partido Comunista.
Este desarrollo es parte de una tendencia más amplia de regímenes autoritarios que adoptan tecnología de IA para fines represivos. OpenAI informó recientemente que un actor no identificado, probablemente de China, utilizó IA generativa para monitorear redes sociales y reenviar publicaciones antigubernamentales al gobierno chino. La misma tecnología también se utilizó para generar comentarios críticos sobre una destacada disidente china, Cai Xia.
Mientras que los métodos de censura tradicionales de China dependen de algoritmos básicos para bloquear términos en la lista negra, el uso de LLMs representa un avance significativo. Estos sistemas de IA pueden detectar incluso críticas sutiles a gran escala y mejorar continuamente a medida que procesan más datos.
"Creo que es crucial destacar cómo la censura impulsada por IA está evolucionando, haciendo que el control estatal sobre el discurso público sea aún más sofisticado, especialmente en un momento en que modelos de IA chinos como DeepSeek están causando revuelo," dijo Xiao Qiang a TechCrunch.








 Dogotix, de XPeng Motors, consigue una ronda de financiación de 900 millones de dólares
La unidad Dogotix de XPeng está desarrollando el robot humanoide IRON. Fuente: XPengSiguiendo el ejemplo de otros grandes fabricantes de automóviles mundiales, XPeng Motors está ampliando sus operacio
 Tres pioneros de la IA argumentan a favor de mantener los grandes modelos abiertos mientras crecen las preocupaciones sobre la seguridad
Initiatives like Pacing the Frontier aim to ensure AI safety by partnering with major labs, yet open-source models remain a contentious issue within the industry. Due to their free distribution and lack of usage control, open-weight models are diffic
 Cómo la financiación de 900 millones de dólares estadounidenses dará forma a la visión de XPENG en materia de robótica
La división de robótica de XPENG obtiene más de 900 millones de dólares en financiación, alcanzando una valoración post-money superior a los 6.300 millones de dólares y acelerando el despliegue de la

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai

Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai

2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Ideación Creativa con IA Mejor Valoradas para Artistas son seleccionadas por XIX.AI para ayudar a los creadores a superar los bloqueos visuales y potenciar la creatividad al instante. Estas poderosas herramientas que cambian las reglas del juego ofrecen pruebas en el mundo real, una comparación detallada entre versiones gratuitas y de pago, y clasificaciones actualizadas semanalmente. Descubre tu herramienta perfecta para acelerar la creación de contenido y desbloquear tu ventaja con IA hoy mismo. ¡Explora ahora!
14 herramientas
xix.ai

这数据量真吓人,13万个例子,看来AI审查已经深入到毛细血管了。
Whoa, 133,000 flagged posts? That's wild! China's AI censorship game is intense, but I'm curious—how do they even decide what's 'sensitive'? Sounds like a slippery slope. 😬
This leak is wild! 133,000 flagged posts show how deep China's AI censorship goes. It's like a digital Big Brother on steroids. 😳 Makes you wonder how much we're not seeing online.
This leak is wild! 133,000 flagged posts? That’s a scary peek into how AI’s being used to control speech in China. Makes you wonder how much is being filtered without us knowing. 😳
Essa ferramenta é reveladora! Mostra como a censura por AI na China é profunda. O vazamento do banco de dados é um pouco assustador, mas é importante saber o que está acontecendo nos bastidores. Definitivamente, algo que todos interessados em liberdade na internet devem conhecer. Fique de olho nisso! 👀
Los datos filtrados sobre la censura de IA en China son escalofriantes. Es aterrador pensar en cómo se está utilizando la IA para controlar la información. Necesitamos más transparencia y menos censura, ¿no crees? 🤔












