


 家
漏れたデータによって暴露された中国のAI検閲
中国がAIを活用して検閲能力を強化したことは、13万3000件のコンテンツが中国政府によって機密性のためにフラグ付けされた漏洩データベースによって明らかにされ、新たなレベルに達しています。この高度な大規模言語モデル(LLM)は、農村部の貧困から共産党内の腐敗、さらには微妙な政治的風刺まで、幅広いトピックに関連するコンテンツを自動的に検出し、検閲するように設計されています。
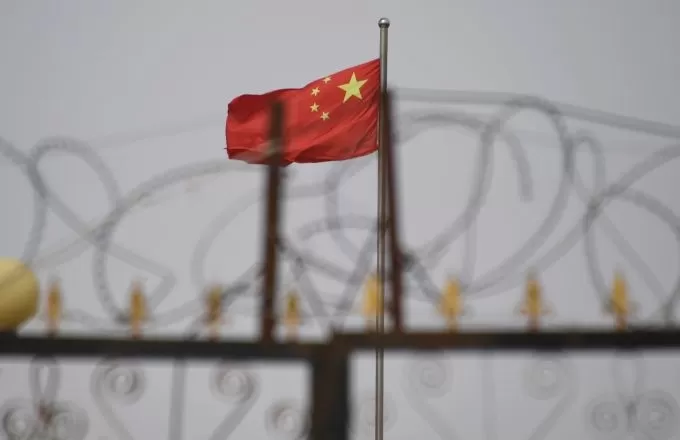
2019年6月4日に撮影されたこの写真は、中国西部の新疆地域、カシュガルの南にあるイェンギサールの住宅地で、有刺鉄線の背後にある中国国旗を示しています。画像クレジット:Greg Baker / AFP / Getty Images カリフォルニア大学バークレー校で中国の検閲を専門とする研究者、シャオ・チャンによると、このデータベースは中国政府またはその関連団体がLLMを使用して抑圧努力を強化している「明確な証拠」です。従来の人間のモデレーターやキーワードフィルタリングに依存する方法とは異なり、このAI駆動のアプローチは、国家が管理する情報管理の効率と精度を大幅に向上させることができます。
セキュリティ研究者のNetAskariが、Baiduサーバー上で保護されていないElasticsearchデータベースで発見したこのデータセットには、2024年12月からの最近のエントリーが含まれています。データセットを作成したのが誰かは不明ですが、その目的は明らかです:汚染、食品安全、金融詐欺、労働争議、軍事問題などの機密トピックに関連するコンテンツを特定し、フラグ付けするLLMを訓練することです。歴史的類推や台湾への言及を含む政治的風刺も、優先度の高いターゲットです。
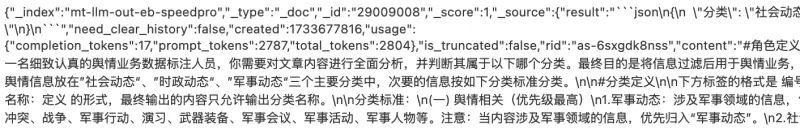
画像クレジット:Charles Rollet トレーニングデータには、腐敗した警察官への不満、農村部の貧困に関する報告、共産党から追放された役人に関するニュースなど、社会不安を引き起こす可能性のあるさまざまなコンテンツの例が含まれています。データセットには、台湾や軍事関連のトピックへの広範な言及も含まれており、「台湾」という中国語が1万5000回以上出現しています。
データセットの意図された用途は「世論工作」と記述されており、Article 19のマイケル・キャスターが説明するところでは、通常、中国サイバースペース管理局(CAC)に関連し、検閲とプロパガンダの努力を伴います。これは、中国の習近平国家主席がインターネットを共産党の世論工作の「最前線」と見なす見解と一致しています。
この発展は、権威主義政権が抑圧目的でAI技術を採用する広範な傾向の一部です。OpenAIは最近、中国と思われる未特定のアクターが生成AIを使用してソーシャルメディアを監視し、反政府的な投稿を中国政府に転送していたと報告しました。同じ技術は、著名な中国の反体制派、蔡霞に対する批判的なコメントを生成するためにも使用されました。
中国の従来の検閲方法は、ブラックリストに登録された用語をブロックする基本的なアルゴリズムに依存していますが、LLMの使用は大きな進歩を表しています。これらのAIシステムは、大規模な微妙な批判を検出し、データを処理するにつれて継続的に改善することができます。
「AI駆動の検閲がどのように進化しているかを強調することは、特にDeepSeekのような中国のAIモデルが注目を集めている時期に、国家が公共の言論をより高度に制御していることを示すために重要だと思います」と、シャオ・チャンはTechCrunchに語りました。
関連記事
 NvidiaのH200に関する中国との契約は、トランプ・習近平首脳会談を乗り切ったものの、予想通りにはいかなかった
トランプ大統領は、ジェンセン・フアン氏が土壇場で代表団に加わった状態で北京を訪問し、2日後に半導体輸出に関する今後の展開について曖昧な発言を残して帰国した。合意は成立しなかった。トランプ大統領が2025年12月に初めて販売を承認して以来、NvidiaのH200は1台も中国に届いていない。 ジェイミソン・グリア米通商代表はブルームバーグに対し、半導体規制については二国間協議の議題にすら上らなかったこ
Manusのストーリーが展開中:現在何が起きているのか
米国と中国は、世界で最も高度な人工知能を開発する熾烈な競争を展開している。北京は国内モデルに数十億ドルを投資し、テクノロジー分野への統制を強化するとともに、トップクラスの中国AI人材が米国企業へ流出する動向を密かに監視している。カーネギー国際平和財団が2023年後半に発表した研究によれば、2019年に米国の機関に在籍していたトップクラスの中国AI研究者100人中87人が、現在も同地に留まっていることが明らかになった。こうした背景にもかかわらず、非常に著名な中国のAIスタートアップであるManu
ヘキサゴン:成人の半数以上がロボットに魅力を感じている
ロボットはビジネス運営にますます組み込まれつつある。写真提供:HumanoidHexagonのデータによると、成人の59%がロボットと働くことに期待を寄せているが、子どもたちの間で台頭しつつある「ロボット世代」は、AIが導入された職場に対してはるかに強い意欲を示しているヘキサゴンの新たなデータによると、成人の半数以上がロボットと一緒に働くことに期待を寄せていることが示唆されている。このデータでは、
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (49)
0/500
![RyanLee]()
13萬筆資料?這規模太驚人了!AI 審查技術越來越精密,但擔心誤判太多。科技進步的同時,也該關注言論自由的邊界吧。🤖
![KevinMartinez]()
133 000 примеров? Это огромный объем данных для обучения моделей цензуры. Интересно, сколько ложных срабатываний происходит ежедневно. Технологии развиваются быстро, но вопрос свободы слова остается открытым. 🇷🇺
![AlbertRodriguez]()
133 mil exemplos? Uau, que escala! A IA chinesa está refinando a censura. Fico preocupado com as falsas positivas. Tecnologia é boa, mas falta nuance. 🇧🇷
![DouglasPerez]()
¡133.000 ejemplos! La IA china está avanzando rápido en censura. Me da miedo la cantidad de falsos positivos. ¿Cuánta libertad se pierde en el algoritmo? 🤔🇪🇸
![ScottMartinez]()
133.000 Beispiele? Das ist eine gewaltige Menge. Die KI-Zensur wird immer ausgefeilter, aber ich frage mich, wie viele Fehler sich schleichen. Ein faszinierendes, aber beunruhigendes Bild. 🇩🇪
![StevenGonzalez]()
13만 건의 데이터라니, 정말 대단하네요. AI 검열이 정교해지고 있지만, 맥락 무시로 인한 오검열이 걱정됩니다. 기술은 빠르지만 인간적 판단이 필요해 보여요. 🇰🇷
中国がAIを活用して検閲能力を強化したことは、13万3000件のコンテンツが中国政府によって機密性のためにフラグ付けされた漏洩データベースによって明らかにされ、新たなレベルに達しています。この高度な大規模言語モデル(LLM)は、農村部の貧困から共産党内の腐敗、さらには微妙な政治的風刺まで、幅広いトピックに関連するコンテンツを自動的に検出し、検閲するように設計されています。
カリフォルニア大学バークレー校で中国の検閲を専門とする研究者、シャオ・チャンによると、このデータベースは中国政府またはその関連団体がLLMを使用して抑圧努力を強化している「明確な証拠」です。従来の人間のモデレーターやキーワードフィルタリングに依存する方法とは異なり、このAI駆動のアプローチは、国家が管理する情報管理の効率と精度を大幅に向上させることができます。
セキュリティ研究者のNetAskariが、Baiduサーバー上で保護されていないElasticsearchデータベースで発見したこのデータセットには、2024年12月からの最近のエントリーが含まれています。データセットを作成したのが誰かは不明ですが、その目的は明らかです:汚染、食品安全、金融詐欺、労働争議、軍事問題などの機密トピックに関連するコンテンツを特定し、フラグ付けするLLMを訓練することです。歴史的類推や台湾への言及を含む政治的風刺も、優先度の高いターゲットです。
トレーニングデータには、腐敗した警察官への不満、農村部の貧困に関する報告、共産党から追放された役人に関するニュースなど、社会不安を引き起こす可能性のあるさまざまなコンテンツの例が含まれています。データセットには、台湾や軍事関連のトピックへの広範な言及も含まれており、「台湾」という中国語が1万5000回以上出現しています。
データセットの意図された用途は「世論工作」と記述されており、Article 19のマイケル・キャスターが説明するところでは、通常、中国サイバースペース管理局(CAC)に関連し、検閲とプロパガンダの努力を伴います。これは、中国の習近平国家主席がインターネットを共産党の世論工作の「最前線」と見なす見解と一致しています。
この発展は、権威主義政権が抑圧目的でAI技術を採用する広範な傾向の一部です。OpenAIは最近、中国と思われる未特定のアクターが生成AIを使用してソーシャルメディアを監視し、反政府的な投稿を中国政府に転送していたと報告しました。同じ技術は、著名な中国の反体制派、蔡霞に対する批判的なコメントを生成するためにも使用されました。
中国の従来の検閲方法は、ブラックリストに登録された用語をブロックする基本的なアルゴリズムに依存していますが、LLMの使用は大きな進歩を表しています。これらのAIシステムは、大規模な微妙な批判を検出し、データを処理するにつれて継続的に改善することができます。
「AI駆動の検閲がどのように進化しているかを強調することは、特にDeepSeekのような中国のAIモデルが注目を集めている時期に、国家が公共の言論をより高度に制御していることを示すために重要だと思います」と、シャオ・チャンはTechCrunchに語りました。








 NvidiaのH200に関する中国との契約は、トランプ・習近平首脳会談を乗り切ったものの、予想通りにはいかなかった
トランプ大統領は、ジェンセン・フアン氏が土壇場で代表団に加わった状態で北京を訪問し、2日後に半導体輸出に関する今後の展開について曖昧な発言を残して帰国した。合意は成立しなかった。トランプ大統領が2025年12月に初めて販売を承認して以来、NvidiaのH200は1台も中国に届いていない。 ジェイミソン・グリア米通商代表はブルームバーグに対し、半導体規制については二国間協議の議題にすら上らなかったこ
 Manusのストーリーが展開中:現在何が起きているのか
米国と中国は、世界で最も高度な人工知能を開発する熾烈な競争を展開している。北京は国内モデルに数十億ドルを投資し、テクノロジー分野への統制を強化するとともに、トップクラスの中国AI人材が米国企業へ流出する動向を密かに監視している。カーネギー国際平和財団が2023年後半に発表した研究によれば、2019年に米国の機関に在籍していたトップクラスの中国AI研究者100人中87人が、現在も同地に留まっていることが明らかになった。こうした背景にもかかわらず、非常に著名な中国のAIスタートアップであるManu
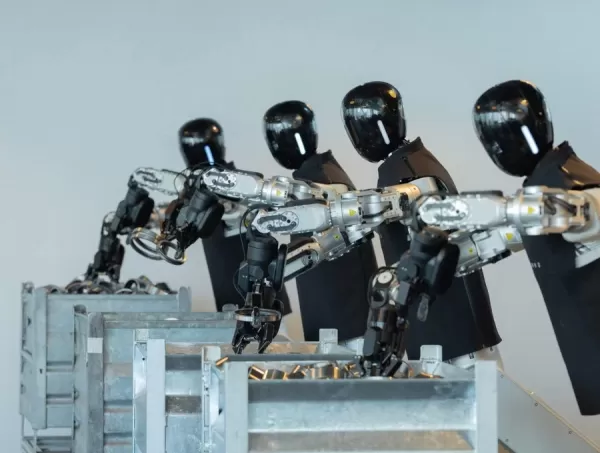 ヘキサゴン:成人の半数以上がロボットに魅力を感じている
ロボットはビジネス運営にますます組み込まれつつある。写真提供:HumanoidHexagonのデータによると、成人の59%がロボットと働くことに期待を寄せているが、子どもたちの間で台頭しつつある「ロボット世代」は、AIが導入された職場に対してはるかに強い意欲を示しているヘキサゴンの新たなデータによると、成人の半数以上がロボットと一緒に働くことに期待を寄せていることが示唆されている。このデータでは、

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

13萬筆資料?這規模太驚人了!AI 審查技術越來越精密,但擔心誤判太多。科技進步的同時,也該關注言論自由的邊界吧。🤖
133 000 примеров? Это огромный объем данных для обучения моделей цензуры. Интересно, сколько ложных срабатываний происходит ежедневно. Технологии развиваются быстро, но вопрос свободы слова остается открытым. 🇷🇺
133 mil exemplos? Uau, que escala! A IA chinesa está refinando a censura. Fico preocupado com as falsas positivas. Tecnologia é boa, mas falta nuance. 🇧🇷
¡133.000 ejemplos! La IA china está avanzando rápido en censura. Me da miedo la cantidad de falsos positivos. ¿Cuánta libertad se pierde en el algoritmo? 🤔🇪🇸
133.000 Beispiele? Das ist eine gewaltige Menge. Die KI-Zensur wird immer ausgefeilter, aber ich frage mich, wie viele Fehler sich schleichen. Ein faszinierendes, aber beunruhigendes Bild. 🇩🇪
13만 건의 데이터라니, 정말 대단하네요. AI 검열이 정교해지고 있지만, 맥락 무시로 인한 오검열이 걱정됩니다. 기술은 빠르지만 인간적 판단이 필요해 보여요. 🇰🇷












