


 首页
中国人工智能审查制度被泄漏的数据暴露
中国利用人工智能增强其审查能力已达到一个新水平,一份泄露的数据库显示,中国政府标记了133,000个敏感内容示例。这一复杂的大型语言模型(LLM)旨在自动检测和审查与多种话题相关的内容,从农村贫困到共产党内部的腐败,甚至是微妙的政治讽刺。
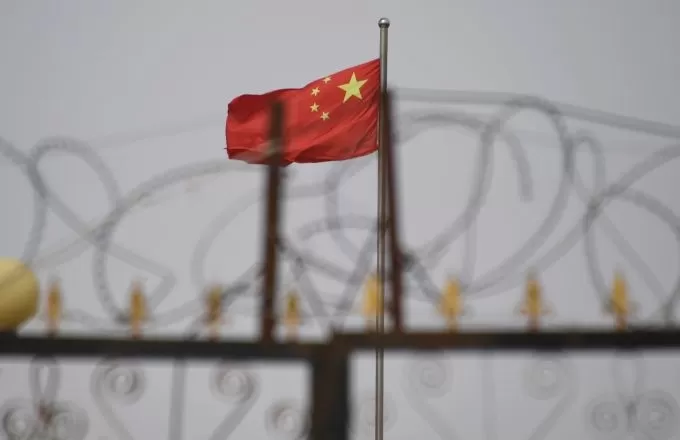
这张摄于2019年6月4日的照片显示,中国西部新疆地区喀什以南的焉耆县一处住宅区内,中国国旗在铁丝网后。图片来源:Greg Baker / AFP / Getty Images 据加州大学伯克利分校专门研究中国审查制度的研究员肖强表示,这一数据库是“明确证据”,证明中国政府或其关联机构正在使用大型语言模型来加强其压制努力。与依赖人工审查员和关键词过滤的传统方法不同,这种人工智能驱动的方法可以显著提高国家控制信息管理的效率和精确度。
该数据集由安全研究员NetAskari在一个未受保护的、托管在百度服务器上的Elasticsearch数据库中发现,包含2024年12月的最新条目。目前尚不清楚具体是谁创建了这个数据集,但其目的显而易见:训练大型语言模型以识别和标记与敏感话题相关的内容,如污染、食品安全、金融诈骗、劳动争议和军事事务。政治讽刺,尤其是涉及历史类比或台湾的内容,也是优先审查目标。
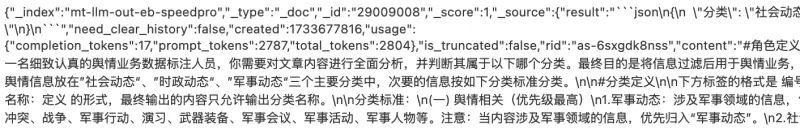
图片来源:Charles Rollet 训练数据包括可能引发社会动荡的各种内容示例,如对腐败警察的投诉、关于农村贫困的报道,以及关于被开除的共产党官员的新闻。数据集还包含大量关于台湾和军事相关话题的提及,其中“台湾”一词出现了超过15,000次。
数据集的用途被描述为“舆论工作”,Article 19的Michael Caster解释说,这个术语通常与中国国家互联网信息办公室(CAC)相关,涉及审查和宣传工作。这与习近平主席将互联网视为共产党舆论工作“前线”的观点一致。
这一发展是专制政权采用人工智能技术进行压制目的的更广泛趋势的一部分。OpenAI最近报告称,一个可能是来自中国的未识别行为者使用生成式人工智能监控社交媒体,并将反政府帖子转发给中国政府。同一技术还被用于生成针对著名中国异见人士蔡霞的批评评论。
虽然中国的传统审查方法依赖基本算法来屏蔽黑名单术语,但使用大型语言模型代表了重大进步。这些人工智能系统可以大规模检测甚至微妙的批评,并随着处理更多数据而不断改进。
“我认为必须强调人工智能驱动的审查如何演变,使国家对公共话语的控制更加复杂,尤其是在DeepSeek等中国人工智能模型掀起波澜的时刻,”肖强对TechCrunch表示。
相关文章
 英伟达H200中国交易在特朗普与习近平峰会后得以保留,但结果与预期不符
特朗普总统前往北京,黄仁勋在最后一刻加入了代表团,两天后离京时仅就芯片出口的潜在进展发表了含糊其辞的言论。双方未达成任何协议。自特朗普于2025年12月首次批准销售以来,尚未有一颗英伟达H200芯片进入中国。 美国贸易代表杰米森·格里尔向彭博社证实,半导体限制措施甚至未被列入双边议程。在峰会的盛况之下,隐藏着更重大的转变。H200芯片的供应受阻并非源于华盛顿的拒绝;美国实际上已经批准了出口。 包括
Manus 故事展开:当前正在发生什么
美国和中国正在激烈竞争,以开发世界上最先进的人工智能。北京正投入数十亿美元用于国内模型,加强对科技行业的管控,并密切监控中国顶尖人工智能人才流向美国公司的趋势。卡内基国际和平基金会2023年底的一项研究显示,2019年在美国机构任职的前100名中国顶尖人工智能研究人员中,有87人仍留在美国。尽管存在这一背景,一家备受瞩目的中国人工智能初创公司Manus悄然将业务迁至新加坡,并被Meta以20亿美元收购。几乎没有观察者质疑这一合作的影响。正如行业专家所知,Manus在去年春天因一段演示视频而受
Hexagon:超过半数的成年人对机器人充满热情
机器人正越来越多地融入企业运营。图片来源:HumanoidHexagon的数据表明,59%的成年人对与机器人共事感到兴奋,但正在崛起的“机器人一代”儿童对人工智能工作场所的期待更为强烈Hexagon的最新数据显示,超过半数的成年人对与机器人共事的前景感到兴奋。该数据将成年人的观点与儿童的观点进行了对比,后者持有不同看法,并将引领下一代。数据显示,五分之四的儿童(80%)表示对机器人充满期待,而成年
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (49)
0/500
![RyanLee]()
13萬筆資料?這規模太驚人了!AI 審查技術越來越精密,但擔心誤判太多。科技進步的同時,也該關注言論自由的邊界吧。🤖
![KevinMartinez]()
133 000 примеров? Это огромный объем данных для обучения моделей цензуры. Интересно, сколько ложных срабатываний происходит ежедневно. Технологии развиваются быстро, но вопрос свободы слова остается открытым. 🇷🇺
![AlbertRodriguez]()
133 mil exemplos? Uau, que escala! A IA chinesa está refinando a censura. Fico preocupado com as falsas positivas. Tecnologia é boa, mas falta nuance. 🇧🇷
![DouglasPerez]()
¡133.000 ejemplos! La IA china está avanzando rápido en censura. Me da miedo la cantidad de falsos positivos. ¿Cuánta libertad se pierde en el algoritmo? 🤔🇪🇸
![ScottMartinez]()
133.000 Beispiele? Das ist eine gewaltige Menge. Die KI-Zensur wird immer ausgefeilter, aber ich frage mich, wie viele Fehler sich schleichen. Ein faszinierendes, aber beunruhigendes Bild. 🇩🇪
![StevenGonzalez]()
13만 건의 데이터라니, 정말 대단하네요. AI 검열이 정교해지고 있지만, 맥락 무시로 인한 오검열이 걱정됩니다. 기술은 빠르지만 인간적 판단이 필요해 보여요. 🇰🇷
中国利用人工智能增强其审查能力已达到一个新水平,一份泄露的数据库显示,中国政府标记了133,000个敏感内容示例。这一复杂的大型语言模型(LLM)旨在自动检测和审查与多种话题相关的内容,从农村贫困到共产党内部的腐败,甚至是微妙的政治讽刺。
据加州大学伯克利分校专门研究中国审查制度的研究员肖强表示,这一数据库是“明确证据”,证明中国政府或其关联机构正在使用大型语言模型来加强其压制努力。与依赖人工审查员和关键词过滤的传统方法不同,这种人工智能驱动的方法可以显著提高国家控制信息管理的效率和精确度。
该数据集由安全研究员NetAskari在一个未受保护的、托管在百度服务器上的Elasticsearch数据库中发现,包含2024年12月的最新条目。目前尚不清楚具体是谁创建了这个数据集,但其目的显而易见:训练大型语言模型以识别和标记与敏感话题相关的内容,如污染、食品安全、金融诈骗、劳动争议和军事事务。政治讽刺,尤其是涉及历史类比或台湾的内容,也是优先审查目标。
训练数据包括可能引发社会动荡的各种内容示例,如对腐败警察的投诉、关于农村贫困的报道,以及关于被开除的共产党官员的新闻。数据集还包含大量关于台湾和军事相关话题的提及,其中“台湾”一词出现了超过15,000次。
数据集的用途被描述为“舆论工作”,Article 19的Michael Caster解释说,这个术语通常与中国国家互联网信息办公室(CAC)相关,涉及审查和宣传工作。这与习近平主席将互联网视为共产党舆论工作“前线”的观点一致。
这一发展是专制政权采用人工智能技术进行压制目的的更广泛趋势的一部分。OpenAI最近报告称,一个可能是来自中国的未识别行为者使用生成式人工智能监控社交媒体,并将反政府帖子转发给中国政府。同一技术还被用于生成针对著名中国异见人士蔡霞的批评评论。
虽然中国的传统审查方法依赖基本算法来屏蔽黑名单术语,但使用大型语言模型代表了重大进步。这些人工智能系统可以大规模检测甚至微妙的批评,并随着处理更多数据而不断改进。
“我认为必须强调人工智能驱动的审查如何演变,使国家对公共话语的控制更加复杂,尤其是在DeepSeek等中国人工智能模型掀起波澜的时刻,”肖强对TechCrunch表示。








 英伟达H200中国交易在特朗普与习近平峰会后得以保留,但结果与预期不符
特朗普总统前往北京,黄仁勋在最后一刻加入了代表团,两天后离京时仅就芯片出口的潜在进展发表了含糊其辞的言论。双方未达成任何协议。自特朗普于2025年12月首次批准销售以来,尚未有一颗英伟达H200芯片进入中国。 美国贸易代表杰米森·格里尔向彭博社证实,半导体限制措施甚至未被列入双边议程。在峰会的盛况之下,隐藏着更重大的转变。H200芯片的供应受阻并非源于华盛顿的拒绝;美国实际上已经批准了出口。 包括
 Manus 故事展开:当前正在发生什么
美国和中国正在激烈竞争,以开发世界上最先进的人工智能。北京正投入数十亿美元用于国内模型,加强对科技行业的管控,并密切监控中国顶尖人工智能人才流向美国公司的趋势。卡内基国际和平基金会2023年底的一项研究显示,2019年在美国机构任职的前100名中国顶尖人工智能研究人员中,有87人仍留在美国。尽管存在这一背景,一家备受瞩目的中国人工智能初创公司Manus悄然将业务迁至新加坡,并被Meta以20亿美元收购。几乎没有观察者质疑这一合作的影响。正如行业专家所知,Manus在去年春天因一段演示视频而受
 Hexagon:超过半数的成年人对机器人充满热情
机器人正越来越多地融入企业运营。图片来源:HumanoidHexagon的数据表明,59%的成年人对与机器人共事感到兴奋,但正在崛起的“机器人一代”儿童对人工智能工作场所的期待更为强烈Hexagon的最新数据显示,超过半数的成年人对与机器人共事的前景感到兴奋。该数据将成年人的观点与儿童的观点进行了对比,后者持有不同看法,并将引领下一代。数据显示,五分之四的儿童(80%)表示对机器人充满期待,而成年

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

13萬筆資料?這規模太驚人了!AI 審查技術越來越精密,但擔心誤判太多。科技進步的同時,也該關注言論自由的邊界吧。🤖
133 000 примеров? Это огромный объем данных для обучения моделей цензуры. Интересно, сколько ложных срабатываний происходит ежедневно. Технологии развиваются быстро, но вопрос свободы слова остается открытым. 🇷🇺
133 mil exemplos? Uau, que escala! A IA chinesa está refinando a censura. Fico preocupado com as falsas positivas. Tecnologia é boa, mas falta nuance. 🇧🇷
¡133.000 ejemplos! La IA china está avanzando rápido en censura. Me da miedo la cantidad de falsos positivos. ¿Cuánta libertad se pierde en el algoritmo? 🤔🇪🇸
133.000 Beispiele? Das ist eine gewaltige Menge. Die KI-Zensur wird immer ausgefeilter, aber ich frage mich, wie viele Fehler sich schleichen. Ein faszinierendes, aber beunruhigendes Bild. 🇩🇪
13만 건의 데이터라니, 정말 대단하네요. AI 검열이 정교해지고 있지만, 맥락 무시로 인한 오검열이 걱정됩니다. 기술은 빠르지만 인간적 판단이 필요해 보여요. 🇰🇷












