


 Дом
Китайская цензура ИИ, выявленная просочившимися данными
Использование Китаем искусственного интеллекта для усиления своих цензурных возможностей достигло нового уровня, как показывает утёкшая база данных, содержащая 133 000 примеров контента, помеченного как чувствительный китайским правительством. Эта сложная большая языковая модель (LLM) разработана для автоматического обнаружения и цензурирования контента, связанного с широким спектром тем, от бедности в сельских районах до коррупции в Коммунистической партии и даже тонкой политической сатиры.
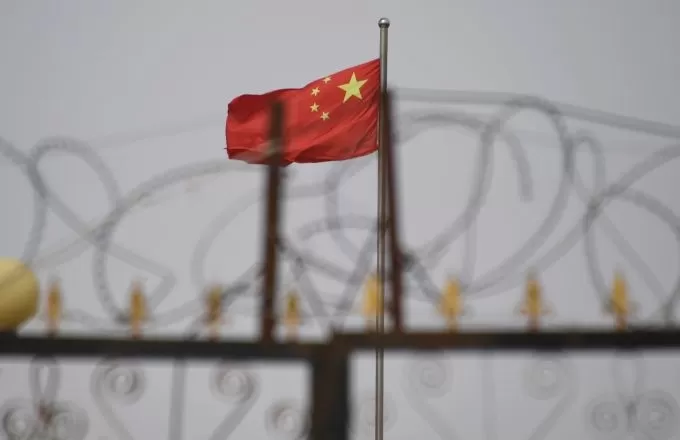
Эта фотография, сделанная 4 июня 2019 года, показывает китайский флаг за колючей проволокой в жилом комплексе в Йенгисаре, к югу от Кашгара, в западном регионе Синьцзян в Китае. Источник изображения: Greg Baker / AFP / Getty Images По словам Сяо Цяна, исследователя из UC Berkeley, специализирующегося на китайской цензуре, эта база данных является "явным доказательством" того, что китайское правительство или его аффилированные структуры используют LLM для усиления своих репрессивных усилий. В отличие от традиционных методов, зависящих от модераторов-людей и фильтрации по ключевым словам, этот подход, основанный на искусственном интеллекте, значительно повышает эффективность и точность государственного управления информацией.
Набор данных, обнаруженный исследователем безопасности NetAskari в незащищённой базе данных Elasticsearch, размещённой на сервере Baidu, включает недавние записи от декабря 2024 года. Неясно, кто именно создал этот набор данных, но его цель очевидна: обучить LLM выявлять и помечать контент, связанный с чувствительными темами, такими как загрязнение окружающей среды, безопасность пищевых продуктов, финансовые махинации, трудовые споры и военные вопросы. Политическая сатира, особенно если она включает исторические аналогии или упоминания Тайваня, также является приоритетной целью.
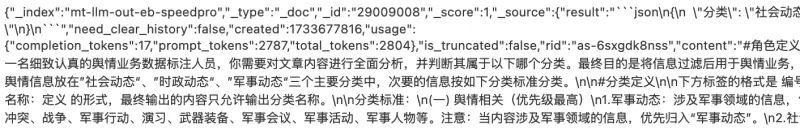
Источник изображения: Charles Rollet Обучающие данные включают различные примеры контента, который потенциально может вызвать социальные волнения, такие как жалобы на коррумпированных полицейских, сообщения о бедности в сельской местности и новости об исключённых из Коммунистической партии чиновниках. Набор данных также содержит множество ссылок на Тайвань и военные темы, при этом китайское слово для Тайваня (台湾) встречается более 15 000 раз.
Предполагаемое использование набора данных описывается как "работа с общественным мнением", термин, который, по словам Майкла Кастера из Article 19, обычно ассоциируется с Управлением киберпространства Китая (CAC) и включает усилия по цензуре и пропаганде. Это соответствует взглядам президента Китая Си Цзиньпина, который считает интернет "передовой линией" работы Коммунистической партии с общественным мнением.
Это развитие является частью более широкой тенденции, когда авторитарные режимы используют технологии искусственного интеллекта в репрессивных целях. OpenAI недавно сообщила, что неустановленный субъект, вероятно из Китая, использовал генеративный ИИ для мониторинга социальных сетей и пересылки антиправительственных постов китайскому правительству. Та же технология использовалась для генерации критических комментариев о известной китайской диссидентке Цай Ся.
Хотя традиционные методы цензуры в Китае полагаются на базовые алгоритмы для блокировки запрещённых терминов, использование LLM представляет значительный прогресс. Эти системы ИИ способны обнаруживать даже тонкую критику в массовом масштабе и постоянно совершенствуются по мере обработки большего объёма данных.
"Я считаю важным подчеркнуть, как развивается цензура, основанная на искусственном интеллекте, делая государственный контроль над общественным дискурсом ещё более изощрённым, особенно в то время, когда китайские модели ИИ, такие как DeepSeek, вызывают волну интереса", — сказал Сяо Цян в интервью TechCrunch.
Связанная статья
 Dogotix, принадлежащая XPeng Motors, привлекла финансирование в размере 900 млн долларов
Подразделение Dogotix компании XPeng занимается разработкой гуманоидного робота IRON. Источник: XPengСледуя примеру других крупных мировых автопроизводителей, компания XPeng Motors расширяет свою деят
Три пионера искусственного интеллекта выступают за сохранение больших моделей открытыми, поскольку растут опасения по поводу безопасности
Инициативы, такие как Pacing the Frontier, направлены на обеспечение безопасности искусственного интеллекта путем партнерства с ведущими лабораториями, однако модели с открытым исходным кодом остаются спорным вопросом в отрасли. Из-за их бесплатного
Как финансирование в размере 900 млн долларов США повлияет на реализацию концепции XPENG в области робототехники
Подразделение XPENG, занимающееся робототехникой, привлекло более 900 млн долларов США финансирования, достигнув оценки компании после привлечения инвестиций, превышающей 6,3 млрд долларов США, и уско
Рекомендации по связанным специальным темам
чат-бот
 Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
 12 инструментов
 xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai
Помощник по встречам
Лучшие инструменты для составления отчетов о встречах с использованием ИИ: четкое отслеживание решений и последующих действий
2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai
Анализ данных
Лучшие инструменты для очистки данных с использованием ИИ: быстрое устранение пропущенных значений и дубликатов
2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для творческого мышления на основе ИИ для художников: преодоление визуальных блоков
В 2026 году лучшие и наиболее популярные инструменты для творческого мышления с использованием ИИ для художников были отобраны XIX.AI, чтобы помочь создателям преодолеть визуальные блоки и мгновенно повысить креативность. Эти мощные инструменты, меняющие правила игры, предлагают реальные тесты, подробное сравнение бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите идеальный инструмент для ускорения создания контента и откройте свой ИИ-преимущество уже сегодня. Исследуйте сейчас!
14 инструментов
xix.ai

 Комментарии (39)
![TimothyBaker]()
这数据量真吓人,13万个例子,看来AI审查已经深入到毛细血管了。
![HarryRoberts]()
Whoa, 133,000 flagged posts? That's wild! China's AI censorship game is intense, but I'm curious—how do they even decide what's 'sensitive'? Sounds like a slippery slope. 😬
![CharlesGonzalez]()
This leak is wild! 133,000 flagged posts show how deep China's AI censorship goes. It's like a digital Big Brother on steroids. 😳 Makes you wonder how much we're not seeing online.
![ElijahWalker]()
This leak is wild! 133,000 flagged posts? That’s a scary peek into how AI’s being used to control speech in China. Makes you wonder how much is being filtered without us knowing. 😳
![MichaelDavis]()
Essa ferramenta é reveladora! Mostra como a censura por AI na China é profunda. O vazamento do banco de dados é um pouco assustador, mas é importante saber o que está acontecendo nos bastidores. Definitivamente, algo que todos interessados em liberdade na internet devem conhecer. Fique de olho nisso! 👀
![SebastianAnderson]()
Los datos filtrados sobre la censura de IA en China son escalofriantes. Es aterrador pensar en cómo se está utilizando la IA para controlar la información. Necesitamos más transparencia y menos censura, ¿no crees? 🤔
Использование Китаем искусственного интеллекта для усиления своих цензурных возможностей достигло нового уровня, как показывает утёкшая база данных, содержащая 133 000 примеров контента, помеченного как чувствительный китайским правительством. Эта сложная большая языковая модель (LLM) разработана для автоматического обнаружения и цензурирования контента, связанного с широким спектром тем, от бедности в сельских районах до коррупции в Коммунистической партии и даже тонкой политической сатиры.
По словам Сяо Цяна, исследователя из UC Berkeley, специализирующегося на китайской цензуре, эта база данных является "явным доказательством" того, что китайское правительство или его аффилированные структуры используют LLM для усиления своих репрессивных усилий. В отличие от традиционных методов, зависящих от модераторов-людей и фильтрации по ключевым словам, этот подход, основанный на искусственном интеллекте, значительно повышает эффективность и точность государственного управления информацией.
Набор данных, обнаруженный исследователем безопасности NetAskari в незащищённой базе данных Elasticsearch, размещённой на сервере Baidu, включает недавние записи от декабря 2024 года. Неясно, кто именно создал этот набор данных, но его цель очевидна: обучить LLM выявлять и помечать контент, связанный с чувствительными темами, такими как загрязнение окружающей среды, безопасность пищевых продуктов, финансовые махинации, трудовые споры и военные вопросы. Политическая сатира, особенно если она включает исторические аналогии или упоминания Тайваня, также является приоритетной целью.
Обучающие данные включают различные примеры контента, который потенциально может вызвать социальные волнения, такие как жалобы на коррумпированных полицейских, сообщения о бедности в сельской местности и новости об исключённых из Коммунистической партии чиновниках. Набор данных также содержит множество ссылок на Тайвань и военные темы, при этом китайское слово для Тайваня (台湾) встречается более 15 000 раз.
Предполагаемое использование набора данных описывается как "работа с общественным мнением", термин, который, по словам Майкла Кастера из Article 19, обычно ассоциируется с Управлением киберпространства Китая (CAC) и включает усилия по цензуре и пропаганде. Это соответствует взглядам президента Китая Си Цзиньпина, который считает интернет "передовой линией" работы Коммунистической партии с общественным мнением.
Это развитие является частью более широкой тенденции, когда авторитарные режимы используют технологии искусственного интеллекта в репрессивных целях. OpenAI недавно сообщила, что неустановленный субъект, вероятно из Китая, использовал генеративный ИИ для мониторинга социальных сетей и пересылки антиправительственных постов китайскому правительству. Та же технология использовалась для генерации критических комментариев о известной китайской диссидентке Цай Ся.
Хотя традиционные методы цензуры в Китае полагаются на базовые алгоритмы для блокировки запрещённых терминов, использование LLM представляет значительный прогресс. Эти системы ИИ способны обнаруживать даже тонкую критику в массовом масштабе и постоянно совершенствуются по мере обработки большего объёма данных.
"Я считаю важным подчеркнуть, как развивается цензура, основанная на искусственном интеллекте, делая государственный контроль над общественным дискурсом ещё более изощрённым, особенно в то время, когда китайские модели ИИ, такие как DeepSeek, вызывают волну интереса", — сказал Сяо Цян в интервью TechCrunch.








 Dogotix, принадлежащая XPeng Motors, привлекла финансирование в размере 900 млн долларов
Подразделение Dogotix компании XPeng занимается разработкой гуманоидного робота IRON. Источник: XPengСледуя примеру других крупных мировых автопроизводителей, компания XPeng Motors расширяет свою деят
 Три пионера искусственного интеллекта выступают за сохранение больших моделей открытыми, поскольку растут опасения по поводу безопасности
Инициативы, такие как Pacing the Frontier, направлены на обеспечение безопасности искусственного интеллекта путем партнерства с ведущими лабораториями, однако модели с открытым исходным кодом остаются спорным вопросом в отрасли. Из-за их бесплатного
 Как финансирование в размере 900 млн долларов США повлияет на реализацию концепции XPENG в области робототехники
Подразделение XPENG, занимающееся робототехникой, привлекло более 900 млн долларов США финансирования, достигнув оценки компании после привлечения инвестиций, превышающей 6,3 млрд долларов США, и уско

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai

В 2026 году лучшие и наиболее популярные инструменты для творческого мышления с использованием ИИ для художников были отобраны XIX.AI, чтобы помочь создателям преодолеть визуальные блоки и мгновенно повысить креативность. Эти мощные инструменты, меняющие правила игры, предлагают реальные тесты, подробное сравнение бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите идеальный инструмент для ускорения создания контента и откройте свой ИИ-преимущество уже сегодня. Исследуйте сейчас!
14 инструментов
xix.ai

这数据量真吓人,13万个例子,看来AI审查已经深入到毛细血管了。
Whoa, 133,000 flagged posts? That's wild! China's AI censorship game is intense, but I'm curious—how do they even decide what's 'sensitive'? Sounds like a slippery slope. 😬
This leak is wild! 133,000 flagged posts show how deep China's AI censorship goes. It's like a digital Big Brother on steroids. 😳 Makes you wonder how much we're not seeing online.
This leak is wild! 133,000 flagged posts? That’s a scary peek into how AI’s being used to control speech in China. Makes you wonder how much is being filtered without us knowing. 😳
Essa ferramenta é reveladora! Mostra como a censura por AI na China é profunda. O vazamento do banco de dados é um pouco assustador, mas é importante saber o que está acontecendo nos bastidores. Definitivamente, algo que todos interessados em liberdade na internet devem conhecer. Fique de olho nisso! 👀
Los datos filtrados sobre la censura de IA en China son escalofriantes. Es aterrador pensar en cómo se está utilizando la IA para controlar la información. Necesitamos más transparencia y menos censura, ¿no crees? 🤔












