


 Heim
Die LLMs von Deep Cogito übertreffen ähnliche Modelle mit ähnlicher Größe mit IDA
Deep Cogito, ein in San Francisco ansässiges Unternehmen, sorgt in der AI-Community für Aufsehen mit seiner neuesten Veröffentlichung von offenen großen Sprachmodellen (LLMs). Diese Modelle, die in verschiedenen Größen von 3 Milliarden bis 70 Milliarden Parametern reichen, sind nicht nur ein weiterer Satz von AI-Tools; sie sind ein mutiger Schritt hin zu dem, was das Unternehmen „allgemeine Superintelligenz“ nennt. Deep Cogito behauptet, dass jedes ihrer Modelle die führenden offenen Modelle ähnlicher Größe, einschließlich derer von LLAMA, DeepSeek und Qwen, in den meisten Standard-Benchmarks übertrifft. Das ist eine beachtliche Behauptung, aber noch beeindruckender ist, dass ihr 70B-Modell Berichten zufolge das kürzlich veröffentlichte Llama 4 109B Mixture-of-Experts (MoE)-Modell übertrumpft hat.
Iterierte Destillation und Amplifikation (IDA)
Das Herzstück des Durchbruchs von Deep Cogito ist ein neuer Trainingsansatz, den sie Iterierte Destillation und Amplifikation (IDA) nennen. Diese Methode wird als „skalierbare und effiziente Ausrichtungsstrategie für allgemeine Superintelligenz durch iterative Selbstverbesserung“ beschrieben. Sie ist darauf ausgelegt, die Grenzen des traditionellen LLM-Trainings zu überwinden, bei dem die Intelligenz des Modells oft an eine Obergrenze stößt, die durch größere „Überwacher“-Modelle oder menschliche Kuratoren definiert ist.
Der IDA-Prozess dreht sich um zwei wesentliche Schritte, die immer wieder wiederholt werden:
- Amplifikation: Dieser Schritt nutzt mehr Rechenleistung, um dem Modell zu helfen, bessere Lösungen oder Fähigkeiten zu entwickeln, ähnlich wie fortschrittliche Denktechniken.
- Destillation: Hier verinnerlicht das Modell diese verbesserten Fähigkeiten und verfeinert seine Parameter.
Deep Cogito argumentiert, dass dies eine „positive Rückkopplungsschleife“ schafft, die es der Intelligenz des Modells ermöglicht, direkter mit den Rechenressourcen und der Effizienz des IDA-Prozesses selbst zu wachsen, anstatt durch die Intelligenz eines Überwachers begrenzt zu sein.
Das Unternehmen verweist auf historische Erfolge wie AlphaGo und betont, dass „fortschrittliches Denken und iterative Selbstverbesserung“ entscheidend waren. IDA, so behaupten sie, bringt diese Elemente in das LLM-Training. Sie preisen auch die Effizienz von IDA und stellen fest, dass ihr kleines Team es geschafft hat, diese Modelle in nur etwa 75 Tagen zu entwickeln. Im Vergleich zu anderen Methoden wie Reinforcement Learning from Human Feedback (RLHF) oder Standard-Destillation von größeren Modellen soll IDA eine bessere Skalierbarkeit bieten.
Als Beweis hebt Deep Cogito hervor, wie ihr 70B-Modell sowohl Llama 3.3 70B (destilliert aus einem 405B-Modell) als auch Llama 4 Scout 109B (destilliert aus einem 2T-Parameter-Modell) übertrifft.
Fähigkeiten und Leistung der Deep Cogito-Modelle
Die neuen Cogito-Modelle, die auf Llama- und Qwen-Checkpoints aufbauen, sind auf Codierung, Funktionsaufrufe und agentische Anwendungen zugeschnitten. Ein herausragendes Merkmal ist ihre doppelte Funktionalität: „Jedes Modell kann direkt antworten (Standard-LLM) oder vor der Antwort selbst reflektieren (wie Denkmodelle).“ Dies spiegelt Fähigkeiten wider, die in Modellen wie Claude 3.5 zu sehen sind. Deep Cogito erwähnt jedoch, dass sie sich nicht auf sehr lange Denkketten konzentriert haben, sondern schnelle Antworten und die Effizienz der Destillation kürzerer Ketten priorisieren.
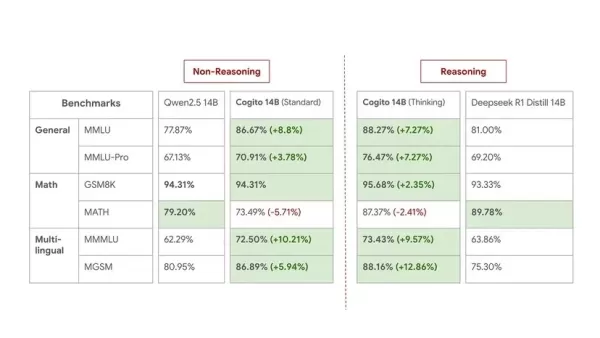
Das Unternehmen hat umfassende Benchmark-Ergebnisse geteilt, in denen ihre Cogito-Modelle mit gleich großen, modernen offenen Modellen sowohl im direkten als auch im Denkmodus verglichen werden. Über eine Reihe von Benchmarks wie MMLU, MMLU-Pro, ARC, GSM8K und MATH und über verschiedene Modellgrößen (3B, 8B, 14B, 32B, 70B) zeigen die Cogito-Modelle allgemein signifikante Leistungsverbesserungen. Zum Beispiel erzielt das Cogito 70B-Modell im Standardmodus 91,73 % bei MMLU, eine Verbesserung von +6,40 % gegenüber Llama 3.3 70B, und 91,00 % im Denkmodus, eine Steigerung von +4,40 % gegenüber Deepseek R1 Distill 70B. Livebench-Werte spiegeln diese Gewinne ebenfalls wider.
Hier sind Benchmarks von 14B-Modellen für einen Vergleich mittlerer Größe:
Während Deep Cogito anerkennt, dass Benchmarks nicht die volle praktische Nützlichkeit erfassen, bleiben sie zuversichtlich in die praktische Leistung ihrer Modelle. Diese Veröffentlichung gilt als Vorschau, wobei das Unternehmen angibt, dass sie „noch in den frühen Stadien dieser Skalierungskurve“ stehen. Sie planen, verbesserte Checkpoints für die aktuellen Größen zu veröffentlichen und in den kommenden Wochen und Monaten größere MoE-Modelle (109B, 400B, 671B) einzuführen. Alle zukünftigen Modelle werden ebenfalls Open-Source sein.
Verwandter Artikel
 Warner Music übernimmt das KI-Zuschreibungsstart-up Sureel AI
Warner Music Group (WMG) hat am Mittwoch bestätigt, dass es Sureel AI, ein Startup für KI-gestützte Attribution, übernimmt. Die proprietäre Technologie von Sureel generiert „AI-DNA“ für Musikstücke, indem sie diese in ihre Bestandteile zerlegt, um na
Amazon führt Alexa für den Einkauf ein und schiebt Rufus in den Hintergrund
Amazon hat Alexa for Shopping eingeführt, indem es den Rufus-Shopping-Chatbot mit Alexa+ in der App, auf der Website und auf Echo Show-Geräten zusammenführt.Der Assistent beantwortet Produktanfragen, vergleicht Artikel, verfolgt Preise und unterstüt
Microsoft, Azure und KI-Technologie bekämpfen die Risiken von Waldbränden in Kalifornien
Microsoft investiert in die KI-gestützte Erkennung von Waldbränden. Juan Lavista Ferres, CVP und Chief Data Scientist, erörtert Strategien zur Eindämmung von Umweltschäden.Laut der NASA betrifft der K
Empfehlungen zu verwandten Spezialthemen
Chatbot
 Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
 10 Tools
 xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

 Kommentare (29)
![FrankMoore]()
看起来这家叫做Deep Cogito的新公司有点门道。IDA架构?之前没听说过这个技术,好奇跟MoE比怎么样。要是能出个小点的模型让大家体验一下就好了,毕竟现在动辄几十B参数量,普通开发者根本玩不起。希望别只是实验室数据漂亮,实际应用打折扣。
![HenryJackson]()
このモデルの性能、ほかの同サイズのモデルより優れてるの?IDAの手法が効いてるのかな。個人的には倫理的な側面も気になるけど、オープンソースなのはすごく良いと思う👍 実際に使ってみたい!
![RoyWhite]()
Deep Cogito's LLMs sound like a game-changer! Outperforming models of similar size with IDA is no small feat. Curious to see how these stack up in real-world tasks. 🚀
![PaulThomas]()
Super cool to see Deep Cogito pushing the boundaries with their LLMs! 😎 Those parameter sizes are wild—wonder how they stack up in real-world tasks?
![GregoryCarter]()
LLM от Deep Cogito впечатляют, но приложение могло бы иметь лучший UI. Навигация по разным размерам моделей немного неуклюжая. Тем не менее, производительность на высшем уровне, особенно с технологией IDA. Обязательно стоит посмотреть, если вы интересуетесь ИИ и хотите увидеть, что возможно с большими языковыми моделями! 🤖💡
![EricRoberts]()
ディープコギトのLLMは印象的ですが、アプリのUIがもう少し改善されると良いですね。モデルサイズをナビゲートするのが少しぎこちないです。それでも、パフォーマンスは最高で、特にIDAテクノロジーとの組み合わせが素晴らしいです。AIに興味があるなら、大規模言語モデルの可能性を見る価値がありますよ!🤖💡
Deep Cogito, ein in San Francisco ansässiges Unternehmen, sorgt in der AI-Community für Aufsehen mit seiner neuesten Veröffentlichung von offenen großen Sprachmodellen (LLMs). Diese Modelle, die in verschiedenen Größen von 3 Milliarden bis 70 Milliarden Parametern reichen, sind nicht nur ein weiterer Satz von AI-Tools; sie sind ein mutiger Schritt hin zu dem, was das Unternehmen „allgemeine Superintelligenz“ nennt. Deep Cogito behauptet, dass jedes ihrer Modelle die führenden offenen Modelle ähnlicher Größe, einschließlich derer von LLAMA, DeepSeek und Qwen, in den meisten Standard-Benchmarks übertrifft. Das ist eine beachtliche Behauptung, aber noch beeindruckender ist, dass ihr 70B-Modell Berichten zufolge das kürzlich veröffentlichte Llama 4 109B Mixture-of-Experts (MoE)-Modell übertrumpft hat.
Iterierte Destillation und Amplifikation (IDA)
Das Herzstück des Durchbruchs von Deep Cogito ist ein neuer Trainingsansatz, den sie Iterierte Destillation und Amplifikation (IDA) nennen. Diese Methode wird als „skalierbare und effiziente Ausrichtungsstrategie für allgemeine Superintelligenz durch iterative Selbstverbesserung“ beschrieben. Sie ist darauf ausgelegt, die Grenzen des traditionellen LLM-Trainings zu überwinden, bei dem die Intelligenz des Modells oft an eine Obergrenze stößt, die durch größere „Überwacher“-Modelle oder menschliche Kuratoren definiert ist.
Der IDA-Prozess dreht sich um zwei wesentliche Schritte, die immer wieder wiederholt werden:
- Amplifikation: Dieser Schritt nutzt mehr Rechenleistung, um dem Modell zu helfen, bessere Lösungen oder Fähigkeiten zu entwickeln, ähnlich wie fortschrittliche Denktechniken.
- Destillation: Hier verinnerlicht das Modell diese verbesserten Fähigkeiten und verfeinert seine Parameter.
Deep Cogito argumentiert, dass dies eine „positive Rückkopplungsschleife“ schafft, die es der Intelligenz des Modells ermöglicht, direkter mit den Rechenressourcen und der Effizienz des IDA-Prozesses selbst zu wachsen, anstatt durch die Intelligenz eines Überwachers begrenzt zu sein.
Das Unternehmen verweist auf historische Erfolge wie AlphaGo und betont, dass „fortschrittliches Denken und iterative Selbstverbesserung“ entscheidend waren. IDA, so behaupten sie, bringt diese Elemente in das LLM-Training. Sie preisen auch die Effizienz von IDA und stellen fest, dass ihr kleines Team es geschafft hat, diese Modelle in nur etwa 75 Tagen zu entwickeln. Im Vergleich zu anderen Methoden wie Reinforcement Learning from Human Feedback (RLHF) oder Standard-Destillation von größeren Modellen soll IDA eine bessere Skalierbarkeit bieten.
Als Beweis hebt Deep Cogito hervor, wie ihr 70B-Modell sowohl Llama 3.3 70B (destilliert aus einem 405B-Modell) als auch Llama 4 Scout 109B (destilliert aus einem 2T-Parameter-Modell) übertrifft.
Fähigkeiten und Leistung der Deep Cogito-Modelle
Die neuen Cogito-Modelle, die auf Llama- und Qwen-Checkpoints aufbauen, sind auf Codierung, Funktionsaufrufe und agentische Anwendungen zugeschnitten. Ein herausragendes Merkmal ist ihre doppelte Funktionalität: „Jedes Modell kann direkt antworten (Standard-LLM) oder vor der Antwort selbst reflektieren (wie Denkmodelle).“ Dies spiegelt Fähigkeiten wider, die in Modellen wie Claude 3.5 zu sehen sind. Deep Cogito erwähnt jedoch, dass sie sich nicht auf sehr lange Denkketten konzentriert haben, sondern schnelle Antworten und die Effizienz der Destillation kürzerer Ketten priorisieren.
Das Unternehmen hat umfassende Benchmark-Ergebnisse geteilt, in denen ihre Cogito-Modelle mit gleich großen, modernen offenen Modellen sowohl im direkten als auch im Denkmodus verglichen werden. Über eine Reihe von Benchmarks wie MMLU, MMLU-Pro, ARC, GSM8K und MATH und über verschiedene Modellgrößen (3B, 8B, 14B, 32B, 70B) zeigen die Cogito-Modelle allgemein signifikante Leistungsverbesserungen. Zum Beispiel erzielt das Cogito 70B-Modell im Standardmodus 91,73 % bei MMLU, eine Verbesserung von +6,40 % gegenüber Llama 3.3 70B, und 91,00 % im Denkmodus, eine Steigerung von +4,40 % gegenüber Deepseek R1 Distill 70B. Livebench-Werte spiegeln diese Gewinne ebenfalls wider.
Hier sind Benchmarks von 14B-Modellen für einen Vergleich mittlerer Größe:
Während Deep Cogito anerkennt, dass Benchmarks nicht die volle praktische Nützlichkeit erfassen, bleiben sie zuversichtlich in die praktische Leistung ihrer Modelle. Diese Veröffentlichung gilt als Vorschau, wobei das Unternehmen angibt, dass sie „noch in den frühen Stadien dieser Skalierungskurve“ stehen. Sie planen, verbesserte Checkpoints für die aktuellen Größen zu veröffentlichen und in den kommenden Wochen und Monaten größere MoE-Modelle (109B, 400B, 671B) einzuführen. Alle zukünftigen Modelle werden ebenfalls Open-Source sein.








 Warner Music übernimmt das KI-Zuschreibungsstart-up Sureel AI
Warner Music Group (WMG) hat am Mittwoch bestätigt, dass es Sureel AI, ein Startup für KI-gestützte Attribution, übernimmt. Die proprietäre Technologie von Sureel generiert „AI-DNA“ für Musikstücke, indem sie diese in ihre Bestandteile zerlegt, um na
Amazon führt Alexa für den Einkauf ein und schiebt Rufus in den Hintergrund
Amazon hat Alexa for Shopping eingeführt, indem es den Rufus-Shopping-Chatbot mit Alexa+ in der App, auf der Website und auf Echo Show-Geräten zusammenführt.Der Assistent beantwortet Produktanfragen, vergleicht Artikel, verfolgt Preise und unterstüt
 Microsoft, Azure und KI-Technologie bekämpfen die Risiken von Waldbränden in Kalifornien
Microsoft investiert in die KI-gestützte Erkennung von Waldbränden. Juan Lavista Ferres, CVP und Chief Data Scientist, erörtert Strategien zur Eindämmung von Umweltschäden.Laut der NASA betrifft der K

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

看起来这家叫做Deep Cogito的新公司有点门道。IDA架构?之前没听说过这个技术,好奇跟MoE比怎么样。要是能出个小点的模型让大家体验一下就好了,毕竟现在动辄几十B参数量,普通开发者根本玩不起。希望别只是实验室数据漂亮,实际应用打折扣。
このモデルの性能、ほかの同サイズのモデルより優れてるの?IDAの手法が効いてるのかな。個人的には倫理的な側面も気になるけど、オープンソースなのはすごく良いと思う👍 実際に使ってみたい!
Deep Cogito's LLMs sound like a game-changer! Outperforming models of similar size with IDA is no small feat. Curious to see how these stack up in real-world tasks. 🚀
Super cool to see Deep Cogito pushing the boundaries with their LLMs! 😎 Those parameter sizes are wild—wonder how they stack up in real-world tasks?
LLM от Deep Cogito впечатляют, но приложение могло бы иметь лучший UI. Навигация по разным размерам моделей немного неуклюжая. Тем не менее, производительность на высшем уровне, особенно с технологией IDA. Обязательно стоит посмотреть, если вы интересуетесь ИИ и хотите увидеть, что возможно с большими языковыми моделями! 🤖💡
ディープコギトのLLMは印象的ですが、アプリのUIがもう少し改善されると良いですね。モデルサイズをナビゲートするのが少しぎこちないです。それでも、パフォーマンスは最高で、特にIDAテクノロジーとの組み合わせが素晴らしいです。AIに興味があるなら、大規模言語モデルの可能性を見る価値がありますよ!🤖💡












