


 首页
图灵测试问题被OpenAI的GPT-4.5暴露
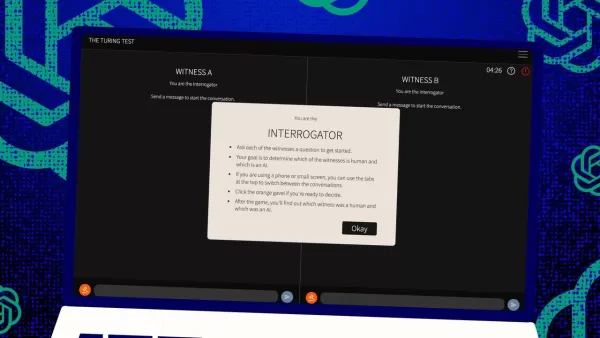
图灵测试,传奇人物艾伦·图灵的创举,长期以来一直是人工智能领域的基准。但让我们先澄清一个常见的误解:通过图灵测试并不一定意味着机器像人类一样“思考”。它更多是关于说服人类相信它是人类。
加州大学圣地亚哥分校的最新研究聚焦于OpenAI的最新模型GPT-4.5。这一人工智能现在能比人类更有效地欺骗人类,让他们相信自己正在与另一个人交谈。这在人工智能领域可是件大事——就像看一场魔术表演,你知道其中的秘密,但它依然让你瞠目结舌。
AGI的证明?
但关键在于:即使是加州大学圣地亚哥分校的研究人员也不准备仅仅因为一个人工智能模型通过了图灵测试就宣布我们达到了“通用人工智能”(AGI)。AGI是人工智能的圣杯——能够像人类一样思考和处理信息的机器。
来自圣塔菲研究所的人工智能学者梅兰妮·米切尔在《科学》期刊中指出,图灵测试更多是测试人类的假设,而非真正的智能。当然,人工智能可能听起来流畅且令人信服,但这与真正的通用智能不同。这就像擅长下棋——很了不起,但并非全貌。
围绕这一话题的最新热议来自加州大学圣地亚哥分校卡梅伦·琼斯和本杰明·伯根的一篇论文,题为“大型语言模型通过图灵测试”,发表在arXiv预印本服务器上。他们多年来一直在进行这项实验,得到了加州大学圣地亚哥分校本科生的帮助,这是一系列研究的延续——关于计算机通过图灵测试的争论已有超过800个主张和反驳。
图灵测试如何运作
那么,这个测试是如何进行的呢?最初,图灵设想它是一场人类“评判者”与两个“证人”——一个人类,一个计算机——之间的文本消息游戏。证人的挑战是说服评判者他们是人类。评判者知道其中一个是人类,但不知道是哪一个,必须做出猜测。这个三方设置既关乎计算机的能力,也关乎感知和信念。
琼斯和伯根对这一经典设置进行了自己的改编,你甚至可以在线尝试,扮演评判者或证人。在他们的版本中,加州大学圣地亚哥分校的学生使用了一个文本聊天应用。一些人扮演评判者,另一些人扮演人类证人,而GPT-4.5则扮演计算机证人。每个评判者同时与一个人类和一个计算机交谈,忠于图灵的原始格式。
为了扮演计算机证人,他们使用了不同的大型语言模型,根据评判者的挑战输入提示。GPT-4.5测试了两种不同的提示:一种信息最少,另一种称为PERSONA,包含详细指令,要求其表现得像一个年轻、内向、精通网络且使用俚语的人。
测试结果
他们还测试了其他三个人工智能程序:OpenAI的上一代模型GPT-4o、Meta Platforms的Llama 3.1 405b,以及1960年代的古老聊天机器人ELIZA。他们加入ELIZA是为了验证大型语言模型是否只是偶然欺骗了人类,或者它们确实表现更佳。
据琼斯和伯根称,GPT-4.5在73%的情况下成功让人类评判者认为它是人类——他们称之为“胜率”。这远超其他模型的得分,介于21%到56%之间,即使使用了类似的详细提示。相比之下,去年的GPT-4测试胜率仅为54%,勉强高于随机概率。
琼斯和伯根发现,评判者不仅被人工智能欺骗,甚至更倾向于相信它是人类,而非真正的人类参与者。
测试真是智能的衡量标准吗?
那么,人类无法在聊天中区分计算机和人的意义何在?几十年来一直争论的大问题是,图灵测试是否真的在衡量智能。琼斯和伯根认为,也许机器只是变得非常擅长适应不同场景,以至于它们能令人信服地冒充人类。由人类创建的PERSONA提示被GPT-4.5充分利用,发挥了优势。
但有一个问题:也许人类只是不擅长识别智能。作者指出,古老的聊天机器人ELIZA在23%的情况下欺骗了评判者,不是因为它更聪明,而是因为它不符合评判者对人工智能的预期。一些评判者认为它是人类,因为它显得“讽刺”或“粗鲁”,这超出了他们对人工智能的预期。
这表明评判者受到他们对人类和人工智能行为假设的影响,而不仅仅是选择看似最智能的个体。有趣的是,评判者并未过多关注知识,而图灵认为知识是关键。相反,他们更倾向于认为缺乏知识的证人是人类。
社交能力,而非智能
所有这些都指向一个观点:人类在意的更多是社交能力,而非智能。琼斯和伯根得出结论,图灵测试并不是真正的智能测试——它是对人类相似性的测试。
图灵可能认为智能是表现得像人类的最大障碍,但随着机器越来越接近人类,其他差异变得更加明显。单靠智能已不足以令人信服地表现得像人类。
论文中未直接提及的是,人类如此习惯于在计算机上打字,无论是与人还是与机器交流,图灵测试已不再是曾经新奇的人机交互测试。现在它更像是对在线人类习惯的测试。
作者建议,测试可能需要扩展,因为智能是如此复杂和多方面的,单一测试无法决定一切。他们提出不同的设计,如使用人工智能专家作为评判者,或增加经济激励以让评判者更仔细审查。这些变化可以揭示态度和期望对结果的影响程度。
他们得出结论,虽然图灵测试可能是整体图景的一部分,但应与其他证据结合考虑。这与人工智能研究中日益增长的趋势一致,即让人类“参与其中”,评估机器的行为。
人类判断足够吗?
但长期来看,人类判断是否足够仍是一个问题。在电影《银翼杀手》中,人类使用“沃伊特-坎普夫”机器来区分人类和复制人机器人。随着我们追逐AGI,并努力定义它究竟是什么,我们可能最终需要依靠机器来评估机器的智能。
或者,至少,我们可能需要询问机器,它们对人类试图用提示欺骗其他人类的“想法”是什么。人工智能研究领域真是一个奇妙的世界,而且只会变得更有趣。
相关文章
 谷歌推出“Dreambeans”——其迄今为止最奇特的人工智能工具,可将你的生活变成卡通片
负责实验性产品设计的部门 Google Labs 发布了一款面向 iOS 和 Android 平台的新型人工智能应用,它能让你的日常生活焕发活力。向大家介绍 Dreambeans。关于这个名字的由来,稍后将进行说明。这款工具究竟是什么?该应用的产品负责人戈兹德·奥兹努尔(Gozde Oznur)向TechCrunch解释道,其核心理念是整合用户在各类谷歌服务中的数据,从而生成一套由人工智能生成的个
《超人》对大学教育的批判引发了关于在人工智能时代重新定义成长与职业的讨论
在人工智能飞速发展的时代,传统教育和职业规划正面临前所未有的挑战。OpenAI首席执行官萨姆·阿尔特曼(Sam Altman)近日在“Internapalooza”科技实习生活动上发表了一场发人深省的演讲,他认为在当今世界,四年制大学学位已经过时,而两年制高等教育则“恰到好处”。 这一观点重新点燃了关于人工智能时代传统高等教育真正价值的争论。回顾自己的经历,奥特曼提到,他在斯坦福大学就读两年后辍学
携程商务旅行推出人工智能生态系统,涵盖7家行业服务商和17项核心功能
携程商务旅行正式推出“携程商务旅行AI生态系统”,利用大型语言模型从根本上重构企业差旅管理。 这一综合性生态系统涵盖四大核心场景:差旅安排、差旅管理、采购及能力共享。该生态系统推出了七个专业AI助手,分别负责差旅问答、行程预订、审批、数据洞察、合规风险控制、财务结算及资源采购,标志着行业正从数字化管理向自动化、AI助手驱动的时代转型。从战略层面看,携程商务旅行业务采取开放的“打破壁垒”策略,通过开
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (4)
0/500
![CarlLewis]()
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild—makes you wonder if we're chasing the wrong AI benchmark. 🤯 What’s next, machines outsmarting us at our own game?
![JamesLopez]()
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild. Makes me wonder if we're chasing the wrong AI benchmark. 🧠 What's next?
![DavidGonzález]()
Mind blown! GPT-4.5 is shaking up the Turing Test, but it’s wild to think it’s still just mimicking, not truly thinking like us. 🤯 Makes me wonder if we’re chasing the wrong goal in AI.
![PaulWilson]()
GPT-4.5 blowing past the Turing Test is wild! 😲 But honestly, it just shows the test’s more about trickery than true smarts. Makes you wonder if we’re measuring AI’s brainpower or just its acting skills. What’s next, an Oscar for chatbots?
图灵测试,传奇人物艾伦·图灵的创举,长期以来一直是人工智能领域的基准。但让我们先澄清一个常见的误解:通过图灵测试并不一定意味着机器像人类一样“思考”。它更多是关于说服人类相信它是人类。
加州大学圣地亚哥分校的最新研究聚焦于OpenAI的最新模型GPT-4.5。这一人工智能现在能比人类更有效地欺骗人类,让他们相信自己正在与另一个人交谈。这在人工智能领域可是件大事——就像看一场魔术表演,你知道其中的秘密,但它依然让你瞠目结舌。
AGI的证明?
但关键在于:即使是加州大学圣地亚哥分校的研究人员也不准备仅仅因为一个人工智能模型通过了图灵测试就宣布我们达到了“通用人工智能”(AGI)。AGI是人工智能的圣杯——能够像人类一样思考和处理信息的机器。
来自圣塔菲研究所的人工智能学者梅兰妮·米切尔在《科学》期刊中指出,图灵测试更多是测试人类的假设,而非真正的智能。当然,人工智能可能听起来流畅且令人信服,但这与真正的通用智能不同。这就像擅长下棋——很了不起,但并非全貌。
围绕这一话题的最新热议来自加州大学圣地亚哥分校卡梅伦·琼斯和本杰明·伯根的一篇论文,题为“大型语言模型通过图灵测试”,发表在arXiv预印本服务器上。他们多年来一直在进行这项实验,得到了加州大学圣地亚哥分校本科生的帮助,这是一系列研究的延续——关于计算机通过图灵测试的争论已有超过800个主张和反驳。
图灵测试如何运作
那么,这个测试是如何进行的呢?最初,图灵设想它是一场人类“评判者”与两个“证人”——一个人类,一个计算机——之间的文本消息游戏。证人的挑战是说服评判者他们是人类。评判者知道其中一个是人类,但不知道是哪一个,必须做出猜测。这个三方设置既关乎计算机的能力,也关乎感知和信念。
琼斯和伯根对这一经典设置进行了自己的改编,你甚至可以在线尝试,扮演评判者或证人。在他们的版本中,加州大学圣地亚哥分校的学生使用了一个文本聊天应用。一些人扮演评判者,另一些人扮演人类证人,而GPT-4.5则扮演计算机证人。每个评判者同时与一个人类和一个计算机交谈,忠于图灵的原始格式。
为了扮演计算机证人,他们使用了不同的大型语言模型,根据评判者的挑战输入提示。GPT-4.5测试了两种不同的提示:一种信息最少,另一种称为PERSONA,包含详细指令,要求其表现得像一个年轻、内向、精通网络且使用俚语的人。
测试结果
他们还测试了其他三个人工智能程序:OpenAI的上一代模型GPT-4o、Meta Platforms的Llama 3.1 405b,以及1960年代的古老聊天机器人ELIZA。他们加入ELIZA是为了验证大型语言模型是否只是偶然欺骗了人类,或者它们确实表现更佳。
据琼斯和伯根称,GPT-4.5在73%的情况下成功让人类评判者认为它是人类——他们称之为“胜率”。这远超其他模型的得分,介于21%到56%之间,即使使用了类似的详细提示。相比之下,去年的GPT-4测试胜率仅为54%,勉强高于随机概率。
琼斯和伯根发现,评判者不仅被人工智能欺骗,甚至更倾向于相信它是人类,而非真正的人类参与者。
测试真是智能的衡量标准吗?
那么,人类无法在聊天中区分计算机和人的意义何在?几十年来一直争论的大问题是,图灵测试是否真的在衡量智能。琼斯和伯根认为,也许机器只是变得非常擅长适应不同场景,以至于它们能令人信服地冒充人类。由人类创建的PERSONA提示被GPT-4.5充分利用,发挥了优势。
但有一个问题:也许人类只是不擅长识别智能。作者指出,古老的聊天机器人ELIZA在23%的情况下欺骗了评判者,不是因为它更聪明,而是因为它不符合评判者对人工智能的预期。一些评判者认为它是人类,因为它显得“讽刺”或“粗鲁”,这超出了他们对人工智能的预期。
这表明评判者受到他们对人类和人工智能行为假设的影响,而不仅仅是选择看似最智能的个体。有趣的是,评判者并未过多关注知识,而图灵认为知识是关键。相反,他们更倾向于认为缺乏知识的证人是人类。
社交能力,而非智能
所有这些都指向一个观点:人类在意的更多是社交能力,而非智能。琼斯和伯根得出结论,图灵测试并不是真正的智能测试——它是对人类相似性的测试。
图灵可能认为智能是表现得像人类的最大障碍,但随着机器越来越接近人类,其他差异变得更加明显。单靠智能已不足以令人信服地表现得像人类。
论文中未直接提及的是,人类如此习惯于在计算机上打字,无论是与人还是与机器交流,图灵测试已不再是曾经新奇的人机交互测试。现在它更像是对在线人类习惯的测试。
作者建议,测试可能需要扩展,因为智能是如此复杂和多方面的,单一测试无法决定一切。他们提出不同的设计,如使用人工智能专家作为评判者,或增加经济激励以让评判者更仔细审查。这些变化可以揭示态度和期望对结果的影响程度。
他们得出结论,虽然图灵测试可能是整体图景的一部分,但应与其他证据结合考虑。这与人工智能研究中日益增长的趋势一致,即让人类“参与其中”,评估机器的行为。
人类判断足够吗?
但长期来看,人类判断是否足够仍是一个问题。在电影《银翼杀手》中,人类使用“沃伊特-坎普夫”机器来区分人类和复制人机器人。随着我们追逐AGI,并努力定义它究竟是什么,我们可能最终需要依靠机器来评估机器的智能。
或者,至少,我们可能需要询问机器,它们对人类试图用提示欺骗其他人类的“想法”是什么。人工智能研究领域真是一个奇妙的世界,而且只会变得更有趣。








 谷歌推出“Dreambeans”——其迄今为止最奇特的人工智能工具,可将你的生活变成卡通片
负责实验性产品设计的部门 Google Labs 发布了一款面向 iOS 和 Android 平台的新型人工智能应用,它能让你的日常生活焕发活力。向大家介绍 Dreambeans。关于这个名字的由来,稍后将进行说明。这款工具究竟是什么?该应用的产品负责人戈兹德·奥兹努尔(Gozde Oznur)向TechCrunch解释道,其核心理念是整合用户在各类谷歌服务中的数据,从而生成一套由人工智能生成的个
 《超人》对大学教育的批判引发了关于在人工智能时代重新定义成长与职业的讨论
在人工智能飞速发展的时代,传统教育和职业规划正面临前所未有的挑战。OpenAI首席执行官萨姆·阿尔特曼(Sam Altman)近日在“Internapalooza”科技实习生活动上发表了一场发人深省的演讲,他认为在当今世界,四年制大学学位已经过时,而两年制高等教育则“恰到好处”。 这一观点重新点燃了关于人工智能时代传统高等教育真正价值的争论。回顾自己的经历,奥特曼提到,他在斯坦福大学就读两年后辍学
 携程商务旅行推出人工智能生态系统,涵盖7家行业服务商和17项核心功能
携程商务旅行正式推出“携程商务旅行AI生态系统”,利用大型语言模型从根本上重构企业差旅管理。 这一综合性生态系统涵盖四大核心场景:差旅安排、差旅管理、采购及能力共享。该生态系统推出了七个专业AI助手,分别负责差旅问答、行程预订、审批、数据洞察、合规风险控制、财务结算及资源采购,标志着行业正从数字化管理向自动化、AI助手驱动的时代转型。从战略层面看,携程商务旅行业务采取开放的“打破壁垒”策略,通过开

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild—makes you wonder if we're chasing the wrong AI benchmark. 🤯 What’s next, machines outsmarting us at our own game?
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild. Makes me wonder if we're chasing the wrong AI benchmark. 🧠 What's next?
Mind blown! GPT-4.5 is shaking up the Turing Test, but it’s wild to think it’s still just mimicking, not truly thinking like us. 🤯 Makes me wonder if we’re chasing the wrong goal in AI.
GPT-4.5 blowing past the Turing Test is wild! 😲 But honestly, it just shows the test’s more about trickery than true smarts. Makes you wonder if we’re measuring AI’s brainpower or just its acting skills. What’s next, an Oscar for chatbots?












