


 首頁
圖靈測試問題被OpenAI的GPT-4.5暴露
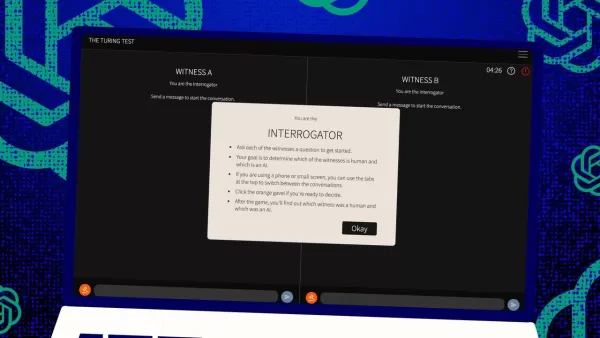
圖靈測試,傳奇人物艾倫·圖靈的創意結晶,長期以來一直是人工智慧領域的基準。但讓我們先澄清一個常見的誤解:通過圖靈測試並不一定意味著機器能像人類一樣「思考」。它更多是關於說服人類相信它是人類。
加州大學聖地牙哥分校的最新研究將焦點投向了OpenAI的最新模型GPT-4.5。這款AI現在能比人類更有效地騙過人類,讓人相信他們在與另一個人聊天。這在AI界可是件大事——就像看一場魔術表演,你知道背後的秘密,但仍然感到震驚。
人工通用智慧的證明?
但關鍵在於:即使是加州大學聖地牙哥分校的研究人員也不願僅因AI模型通過圖靈測試就宣稱我們已實現「人工通用智慧」(AGI)。AGI是AI的聖杯——能像人類一樣思考和處理資訊的機器。
來自聖塔菲研究所的AI學者梅蘭妮·米契爾在《科學》期刊中指出,圖靈測試更多是測試人類的假設,而非真正的智慧。當然,AI可能聽起來流暢且令人信服,但這與真正的通用智慧不同。這就像擅長下棋——令人印象深刻,但並非全貌。
這股熱潮源自加州大學聖地牙哥分校的卡梅倫·瓊斯和本傑明·伯根發表在arXiv預印伺服器上的論文,標題為「大型語言模型通過圖靈測試」。他們多年來在加州大學聖地牙哥分校本科生的協助下進行這項實驗,這是超過800項關於電腦通過圖靈測試的聲明與反駁的一部分。
圖靈測試如何運作
那麼,這項測試是如何進行的?最初,圖靈設想它是一個由人類「評審」與兩個「證人」(一個是人類,一個是電腦)通過文字訊息進行的遊戲。證人的挑戰是說服評審他們是人類。評審知道其中一個是人類,但不知道是哪個,必須做出猜測。這是一個三方設置,既關乎電腦的能力,也關乎感知與信念。
瓊斯和伯根對這一經典設置進行了改進,你甚至可以在線上試玩,扮演評審或證人。在他們的版本中,加州大學聖地牙哥分校的學生使用文字聊天應用程式。有些人扮演評審,其他人扮演人類證人,而GPT-4.5則扮演電腦證人。每位評審同時與人類和電腦聊天,忠於圖靈的原始格式。
為了扮演電腦證人,他們使用了不同的大型語言模型,根據評審的挑戰提供提示。GPT-4.5接受了兩種不同的提示測試:一種提供最少資訊,另一種名為PERSONA,包含詳細指令,要求其表現得像一個年輕、內向、熟悉網路並使用俚語的人。
測試結果
他們還測試了三個其他AI程式:OpenAI的先前模型GPT-4o、Meta Platforms的Llama 3.1 405b,以及1960年代的古老聊天機器人ELIZA。他們納入ELIZA是為了檢驗大型語言模型是否只是偶然欺騙人類,或者它們確實更出色。
根據瓊斯和伯根的說法,GPT-4.5在73%的情況下成功讓人類評審相信它是人類——他們稱之為「勝率」。這比其他模型(得分在21%至56%之間,即使使用類似的詳細提示)表現好得多。與去年的GPT-4測試相比,這是一個巨大的進步,當時的勝率僅為54%,勉強高於隨機猜測。
瓊斯和伯根發現,評審不僅被AI欺騙,甚至更可能相信AI是人類,而不是真正的人類參與者。
這項測試真的是智慧的衡量標準嗎?
那麼,人類無法在聊天中分辨電腦與人的意義何在?數十年來一直爭論的大問題是,圖靈測試是否真正衡量智慧。瓊斯和伯根認為,或許機器只是變得非常擅長適應不同情境,以致能令人信服地冒充人類。由人類創建的PERSONA提示被GPT-4.5充分利用,成為其優勢。
但問題在於:也許人類只是不擅長辨識智慧。作者指出,古老的聊天機器人ELIZA在23%的情況下騙過評審,不是因為它更聰明,而是因為它不符合評審對AI的預期。有些評審認為它是人類,因為它顯得「諷刺」或「粗魯」,這是他們未預料的AI行為。
這表明評審受到對人類和AI行為的假設影響,而非僅選擇看似最聰明的對象。有趣的是,評審並未過多關注知識,而圖靈認為知識是關鍵。相反,如果證人似乎缺乏知識,他們更可能被認為是人類。
社交能力,而非智慧
這一切都指向一個觀點:人類更注重社交能力而非智慧。瓊斯和伯根得出結論,圖靈測試其實不是智慧的測試,而是人類相似度的測試。
圖靈可能認為智慧是表現得像人類的最大障礙,但隨著機器越來越接近人類,其他差異變得更顯著。僅靠智慧已不足以令人信服地像人類。
論文中未直接提到的是,人類如此習慣在電腦上打字,無論是與人還是機器互動,圖靈測試已不再是過去那種新奇的人機交互測試。它現在更像是對線上人類習慣的測試。
作者建議,鑑於智慧的複雜性和多面性,圖靈測試可能需要擴展,單一測試無法決定一切。他們提出不同的設計,例如使用AI專家作為評審,或加入經濟激勵讓評審更仔細審查。這些改變可能顯示出態度和期望對結果的影響有多大。
他們得出結論,圖靈測試可能只是整體的一部分,應與其他證據一同考慮。這與AI研究中越來越多的趨勢一致,即讓人類「參與其中」,評估機器的表現。
人類判斷足夠嗎?
但長期來看,人類判斷是否足夠仍是一個問題。在電影《銀翼殺手》中,人類使用「沃伊特-坎普夫」機器來區分人類與複製人機器人。隨著我們追求AGI,並努力定義它究竟是什麼,我們最終可能需要依靠機器來評估機器的智慧。
或者,至少,我們可能需要問機器它們對人類試圖用提示欺騙其他人類的「看法」。AI研究的世界充滿驚奇,且越來越有趣。
相關文章
 印度科技巨頭投資3000萬美元,打造微軟Office的AI競爭對手
連續創業者 Bhavin Turakhia 正投入 3000 萬美元自有資金,押注企業 AI 領域仍有新玩家的空間。他最新的創業專案 Neo 基於一個核心信念:傳統的職場軟體不能僅靠聊天機器人進行修補,而需要進行徹底的架構重構。46 歲的 Turakhia 有著支援雄心勃勃的企業科技專案的歷史。在過去二十年中,他聯合創立了 Directi、Radix、Titan 和 Zeta,在尋求外部投資之前,主要使用個人資本為這些專案提供資金。他正將同樣的自力更生策略應用於 Neo。Turakhia 向
前OpenAI首席科學家Ilya的SSI首次釋出模型
AI 取得了另一項重大里程碑。在從 OpenAI 離職後,前首席科學家伊利亞·蘇茨克弗(Ilya Sutskever)創立了 Safe Superintelligence Inc.(SSI),該公司最近公佈了其首個模型的詳細資訊。海外社交媒體上的報道指出,該團隊正在利用 TTT(測試時訓練)開發一個緊湊的推理引擎,這是他們在追求安全超級智慧過程中的關鍵進展。這種新穎的架構專注於使模型能夠“學習如何學習”。與在推理過程中保持引數靜態的傳統大型語言模型不同,該引擎在處理現實世界任務時會動態更新特定
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日,AI應用開發平臺Lovable宣佈參與丹麥硬體初創公司Atech的80萬美元種子輪融資。該輪由Lovable領投,吸引了包括a16z Scout Fund、Sequoia Scout Fund以及Nordic Makers在內的頂級風險投資機構。此次投資標誌著Lovable將“Vibe Coding”概念從純軟體開發戰略擴充套件至硬體工程領域。Atech旨在透過AI驅動的互動式平臺簡化複雜的硬體原型製作。使用者購買基礎硬體套件,並透過AI聊天機器人以自然語言描述其設計概念;系統
相關專題推薦
聊天機器人
 最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
 12 個工具
 xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai
會議助理
頂尖 AI 會議摘要工具:清晰追蹤決策與後續行動
2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
數據分析
最佳人工智慧資料清洗工具:快速處理缺失值與重複資料
2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai
設計與藝術
最佳AI創意構思工具,助力藝術家突破視覺瓶頸
2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

 評論 (4)
0/500
![CarlLewis]()
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild—makes you wonder if we're chasing the wrong AI benchmark. 🤯 What’s next, machines outsmarting us at our own game?
![JamesLopez]()
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild. Makes me wonder if we're chasing the wrong AI benchmark. 🧠 What's next?
![DavidGonzález]()
Mind blown! GPT-4.5 is shaking up the Turing Test, but it’s wild to think it’s still just mimicking, not truly thinking like us. 🤯 Makes me wonder if we’re chasing the wrong goal in AI.
![PaulWilson]()
GPT-4.5 blowing past the Turing Test is wild! 😲 But honestly, it just shows the test’s more about trickery than true smarts. Makes you wonder if we’re measuring AI’s brainpower or just its acting skills. What’s next, an Oscar for chatbots?
圖靈測試,傳奇人物艾倫·圖靈的創意結晶,長期以來一直是人工智慧領域的基準。但讓我們先澄清一個常見的誤解:通過圖靈測試並不一定意味著機器能像人類一樣「思考」。它更多是關於說服人類相信它是人類。
加州大學聖地牙哥分校的最新研究將焦點投向了OpenAI的最新模型GPT-4.5。這款AI現在能比人類更有效地騙過人類,讓人相信他們在與另一個人聊天。這在AI界可是件大事——就像看一場魔術表演,你知道背後的秘密,但仍然感到震驚。
人工通用智慧的證明?
但關鍵在於:即使是加州大學聖地牙哥分校的研究人員也不願僅因AI模型通過圖靈測試就宣稱我們已實現「人工通用智慧」(AGI)。AGI是AI的聖杯——能像人類一樣思考和處理資訊的機器。
來自聖塔菲研究所的AI學者梅蘭妮·米契爾在《科學》期刊中指出,圖靈測試更多是測試人類的假設,而非真正的智慧。當然,AI可能聽起來流暢且令人信服,但這與真正的通用智慧不同。這就像擅長下棋——令人印象深刻,但並非全貌。
這股熱潮源自加州大學聖地牙哥分校的卡梅倫·瓊斯和本傑明·伯根發表在arXiv預印伺服器上的論文,標題為「大型語言模型通過圖靈測試」。他們多年來在加州大學聖地牙哥分校本科生的協助下進行這項實驗,這是超過800項關於電腦通過圖靈測試的聲明與反駁的一部分。
圖靈測試如何運作
那麼,這項測試是如何進行的?最初,圖靈設想它是一個由人類「評審」與兩個「證人」(一個是人類,一個是電腦)通過文字訊息進行的遊戲。證人的挑戰是說服評審他們是人類。評審知道其中一個是人類,但不知道是哪個,必須做出猜測。這是一個三方設置,既關乎電腦的能力,也關乎感知與信念。
瓊斯和伯根對這一經典設置進行了改進,你甚至可以在線上試玩,扮演評審或證人。在他們的版本中,加州大學聖地牙哥分校的學生使用文字聊天應用程式。有些人扮演評審,其他人扮演人類證人,而GPT-4.5則扮演電腦證人。每位評審同時與人類和電腦聊天,忠於圖靈的原始格式。
為了扮演電腦證人,他們使用了不同的大型語言模型,根據評審的挑戰提供提示。GPT-4.5接受了兩種不同的提示測試:一種提供最少資訊,另一種名為PERSONA,包含詳細指令,要求其表現得像一個年輕、內向、熟悉網路並使用俚語的人。
測試結果
他們還測試了三個其他AI程式:OpenAI的先前模型GPT-4o、Meta Platforms的Llama 3.1 405b,以及1960年代的古老聊天機器人ELIZA。他們納入ELIZA是為了檢驗大型語言模型是否只是偶然欺騙人類,或者它們確實更出色。
根據瓊斯和伯根的說法,GPT-4.5在73%的情況下成功讓人類評審相信它是人類——他們稱之為「勝率」。這比其他模型(得分在21%至56%之間,即使使用類似的詳細提示)表現好得多。與去年的GPT-4測試相比,這是一個巨大的進步,當時的勝率僅為54%,勉強高於隨機猜測。
瓊斯和伯根發現,評審不僅被AI欺騙,甚至更可能相信AI是人類,而不是真正的人類參與者。
這項測試真的是智慧的衡量標準嗎?
那麼,人類無法在聊天中分辨電腦與人的意義何在?數十年來一直爭論的大問題是,圖靈測試是否真正衡量智慧。瓊斯和伯根認為,或許機器只是變得非常擅長適應不同情境,以致能令人信服地冒充人類。由人類創建的PERSONA提示被GPT-4.5充分利用,成為其優勢。
但問題在於:也許人類只是不擅長辨識智慧。作者指出,古老的聊天機器人ELIZA在23%的情況下騙過評審,不是因為它更聰明,而是因為它不符合評審對AI的預期。有些評審認為它是人類,因為它顯得「諷刺」或「粗魯」,這是他們未預料的AI行為。
這表明評審受到對人類和AI行為的假設影響,而非僅選擇看似最聰明的對象。有趣的是,評審並未過多關注知識,而圖靈認為知識是關鍵。相反,如果證人似乎缺乏知識,他們更可能被認為是人類。
社交能力,而非智慧
這一切都指向一個觀點:人類更注重社交能力而非智慧。瓊斯和伯根得出結論,圖靈測試其實不是智慧的測試,而是人類相似度的測試。
圖靈可能認為智慧是表現得像人類的最大障礙,但隨著機器越來越接近人類,其他差異變得更顯著。僅靠智慧已不足以令人信服地像人類。
論文中未直接提到的是,人類如此習慣在電腦上打字,無論是與人還是機器互動,圖靈測試已不再是過去那種新奇的人機交互測試。它現在更像是對線上人類習慣的測試。
作者建議,鑑於智慧的複雜性和多面性,圖靈測試可能需要擴展,單一測試無法決定一切。他們提出不同的設計,例如使用AI專家作為評審,或加入經濟激勵讓評審更仔細審查。這些改變可能顯示出態度和期望對結果的影響有多大。
他們得出結論,圖靈測試可能只是整體的一部分,應與其他證據一同考慮。這與AI研究中越來越多的趨勢一致,即讓人類「參與其中」,評估機器的表現。
人類判斷足夠嗎?
但長期來看,人類判斷是否足夠仍是一個問題。在電影《銀翼殺手》中,人類使用「沃伊特-坎普夫」機器來區分人類與複製人機器人。隨著我們追求AGI,並努力定義它究竟是什麼,我們最終可能需要依靠機器來評估機器的智慧。
或者,至少,我們可能需要問機器它們對人類試圖用提示欺騙其他人類的「看法」。AI研究的世界充滿驚奇,且越來越有趣。








 印度科技巨頭投資3000萬美元,打造微軟Office的AI競爭對手
連續創業者 Bhavin Turakhia 正投入 3000 萬美元自有資金,押注企業 AI 領域仍有新玩家的空間。他最新的創業專案 Neo 基於一個核心信念:傳統的職場軟體不能僅靠聊天機器人進行修補,而需要進行徹底的架構重構。46 歲的 Turakhia 有著支援雄心勃勃的企業科技專案的歷史。在過去二十年中,他聯合創立了 Directi、Radix、Titan 和 Zeta,在尋求外部投資之前,主要使用個人資本為這些專案提供資金。他正將同樣的自力更生策略應用於 Neo。Turakhia 向
 前OpenAI首席科學家Ilya的SSI首次釋出模型
AI 取得了另一項重大里程碑。在從 OpenAI 離職後,前首席科學家伊利亞·蘇茨克弗(Ilya Sutskever)創立了 Safe Superintelligence Inc.(SSI),該公司最近公佈了其首個模型的詳細資訊。海外社交媒體上的報道指出,該團隊正在利用 TTT(測試時訓練)開發一個緊湊的推理引擎,這是他們在追求安全超級智慧過程中的關鍵進展。這種新穎的架構專注於使模型能夠“學習如何學習”。與在推理過程中保持引數靜態的傳統大型語言模型不同,該引擎在處理現實世界任務時會動態更新特定
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日,AI應用開發平臺Lovable宣佈參與丹麥硬體初創公司Atech的80萬美元種子輪融資。該輪由Lovable領投,吸引了包括a16z Scout Fund、Sequoia Scout Fund以及Nordic Makers在內的頂級風險投資機構。此次投資標誌著Lovable將“Vibe Coding”概念從純軟體開發戰略擴充套件至硬體工程領域。Atech旨在透過AI驅動的互動式平臺簡化複雜的硬體原型製作。使用者購買基礎硬體套件,並透過AI聊天機器人以自然語言描述其設計概念;系統

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai

2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild—makes you wonder if we're chasing the wrong AI benchmark. 🤯 What’s next, machines outsmarting us at our own game?
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild. Makes me wonder if we're chasing the wrong AI benchmark. 🧠 What's next?
Mind blown! GPT-4.5 is shaking up the Turing Test, but it’s wild to think it’s still just mimicking, not truly thinking like us. 🤯 Makes me wonder if we’re chasing the wrong goal in AI.
GPT-4.5 blowing past the Turing Test is wild! 😲 But honestly, it just shows the test’s more about trickery than true smarts. Makes you wonder if we’re measuring AI’s brainpower or just its acting skills. What’s next, an Oscar for chatbots?












