


 Lar
Problema do Teste de Turing Exposto pelo GPT-4.5 da OpenAI
O Teste de Turing, uma criação do lendário Alan Turing, tem sido há muito tempo um marco no mundo da inteligência artificial. Mas vamos esclarecer um equívoco comum logo de início: passar no Teste de Turing não significa necessariamente que uma máquina está "pensando" como um humano. É mais sobre convencer humanos de que ela é.
Pesquisas recentes da Universidade da Califórnia em San Diego destacaram o mais recente modelo da OpenAI, o GPT-4.5. Essa IA agora pode enganar humanos fazendo-os acreditar que estão conversando com outra pessoa, de forma ainda mais eficaz do que humanos conseguem convencer uns aos outros de sua humanidade. Isso é algo bem significativo no mundo da IA — é como assistir a um truque de mágica onde você conhece o segredo, mas ainda assim fica impressionado.
Prova de AGI?
Mas aqui está o ponto crucial: mesmo os pesquisadores da UC San Diego não estão prontos para declarar que alcançamos a "inteligência geral artificial" (AGI) só porque um modelo de IA pode passar no Teste de Turing. AGI seria o santo graal da IA — máquinas que podem pensar e processar informações exatamente como humanos.
Melanie Mitchell, uma estudiosa de IA do Santa Fe Institute, argumenta na revista Science que o Teste de Turing é mais sobre testar suposições humanas do que inteligência real. Claro, uma IA pode soar fluente e convincente, mas isso não é o mesmo que ser geralmente inteligente. É como ser bom em xadrez — é impressionante, mas não é o quadro completo.
O mais recente burburinho sobre isso vem de um artigo de Cameron Jones e Benjamin Bergen na UC San Diego, intitulado "Modelos de Linguagem de Grande Escala Passam no Teste de Turing", publicado no servidor de pré-impressão arXiv. Eles têm conduzido esse experimento por anos, com a ajuda de estudantes de graduação da UC San Diego, e isso faz parte de uma longa linha de pesquisa — mais de 800 afirmações e contra-argumentos foram feitos sobre computadores passando no Teste de Turing.
Como Funciona o Teste de Turing
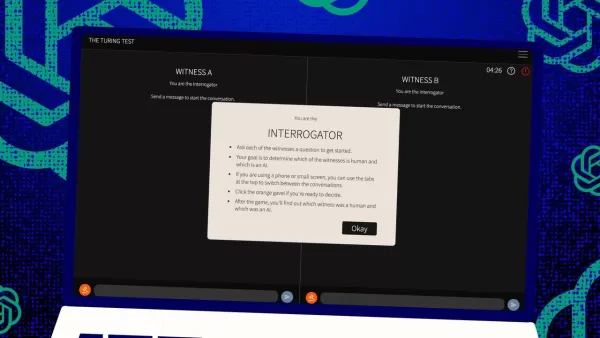
Então, como funciona esse teste? Originalmente, Turing imaginou-o como um jogo de mensagens de texto entre um "juiz" humano e dois "testemunhas" — um humano, um computador. O desafio para as testemunhas é convencer o juiz de que são humanas. O juiz sabe que uma é humana, mas não sabe qual, e precisa fazer um palpite. É uma configuração tripla que envolve tanto percepção e crença quanto as habilidades do computador.
Jones e Bergen deram seu próprio toque a essa configuração clássica, e você pode até experimentá-la online, jogando como juiz ou testemunha. Na versão deles, estudantes da UC San Diego usaram um aplicativo de chat de texto. Alguns foram juízes, outros testemunhas humanas, enquanto o GPT-4.5 assumiu o papel de testemunha computacional. Cada juiz conversou com um humano e um computador ao mesmo tempo, mantendo-se fiel ao formato original de Turing.
Para interpretar a testemunha computacional, eles usaram diferentes modelos de linguagem de grande escala, fornecendo-lhes prompts baseados nos desafios do juiz. O GPT-4.5 foi testado com dois prompts diferentes: um com informações mínimas e outro chamado PERSONA, que incluía instruções detalhadas para agir como uma pessoa jovem, introvertida e conhecedora da internet, que usa gírias.
Os Resultados
Eles também testaram outros três programas de IA: o modelo anterior da OpenAI, GPT-4o; o Llama 3.1 405b da Meta Platforms; e o chatbot dos anos 1960, ELIZA. Eles incluíram o ELIZA para verificar se os modelos de linguagem de grande escala estavam apenas enganando humanos por acaso ou se eram genuinamente melhores.
Segundo Jones e Bergen, o GPT-4.5 enganou juízes humanos, fazendo-os pensar que era humano em 73% das vezes — uma "taxa de vitória", como eles chamam. Isso é muito melhor do que os outros modelos, que marcaram entre 21% e 56%, mesmo com prompts detalhados semelhantes. E é um salto enorme em relação ao teste do ano passado com o GPT-4, que teve uma taxa de vitória de apenas 54%, mal acima do acaso.
Jones e Bergen descobriram que os juízes não apenas foram enganados pela IA, mas também eram mais propensos a acreditar que ela era humana do que os participantes humanos reais.
O Teste é Realmente uma Medida de Inteligência?
Então, o que significa que humanos não conseguem distinguir um computador de uma pessoa em um chat? A grande questão que tem sido debatida por décadas é se o Teste de Turing está realmente medindo inteligência. Jones e Bergen sugerem que talvez as máquinas tenham se tornado tão boas em se adaptar a diferentes cenários que podem passar convincentemente por humanas. O prompt PERSONA, criado por humanos, é algo que o GPT-4.5 adaptou e usou a seu favor.
Mas há um porém: talvez os humanos sejam apenas ruins em reconhecer inteligência. Os autores apontam que o ELIZA, o antigo chatbot, enganou juízes em 23% das vezes, não porque era mais inteligente, mas porque não atendia às expectativas deles sobre o que uma IA deveria ser. Alguns juízes pensaram que era humano porque era "sarcástico" ou "rude", o que eles não esperavam de uma IA.
Isso sugere que os juízes são influenciados por suas suposições sobre como humanos e IAs devem se comportar, em vez de apenas escolher o agente que parece mais inteligente. Curiosamente, os juízes não se concentraram muito no conhecimento, que Turing achava que seria fundamental. Em vez disso, eram mais propensos a pensar que uma testemunha era humana se parecesse ter falta de conhecimento.
Sociabilidade, Não Inteligência
Tudo isso aponta para a ideia de que os humanos estavam captando sociabilidade em vez de inteligência. Jones e Bergen concluem que o Teste de Turing não é realmente um teste de inteligência — é um teste de semelhança com humanos.
Turing pode ter pensado que a inteligência era o maior obstáculo para parecer humano, mas, à medida que as máquinas se aproximam de nós, outras diferenças se tornam mais evidentes. A inteligência por si só não é mais suficiente para parecer convincentemente humano.
O que não é dito diretamente no artigo é que os humanos estão tão acostumados a digitar em computadores, seja para uma pessoa ou uma máquina, que o Teste de Turing não é mais o teste inovador de interação humano-computador que já foi. Agora é mais um teste de hábitos humanos online.
Os autores sugerem que o teste pode precisar ser expandido porque a inteligência é tão complexa e multifacetada que nenhum teste único pode ser decisivo. Eles propõem diferentes designs, como usar especialistas em IA como juízes ou adicionar incentivos financeiros para fazer os juízes examinarem mais de perto. Essas mudanças poderiam mostrar o quanto atitude e expectativas influenciam os resultados.
Eles concluem que, embora o Teste de Turing possa fazer parte do quadro, ele deve ser considerado ao lado de outros tipos de evidências. Isso se alinha com uma tendência crescente na pesquisa de IA de envolver humanos "no ciclo", avaliando o que as máquinas fazem.
O Julgamento Humano é Suficiente?
Mas ainda há a questão de se o julgamento humano será suficiente a longo prazo. No filme Blade Runner, os humanos usam uma máquina, o "Voight-Kampff", para distinguir humanos de robôs replicantes. À medida que perseguimos o AGI, e lutamos para definir o que ele realmente é, podemos acabar dependendo de máquinas para avaliar a inteligência das máquinas.
Ou, no mínimo, podemos precisar perguntar às máquinas o que elas "pensam" sobre humanos tentando enganar outros humanos com prompts. É um mundo selvagem na pesquisa de IA, e está ficando cada vez mais interessante.
Artigo relacionado
 Stripe vai adquirir a OpenRouter à medida que o roteamento baseado em modelos de IA ganha força
A Stripe concordou em adquirir a OpenRouter, uma plataforma de roteamento de modelos de IA que oferece aos desenvolvedores acesso a centenas de modelos por meio de uma única interface. O acordo amplia
O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (4)
![CarlLewis]()
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild—makes you wonder if we're chasing the wrong AI benchmark. 🤯 What’s next, machines outsmarting us at our own game?
![JamesLopez]()
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild. Makes me wonder if we're chasing the wrong AI benchmark. 🧠 What's next?
![DavidGonzález]()
Mind blown! GPT-4.5 is shaking up the Turing Test, but it’s wild to think it’s still just mimicking, not truly thinking like us. 🤯 Makes me wonder if we’re chasing the wrong goal in AI.
![PaulWilson]()
GPT-4.5 blowing past the Turing Test is wild! 😲 But honestly, it just shows the test’s more about trickery than true smarts. Makes you wonder if we’re measuring AI’s brainpower or just its acting skills. What’s next, an Oscar for chatbots?
O Teste de Turing, uma criação do lendário Alan Turing, tem sido há muito tempo um marco no mundo da inteligência artificial. Mas vamos esclarecer um equívoco comum logo de início: passar no Teste de Turing não significa necessariamente que uma máquina está "pensando" como um humano. É mais sobre convencer humanos de que ela é.
Pesquisas recentes da Universidade da Califórnia em San Diego destacaram o mais recente modelo da OpenAI, o GPT-4.5. Essa IA agora pode enganar humanos fazendo-os acreditar que estão conversando com outra pessoa, de forma ainda mais eficaz do que humanos conseguem convencer uns aos outros de sua humanidade. Isso é algo bem significativo no mundo da IA — é como assistir a um truque de mágica onde você conhece o segredo, mas ainda assim fica impressionado.
Prova de AGI?
Mas aqui está o ponto crucial: mesmo os pesquisadores da UC San Diego não estão prontos para declarar que alcançamos a "inteligência geral artificial" (AGI) só porque um modelo de IA pode passar no Teste de Turing. AGI seria o santo graal da IA — máquinas que podem pensar e processar informações exatamente como humanos.
Melanie Mitchell, uma estudiosa de IA do Santa Fe Institute, argumenta na revista Science que o Teste de Turing é mais sobre testar suposições humanas do que inteligência real. Claro, uma IA pode soar fluente e convincente, mas isso não é o mesmo que ser geralmente inteligente. É como ser bom em xadrez — é impressionante, mas não é o quadro completo.
O mais recente burburinho sobre isso vem de um artigo de Cameron Jones e Benjamin Bergen na UC San Diego, intitulado "Modelos de Linguagem de Grande Escala Passam no Teste de Turing", publicado no servidor de pré-impressão arXiv. Eles têm conduzido esse experimento por anos, com a ajuda de estudantes de graduação da UC San Diego, e isso faz parte de uma longa linha de pesquisa — mais de 800 afirmações e contra-argumentos foram feitos sobre computadores passando no Teste de Turing.
Como Funciona o Teste de Turing
Então, como funciona esse teste? Originalmente, Turing imaginou-o como um jogo de mensagens de texto entre um "juiz" humano e dois "testemunhas" — um humano, um computador. O desafio para as testemunhas é convencer o juiz de que são humanas. O juiz sabe que uma é humana, mas não sabe qual, e precisa fazer um palpite. É uma configuração tripla que envolve tanto percepção e crença quanto as habilidades do computador.
Jones e Bergen deram seu próprio toque a essa configuração clássica, e você pode até experimentá-la online, jogando como juiz ou testemunha. Na versão deles, estudantes da UC San Diego usaram um aplicativo de chat de texto. Alguns foram juízes, outros testemunhas humanas, enquanto o GPT-4.5 assumiu o papel de testemunha computacional. Cada juiz conversou com um humano e um computador ao mesmo tempo, mantendo-se fiel ao formato original de Turing.
Para interpretar a testemunha computacional, eles usaram diferentes modelos de linguagem de grande escala, fornecendo-lhes prompts baseados nos desafios do juiz. O GPT-4.5 foi testado com dois prompts diferentes: um com informações mínimas e outro chamado PERSONA, que incluía instruções detalhadas para agir como uma pessoa jovem, introvertida e conhecedora da internet, que usa gírias.
Os Resultados
Eles também testaram outros três programas de IA: o modelo anterior da OpenAI, GPT-4o; o Llama 3.1 405b da Meta Platforms; e o chatbot dos anos 1960, ELIZA. Eles incluíram o ELIZA para verificar se os modelos de linguagem de grande escala estavam apenas enganando humanos por acaso ou se eram genuinamente melhores.
Segundo Jones e Bergen, o GPT-4.5 enganou juízes humanos, fazendo-os pensar que era humano em 73% das vezes — uma "taxa de vitória", como eles chamam. Isso é muito melhor do que os outros modelos, que marcaram entre 21% e 56%, mesmo com prompts detalhados semelhantes. E é um salto enorme em relação ao teste do ano passado com o GPT-4, que teve uma taxa de vitória de apenas 54%, mal acima do acaso.
Jones e Bergen descobriram que os juízes não apenas foram enganados pela IA, mas também eram mais propensos a acreditar que ela era humana do que os participantes humanos reais.
O Teste é Realmente uma Medida de Inteligência?
Então, o que significa que humanos não conseguem distinguir um computador de uma pessoa em um chat? A grande questão que tem sido debatida por décadas é se o Teste de Turing está realmente medindo inteligência. Jones e Bergen sugerem que talvez as máquinas tenham se tornado tão boas em se adaptar a diferentes cenários que podem passar convincentemente por humanas. O prompt PERSONA, criado por humanos, é algo que o GPT-4.5 adaptou e usou a seu favor.
Mas há um porém: talvez os humanos sejam apenas ruins em reconhecer inteligência. Os autores apontam que o ELIZA, o antigo chatbot, enganou juízes em 23% das vezes, não porque era mais inteligente, mas porque não atendia às expectativas deles sobre o que uma IA deveria ser. Alguns juízes pensaram que era humano porque era "sarcástico" ou "rude", o que eles não esperavam de uma IA.
Isso sugere que os juízes são influenciados por suas suposições sobre como humanos e IAs devem se comportar, em vez de apenas escolher o agente que parece mais inteligente. Curiosamente, os juízes não se concentraram muito no conhecimento, que Turing achava que seria fundamental. Em vez disso, eram mais propensos a pensar que uma testemunha era humana se parecesse ter falta de conhecimento.
Sociabilidade, Não Inteligência
Tudo isso aponta para a ideia de que os humanos estavam captando sociabilidade em vez de inteligência. Jones e Bergen concluem que o Teste de Turing não é realmente um teste de inteligência — é um teste de semelhança com humanos.
Turing pode ter pensado que a inteligência era o maior obstáculo para parecer humano, mas, à medida que as máquinas se aproximam de nós, outras diferenças se tornam mais evidentes. A inteligência por si só não é mais suficiente para parecer convincentemente humano.
O que não é dito diretamente no artigo é que os humanos estão tão acostumados a digitar em computadores, seja para uma pessoa ou uma máquina, que o Teste de Turing não é mais o teste inovador de interação humano-computador que já foi. Agora é mais um teste de hábitos humanos online.
Os autores sugerem que o teste pode precisar ser expandido porque a inteligência é tão complexa e multifacetada que nenhum teste único pode ser decisivo. Eles propõem diferentes designs, como usar especialistas em IA como juízes ou adicionar incentivos financeiros para fazer os juízes examinarem mais de perto. Essas mudanças poderiam mostrar o quanto atitude e expectativas influenciam os resultados.
Eles concluem que, embora o Teste de Turing possa fazer parte do quadro, ele deve ser considerado ao lado de outros tipos de evidências. Isso se alinha com uma tendência crescente na pesquisa de IA de envolver humanos "no ciclo", avaliando o que as máquinas fazem.
O Julgamento Humano é Suficiente?
Mas ainda há a questão de se o julgamento humano será suficiente a longo prazo. No filme Blade Runner, os humanos usam uma máquina, o "Voight-Kampff", para distinguir humanos de robôs replicantes. À medida que perseguimos o AGI, e lutamos para definir o que ele realmente é, podemos acabar dependendo de máquinas para avaliar a inteligência das máquinas.
Ou, no mínimo, podemos precisar perguntar às máquinas o que elas "pensam" sobre humanos tentando enganar outros humanos com prompts. É um mundo selvagem na pesquisa de IA, e está ficando cada vez mais interessante.








 Stripe vai adquirir a OpenRouter à medida que o roteamento baseado em modelos de IA ganha força
A Stripe concordou em adquirir a OpenRouter, uma plataforma de roteamento de modelos de IA que oferece aos desenvolvedores acesso a centenas de modelos por meio de uma única interface. O acordo amplia
 O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
 Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild—makes you wonder if we're chasing the wrong AI benchmark. 🤯 What’s next, machines outsmarting us at our own game?
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild. Makes me wonder if we're chasing the wrong AI benchmark. 🧠 What's next?
Mind blown! GPT-4.5 is shaking up the Turing Test, but it’s wild to think it’s still just mimicking, not truly thinking like us. 🤯 Makes me wonder if we’re chasing the wrong goal in AI.
GPT-4.5 blowing past the Turing Test is wild! 😲 But honestly, it just shows the test’s more about trickery than true smarts. Makes you wonder if we’re measuring AI’s brainpower or just its acting skills. What’s next, an Oscar for chatbots?












