


 家
OpenAIのGPT-4.5が暴露したチューリングテストの問題
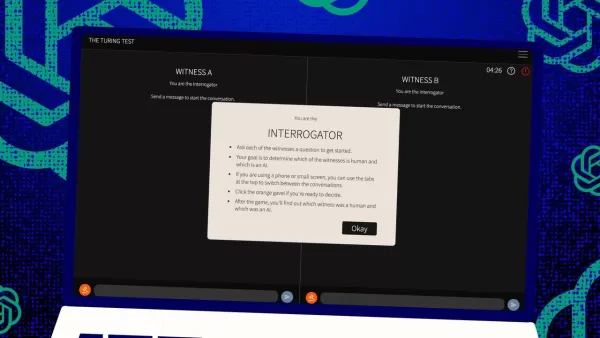
チューリングテストは、伝説的なアラン・チューリングの発案であり、人工知能の世界で長い間ベンチマークとされてきました。しかし、最初に一般的な誤解を解いておきましょう。チューリングテストに合格することは、必ずしもマシンが人間のよう に「思考」していることを意味するわけではありません。それよりも、人間を説得してそう思わせることに関係しています。
カリフォルニア大学サンディエゴ校の最近の研究は、OpenAIの最新モデル、GPT-4.5に注目を集めています。このAIは、人間が他の人とチャットしていると信じ込ませる能力が、人間が互いに自分の人間性を説得するよりもさらに効果的です。これはAIの世界ではかなり大きな出来事です。まるでマジックのトリックを見ているようで、秘密を知っていても驚かされます。
AGIの証明?
しかし、ここで重要なのは、カリフォルニア大学サンディエゴ校の研究者たちでさえ、AIモデルがチューリングテストに合格したからといって「人工汎用知能」(AGI)に到達したと宣言する準備ができていないことです。AGIはAIの聖杯であり、人間と同じように思考し情報を処理できるマシンです。
サンタフェ研究所のAI研究者メラニー・ミッチェルは、ジャーナルScienceで、チューリングテストは実際の知能よりも人間の前提をテストするものだと主張しています。確かに、AIは流暢で説得力があるように聞こえるかもしれませんが、それは一般的な知能を持っていることと同じではありません。チェスが得意なのと同じで、素晴らしいことですが、全体像ではありません。
この話題の最新の話題は、カリフォルニア大学サンディエゴ校のキャメロン・ジョーンズとベンジャミン・バーゲンによる論文「Large Language Models Pass the Turing Test」で、arXivプレプリントサーバーに公開されています。彼らは何年もこの実験を行っており、カリフォルニア大学サンディエゴ校の学部生の協力を得て、コンピュータがチューリングテストに合格したという800以上の主張と反論がこれまでに行われてきた長い研究の一環です。
チューリングテストの仕組み
では、このテストはどのように機能するのでしょうか?元々、チューリングはこれを人間の「裁判官」と2人の「証人」—1人は人間、1人はコンピュータ—とのテキストメッセージのゲームとして想像しました。証人の課題は、裁判官に自分が人間だと説得することです。裁判官はどちらか一方が人間だと知っていますが、どちらが人間かを知らず、推測する必要があります。これは、コンピュータの能力と同じくらい、知覚と信念に関する3者間の設定です。
ジョーンズとバーゲンはこの古典的な設定に独自のひねりを加えており、オンラインで試すこともでき、裁判官または証人としてプレイできます。彼らのバージョンでは、カリフォルニア大学サンディエゴ校の学生がテキストチャットアプリを使用しました。一部は裁判官を務め、他は人間の証人として、GPT-4.5がコンピュータの証人として参加しました。各裁判官は、チューリングの元の形式に忠実に、人間とコンピュータの両方と同時にチャットしました。
コンピュータの証人を演じるために、彼らは異なる大規模言語モデルを使用し、裁判官の挑戦に基づいたプロンプトを入力しました。GPT-4.5は2つの異なるプロンプトでテストされました。1つは最小限の情報、もう1つはPERSONAと呼ばれるもので、若くて内向的でインターネットに精通したスラングを使う人物として振る舞う詳細な指示が含まれていました。
結果
彼らはまた、3つの他のAIプログラムをテストしました:OpenAIの以前のモデル、GPT-4o、Meta PlatformsのLlama 3.1 405b、そして1960年代の古いチャットボット、ELIZAです。ELIZAをテストに含めたのは、大規模言語モデルが単に偶然人間を騙しているのか、それとも本当により優れているのかを確認するためでした。
ジョーンズとバーゲンによると、GPT-4.5は人間の裁判官を73%の確率で人間だと信じ込ませました。これは彼らが「勝率」と呼ぶもので、他のモデル(21%から56%のスコア)よりもはるかに優れていました。詳細なプロンプトを使用しても同様の結果でした。そして、昨年のGPT-4のテストでの勝率54%(ほぼランダムな確率)からの大きな飛躍です。
ジョーンズとバーゲンは、裁判官がAIに騙されただけでなく、実際の人間の参加者よりもAIが人間だと信じられる可能性が高いことを発見しました。
テストは本当に知能を測定しているのか?
では、チャットで人間がコンピュータと人を区別できないことは何を意味するのでしょうか?何十年も議論されてきた大きな疑問は、チューリングテストが本当に知能を測定しているのかということです。ジョーンズとバーゲンは、マシンがさまざまなシナリオに適応する能力が非常に優れているため、人間として説得力を持って振る舞えるのかもしれないと示唆しています。人間が作成したPERSONAプロンプトは、GPT-4.5が適応し、活用したものです。
しかし、問題があります。人間が知能を認識するのが下手なのかもしれません。著者は、古いチャットボットELIZAが23%の確率で裁判官を騙したのは、それが賢いからではなく、AIに対する彼らの期待を満たさなかったからだと指摘しています。一部の裁判官は、ELIZAが「皮肉」や「無礼」だったため人間だと思ったとされ、AIに期待していなかった態度でした。
これは、裁判官が人間やAIがどう振る舞うべきかという前提に影響されていることを示唆しています。興味深いことに、裁判官はチューリングが重要だと考えていた知識にはあまり焦点を当てませんでした。代わりに、知識が不足しているように見える証人を人間だと考える傾向がありました。
社交性、知能ではない
これらすべては、人間が知能ではなく社交性を重視していたという考えを指しています。ジョーンズとバーゲンは、チューリングテストは本当の知能のテストではなく、人間らしさのテストだと結論付けています。
チューリングは、知能が人間らしく見えるための最大の障害だと考えていたかもしれませんが、マシンが我々に近づくにつれて、他の違いがより明らかになります。知能だけでは、もはや説得力のある人間らしさには十分ではありません。
論文では直接言及されていませんが、人間はコンピュータでのタイピングに慣れすぎており、人間とマシンのどちらと話しているかにかかわらず、チューリングテストはかつてのような斬新な人間とコンピュータの相互作用のテストではなく、オンラインの人間の習慣のテストになっています。
著者は、知能は非常に複雑で多面的であるため、単一のテストでは決定的なものにはならないとして、テストを拡張する必要があるかもしれないと提案しています。AIの専門家を裁判官にしたり、金銭的インセンティブを追加して裁判官がより厳密に精査するようにするなど、異なるデザインを提案しています。これらの変更は、態度や期待が結果にどれだけ影響するかを示す可能性があります。
彼らは、チューリングテストが全体像の一部かもしれないが、他の種類の証拠と一緒に考慮すべきだと結論付けています。これは、AI研究において人間を「ループ」に含め、マシンの行動を評価する傾向が高まっていることと一致しています。
人間の判断は十分か?
しかし、長期的に見て人間の判断が十分かどうか、という疑問が残ります。映画Blade Runnerでは、人間は「Voight-Kampff」というマシンを使用して人間とレプリカントロボットを区別します。AGIを追い求め、そもそもそれが何かを定義するのに苦労する中、結局、マシンの知能を評価するためにマシンに頼ることになるかもしれません。
あるいは、少なくとも、プロンプトを使って人間を騙そうとする人間について、マシンがどう「考える」かを尋ねる必要があるかもしれません。AI研究の世界は刺激的で、ますます興味深いものになっています。
関連記事
 Wan-Streamer v0.2は超低遅延のAIチャットを提供します
現代技術が急速に進歩するにつれ、人間とAIの相互作用はより一般的になっています。従来のビデオ通話では、ラグ、遅延、音声と映像の非同期といった問題にしばしば直面します。Tongyi Labによる最新リリースであるWan-Streamer v0.2は、これらの課題を完全に克服し、わずか550ミリ秒の応答遅延で、真に自然な「対面」コミュニケーションを可能にします。Wan-Streamer v0.2は、新しいエンドツーエンドのマルチモーダル理解および生成モデルです。単一のTransformerモデル内で
MetaはTSMCとMicronの参加を得て、旧型メモリを搭載した新規サーバーを整備する
人工知能の採用が世界中で加速する中、次世代DDR5メモリは深刻な供給不足に直面しています。AIデータセンターの展開における遅延を回避するため、MetaはTSMCやMicronといった業界のリーダーと提携し、画期的な過渡期のソリューションを開発しました。この革新により、従来DDR5専用に設計されていた高度なAIサーバーが、従来のDDR4モジュールとシームレスに動作できるようになりました。「フランケンシュタイン」構成と称されるこのシステムは、実世界のテストで顕著な安定性を示し、現在進行中のサプライチ
時系列データベースがリアルタイムのロボティクスデータをどのように支えるか
タイガー・データのドグ・パグヌッティ。パグヌッティ氏は、タイガー・データで産業用開発者エバンジェリストを務め、実世界の産業システムの構築を支援するチームをサポートしています。石油・ガスおよび製造業の自動化分野で12年以上の経験を持つ彼は、PLC、ロボット、SCADAシステムに取り組み、その後Dell EMCおよびVTScadaでの産業用ソフトウェア開発に移行しました。彼は、大規模なIIoT展開における時系列データインフラストラクチャの課題を自動化エンジニアが解決するのを支援することで、OTとIT
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (4)
0/500
![CarlLewis]()
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild—makes you wonder if we're chasing the wrong AI benchmark. 🤯 What’s next, machines outsmarting us at our own game?
![JamesLopez]()
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild. Makes me wonder if we're chasing the wrong AI benchmark. 🧠 What's next?
![DavidGonzález]()
Mind blown! GPT-4.5 is shaking up the Turing Test, but it’s wild to think it’s still just mimicking, not truly thinking like us. 🤯 Makes me wonder if we’re chasing the wrong goal in AI.
![PaulWilson]()
GPT-4.5 blowing past the Turing Test is wild! 😲 But honestly, it just shows the test’s more about trickery than true smarts. Makes you wonder if we’re measuring AI’s brainpower or just its acting skills. What’s next, an Oscar for chatbots?
チューリングテストは、伝説的なアラン・チューリングの発案であり、人工知能の世界で長い間ベンチマークとされてきました。しかし、最初に一般的な誤解を解いておきましょう。チューリングテストに合格することは、必ずしもマシンが人間のよう に「思考」していることを意味するわけではありません。それよりも、人間を説得してそう思わせることに関係しています。
カリフォルニア大学サンディエゴ校の最近の研究は、OpenAIの最新モデル、GPT-4.5に注目を集めています。このAIは、人間が他の人とチャットしていると信じ込ませる能力が、人間が互いに自分の人間性を説得するよりもさらに効果的です。これはAIの世界ではかなり大きな出来事です。まるでマジックのトリックを見ているようで、秘密を知っていても驚かされます。
AGIの証明?
しかし、ここで重要なのは、カリフォルニア大学サンディエゴ校の研究者たちでさえ、AIモデルがチューリングテストに合格したからといって「人工汎用知能」(AGI)に到達したと宣言する準備ができていないことです。AGIはAIの聖杯であり、人間と同じように思考し情報を処理できるマシンです。
サンタフェ研究所のAI研究者メラニー・ミッチェルは、ジャーナルScienceで、チューリングテストは実際の知能よりも人間の前提をテストするものだと主張しています。確かに、AIは流暢で説得力があるように聞こえるかもしれませんが、それは一般的な知能を持っていることと同じではありません。チェスが得意なのと同じで、素晴らしいことですが、全体像ではありません。
この話題の最新の話題は、カリフォルニア大学サンディエゴ校のキャメロン・ジョーンズとベンジャミン・バーゲンによる論文「Large Language Models Pass the Turing Test」で、arXivプレプリントサーバーに公開されています。彼らは何年もこの実験を行っており、カリフォルニア大学サンディエゴ校の学部生の協力を得て、コンピュータがチューリングテストに合格したという800以上の主張と反論がこれまでに行われてきた長い研究の一環です。
チューリングテストの仕組み
では、このテストはどのように機能するのでしょうか?元々、チューリングはこれを人間の「裁判官」と2人の「証人」—1人は人間、1人はコンピュータ—とのテキストメッセージのゲームとして想像しました。証人の課題は、裁判官に自分が人間だと説得することです。裁判官はどちらか一方が人間だと知っていますが、どちらが人間かを知らず、推測する必要があります。これは、コンピュータの能力と同じくらい、知覚と信念に関する3者間の設定です。
ジョーンズとバーゲンはこの古典的な設定に独自のひねりを加えており、オンラインで試すこともでき、裁判官または証人としてプレイできます。彼らのバージョンでは、カリフォルニア大学サンディエゴ校の学生がテキストチャットアプリを使用しました。一部は裁判官を務め、他は人間の証人として、GPT-4.5がコンピュータの証人として参加しました。各裁判官は、チューリングの元の形式に忠実に、人間とコンピュータの両方と同時にチャットしました。
コンピュータの証人を演じるために、彼らは異なる大規模言語モデルを使用し、裁判官の挑戦に基づいたプロンプトを入力しました。GPT-4.5は2つの異なるプロンプトでテストされました。1つは最小限の情報、もう1つはPERSONAと呼ばれるもので、若くて内向的でインターネットに精通したスラングを使う人物として振る舞う詳細な指示が含まれていました。
結果
彼らはまた、3つの他のAIプログラムをテストしました:OpenAIの以前のモデル、GPT-4o、Meta PlatformsのLlama 3.1 405b、そして1960年代の古いチャットボット、ELIZAです。ELIZAをテストに含めたのは、大規模言語モデルが単に偶然人間を騙しているのか、それとも本当により優れているのかを確認するためでした。
ジョーンズとバーゲンによると、GPT-4.5は人間の裁判官を73%の確率で人間だと信じ込ませました。これは彼らが「勝率」と呼ぶもので、他のモデル(21%から56%のスコア)よりもはるかに優れていました。詳細なプロンプトを使用しても同様の結果でした。そして、昨年のGPT-4のテストでの勝率54%(ほぼランダムな確率)からの大きな飛躍です。
ジョーンズとバーゲンは、裁判官がAIに騙されただけでなく、実際の人間の参加者よりもAIが人間だと信じられる可能性が高いことを発見しました。
テストは本当に知能を測定しているのか?
では、チャットで人間がコンピュータと人を区別できないことは何を意味するのでしょうか?何十年も議論されてきた大きな疑問は、チューリングテストが本当に知能を測定しているのかということです。ジョーンズとバーゲンは、マシンがさまざまなシナリオに適応する能力が非常に優れているため、人間として説得力を持って振る舞えるのかもしれないと示唆しています。人間が作成したPERSONAプロンプトは、GPT-4.5が適応し、活用したものです。
しかし、問題があります。人間が知能を認識するのが下手なのかもしれません。著者は、古いチャットボットELIZAが23%の確率で裁判官を騙したのは、それが賢いからではなく、AIに対する彼らの期待を満たさなかったからだと指摘しています。一部の裁判官は、ELIZAが「皮肉」や「無礼」だったため人間だと思ったとされ、AIに期待していなかった態度でした。
これは、裁判官が人間やAIがどう振る舞うべきかという前提に影響されていることを示唆しています。興味深いことに、裁判官はチューリングが重要だと考えていた知識にはあまり焦点を当てませんでした。代わりに、知識が不足しているように見える証人を人間だと考える傾向がありました。
社交性、知能ではない
これらすべては、人間が知能ではなく社交性を重視していたという考えを指しています。ジョーンズとバーゲンは、チューリングテストは本当の知能のテストではなく、人間らしさのテストだと結論付けています。
チューリングは、知能が人間らしく見えるための最大の障害だと考えていたかもしれませんが、マシンが我々に近づくにつれて、他の違いがより明らかになります。知能だけでは、もはや説得力のある人間らしさには十分ではありません。
論文では直接言及されていませんが、人間はコンピュータでのタイピングに慣れすぎており、人間とマシンのどちらと話しているかにかかわらず、チューリングテストはかつてのような斬新な人間とコンピュータの相互作用のテストではなく、オンラインの人間の習慣のテストになっています。
著者は、知能は非常に複雑で多面的であるため、単一のテストでは決定的なものにはならないとして、テストを拡張する必要があるかもしれないと提案しています。AIの専門家を裁判官にしたり、金銭的インセンティブを追加して裁判官がより厳密に精査するようにするなど、異なるデザインを提案しています。これらの変更は、態度や期待が結果にどれだけ影響するかを示す可能性があります。
彼らは、チューリングテストが全体像の一部かもしれないが、他の種類の証拠と一緒に考慮すべきだと結論付けています。これは、AI研究において人間を「ループ」に含め、マシンの行動を評価する傾向が高まっていることと一致しています。
人間の判断は十分か?
しかし、長期的に見て人間の判断が十分かどうか、という疑問が残ります。映画Blade Runnerでは、人間は「Voight-Kampff」というマシンを使用して人間とレプリカントロボットを区別します。AGIを追い求め、そもそもそれが何かを定義するのに苦労する中、結局、マシンの知能を評価するためにマシンに頼ることになるかもしれません。
あるいは、少なくとも、プロンプトを使って人間を騙そうとする人間について、マシンがどう「考える」かを尋ねる必要があるかもしれません。AI研究の世界は刺激的で、ますます興味深いものになっています。








 Wan-Streamer v0.2は超低遅延のAIチャットを提供します
現代技術が急速に進歩するにつれ、人間とAIの相互作用はより一般的になっています。従来のビデオ通話では、ラグ、遅延、音声と映像の非同期といった問題にしばしば直面します。Tongyi Labによる最新リリースであるWan-Streamer v0.2は、これらの課題を完全に克服し、わずか550ミリ秒の応答遅延で、真に自然な「対面」コミュニケーションを可能にします。Wan-Streamer v0.2は、新しいエンドツーエンドのマルチモーダル理解および生成モデルです。単一のTransformerモデル内で
 MetaはTSMCとMicronの参加を得て、旧型メモリを搭載した新規サーバーを整備する
人工知能の採用が世界中で加速する中、次世代DDR5メモリは深刻な供給不足に直面しています。AIデータセンターの展開における遅延を回避するため、MetaはTSMCやMicronといった業界のリーダーと提携し、画期的な過渡期のソリューションを開発しました。この革新により、従来DDR5専用に設計されていた高度なAIサーバーが、従来のDDR4モジュールとシームレスに動作できるようになりました。「フランケンシュタイン」構成と称されるこのシステムは、実世界のテストで顕著な安定性を示し、現在進行中のサプライチ
 時系列データベースがリアルタイムのロボティクスデータをどのように支えるか
タイガー・データのドグ・パグヌッティ。パグヌッティ氏は、タイガー・データで産業用開発者エバンジェリストを務め、実世界の産業システムの構築を支援するチームをサポートしています。石油・ガスおよび製造業の自動化分野で12年以上の経験を持つ彼は、PLC、ロボット、SCADAシステムに取り組み、その後Dell EMCおよびVTScadaでの産業用ソフトウェア開発に移行しました。彼は、大規模なIIoT展開における時系列データインフラストラクチャの課題を自動化エンジニアが解決するのを支援することで、OTとIT

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild—makes you wonder if we're chasing the wrong AI benchmark. 🤯 What’s next, machines outsmarting us at our own game?
Mind-blowing read! GPT-4.5 exposing the Turing Test's flaws is wild. Makes me wonder if we're chasing the wrong AI benchmark. 🧠 What's next?
Mind blown! GPT-4.5 is shaking up the Turing Test, but it’s wild to think it’s still just mimicking, not truly thinking like us. 🤯 Makes me wonder if we’re chasing the wrong goal in AI.
GPT-4.5 blowing past the Turing Test is wild! 😲 But honestly, it just shows the test’s more about trickery than true smarts. Makes you wonder if we’re measuring AI’s brainpower or just its acting skills. What’s next, an Oscar for chatbots?












