


 首页
字节跳动发布Seed-Thinking-v1.5 AI模型以增强推理能力
高级推理AI的竞赛始于2024年9月OpenAI的o1模型,随着2025年1月DeepSeek的R1发布而加速。
主要AI开发者现正竞相打造更快、更具成本效益的推理AI模型,通过链式思考过程提供精确、深思熟虑的回答,确保回答前的准确性。
字节跳动,TikTok的母公司,推出了Seed-Thinking-v1.5,这是一个在技术论文中概述的新大型语言模型(LLM),旨在提升STEM和通用领域的推理能力。
该模型尚未发布,其许可模式——无论是专有、开源还是混合——仍未披露。然而,该论文提供了值得在发布前探索的关键见解。
利用专家混合(MoE)框架
继Meta的Llama 4和Mistral的Mixtral之后,Seed-Thinking-v1.5采用了专家混合(MoE)架构。
这种方法通过整合多个专注于不同领域的专业模型来提升效率。
Seed-Thinking-v1.5一次仅使用其2000亿参数中的200亿,优化了性能。
字节跳动在GitHub上发布的论文强调了该模型专注于结构化推理和深思熟虑的回答生成。
它超越了DeepSeek R1,并在第三方基准测试中与Google的Gemini 2.5 Pro和OpenAI的o3-mini-high匹敌,甚至在ARC-AGI基准测试中表现出色,该基准是衡量向通用人工智能进展的关键指标,超越了OpenAI标准下人类在经济价值任务中的表现。
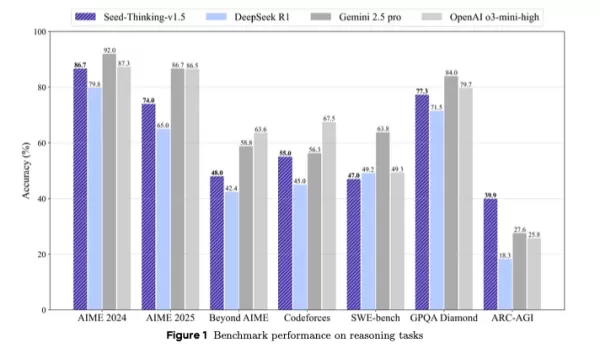
作为紧凑而强大的替代大型模型,Seed-Thinking-v1.5通过创新的强化学习、精选训练数据和先进的AI基础设施实现了强劲的基准测试结果。
基准测试表现与核心优势
Seed-Thinking-v1.5在困难任务中表现出色,在AIME 2024上得分86.7%,在Codeforces上pass@8得分55.0%,在GPQA科学基准测试中得分77.3%,在推理指标上接近或超越OpenAI的o3-mini-high和Google的Gemini 2.5 Pro等模型。
在非推理任务中,它比DeepSeek R1高出8.0%的人类偏好胜率,展示了逻辑和数学之外的多样性。
为应对基准测试饱和,字节跳动创建了BeyondAIME,一个更难的数学基准测试,以抵制记忆并更好地评估模型性能。这与Codeforces数据集一起,将公开发布以助力未来研究。
训练数据策略
数据质量在开发Seed-Thinking-v1.5中至关重要。用于监督微调的40万个样本经过精心挑选:30万个可验证的STEM、逻辑和编码任务,以及10万个不可验证的任务,如创意写作。
用于强化学习的数据分为:
- 可验证问题:从精英竞赛中精心挑选的10万个STEM问题和逻辑谜题,由专家验证。
- 不可验证任务:用于开放式提示的人类偏好数据集,通过成对奖励模型评估。
超过80%的STEM数据专注于高级数学,逻辑任务如数独和24点谜题按模型进展进行扩展。
强化学习创新
Seed-Thinking-v1.5使用定制的actor-critic(VAPO)和策略梯度(DAPO)框架来稳定强化学习,解决长链式思考场景中的问题。
两个奖励模型增强了强化学习监督:
- Seed-Verifier:基于规则的LLM,确保生成答案与参考答案的数学等价性。
- Seed-Thinking-Verifier:基于推理的评判模型,保持一致性评估,抵御奖励操控。
这一双重系统支持简单和复杂任务的精确评估。
可扩展的基础设施设计
字节跳动的HybridFlow框架,由Ray集群提供支持,支持高效的大规模训练,通过协同定位训练和推理以最小化GPU空闲时间。
流式推出系统(SRS)将模型演化与运行时分离,通过异步管理部分生成,将迭代速度提高至三倍。
其他技术包括:
- 混合精度(FP8)以提高内存效率
- 专家并行和内核自动调优以优化MoE
- ByteCheckpoint用于稳健的检查点
- AutoTuner用于优化的并行和内存设置
以人为本的评估与实际应用
在创意写作、人文学科和一般对话的人类测试中,Seed-Thinking-v1.5超越了DeepSeek R1,证明了其现实世界的相关性。
团队指出,在可验证任务上的训练增强了对创意领域的泛化能力,这是由严格的数学工作流程驱动的。
对技术团队和企业的意义
对于管理LLM生命周期的技术领导者,Seed-Thinking-v1.5提供了一个将高级推理整合到企业AI系统中的模型。
其模块化训练,结合可验证数据集和多阶段强化学习,适合需要精确控制的LLM开发团队。
Seed-Verifier和Seed-Thinking-Verifier增强了可信的奖励建模,对于面向客户或受监管的环境至关重要。
对于时间紧迫的团队,VAPO和动态采样减少了迭代周期,简化了特定任务的微调。
混合基础设施,包括SRS和FP8优化,提升了训练吞吐量和硬件效率,适用于云和本地系统。
模型的自适应奖励反馈解决了管理多样化数据管道的挑战,确保跨领域的一致性。
对于数据工程师,严格的数据过滤和专家验证的重点强调了高质量数据集在提升模型性能中的价值。
未来展望
由吴永辉领导、林海滨公开代表的字节跳动Seed LLM系统团队开发的Seed-Thinking-v1.5,基于Doubao 1.5 Pro的努力,采用了共享的RLHF和数据精选技术。
团队旨在改进强化学习,专注于训练效率和不可验证任务的奖励建模。发布BeyondAIME等基准测试将推动推理导向的AI研究的进一步进展。
相关文章
 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
谷歌推出虚假来电检测功能,以防范AI深度伪造冒充诈骗
谷歌周二宣布,Android将推出虚假来电检测功能,以防范利用AI深度伪造技术实施的冒充诈骗。该功能将于本月通过“Phone by Google”在全球范围内面向Android 12及以上版本的设备逐步推出,首先适用于Pixel设备。随着人们越来越不愿接听陌生号码的来电,诈骗分子正改变策略,通过伪造可信的电话号码,并利用AI深度伪造技术模仿权威人士、家人或雇主的语气进行诈骗。例如,某人可能会接到一
小鹏汽车旗下的Dogotix完成9亿美元融资
小鹏汽车旗下的Dogotix部门正在研发IRON人形机器人。来源:小鹏汽车效仿其他全球主要汽车制造商的做法,小鹏汽车正将业务拓展至类人机器人领域。 这家电动汽车制造商今日宣布,其机器人子公司Dogotix在首轮融资中筹集了超过9亿美元,此轮融资前的估值为50亿美元,交易后的估值超过63亿美元。据小鹏汽车称,这笔资金将用于推进软硬件开发、收集运营数据、训练物理AI模型、建立量产设施,并推动全球业务扩
相关专题推荐
聊天机器人
 最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
 12 个工具
 xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
设计与艺术
最佳AI创意构思工具,助力艺术家突破视觉瓶颈
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai

 评论 (1)
0/500
![ChristopherDavis]()
Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.
高级推理AI的竞赛始于2024年9月OpenAI的o1模型,随着2025年1月DeepSeek的R1发布而加速。
主要AI开发者现正竞相打造更快、更具成本效益的推理AI模型,通过链式思考过程提供精确、深思熟虑的回答,确保回答前的准确性。
字节跳动,TikTok的母公司,推出了Seed-Thinking-v1.5,这是一个在技术论文中概述的新大型语言模型(LLM),旨在提升STEM和通用领域的推理能力。
该模型尚未发布,其许可模式——无论是专有、开源还是混合——仍未披露。然而,该论文提供了值得在发布前探索的关键见解。
利用专家混合(MoE)框架
继Meta的Llama 4和Mistral的Mixtral之后,Seed-Thinking-v1.5采用了专家混合(MoE)架构。
这种方法通过整合多个专注于不同领域的专业模型来提升效率。
Seed-Thinking-v1.5一次仅使用其2000亿参数中的200亿,优化了性能。
字节跳动在GitHub上发布的论文强调了该模型专注于结构化推理和深思熟虑的回答生成。
它超越了DeepSeek R1,并在第三方基准测试中与Google的Gemini 2.5 Pro和OpenAI的o3-mini-high匹敌,甚至在ARC-AGI基准测试中表现出色,该基准是衡量向通用人工智能进展的关键指标,超越了OpenAI标准下人类在经济价值任务中的表现。
作为紧凑而强大的替代大型模型,Seed-Thinking-v1.5通过创新的强化学习、精选训练数据和先进的AI基础设施实现了强劲的基准测试结果。
基准测试表现与核心优势
Seed-Thinking-v1.5在困难任务中表现出色,在AIME 2024上得分86.7%,在Codeforces上pass@8得分55.0%,在GPQA科学基准测试中得分77.3%,在推理指标上接近或超越OpenAI的o3-mini-high和Google的Gemini 2.5 Pro等模型。
在非推理任务中,它比DeepSeek R1高出8.0%的人类偏好胜率,展示了逻辑和数学之外的多样性。
为应对基准测试饱和,字节跳动创建了BeyondAIME,一个更难的数学基准测试,以抵制记忆并更好地评估模型性能。这与Codeforces数据集一起,将公开发布以助力未来研究。
训练数据策略
数据质量在开发Seed-Thinking-v1.5中至关重要。用于监督微调的40万个样本经过精心挑选:30万个可验证的STEM、逻辑和编码任务,以及10万个不可验证的任务,如创意写作。
用于强化学习的数据分为:
- 可验证问题:从精英竞赛中精心挑选的10万个STEM问题和逻辑谜题,由专家验证。
- 不可验证任务:用于开放式提示的人类偏好数据集,通过成对奖励模型评估。
超过80%的STEM数据专注于高级数学,逻辑任务如数独和24点谜题按模型进展进行扩展。
强化学习创新
Seed-Thinking-v1.5使用定制的actor-critic(VAPO)和策略梯度(DAPO)框架来稳定强化学习,解决长链式思考场景中的问题。
两个奖励模型增强了强化学习监督:
- Seed-Verifier:基于规则的LLM,确保生成答案与参考答案的数学等价性。
- Seed-Thinking-Verifier:基于推理的评判模型,保持一致性评估,抵御奖励操控。
这一双重系统支持简单和复杂任务的精确评估。
可扩展的基础设施设计
字节跳动的HybridFlow框架,由Ray集群提供支持,支持高效的大规模训练,通过协同定位训练和推理以最小化GPU空闲时间。
流式推出系统(SRS)将模型演化与运行时分离,通过异步管理部分生成,将迭代速度提高至三倍。
其他技术包括:
- 混合精度(FP8)以提高内存效率
- 专家并行和内核自动调优以优化MoE
- ByteCheckpoint用于稳健的检查点
- AutoTuner用于优化的并行和内存设置
以人为本的评估与实际应用
在创意写作、人文学科和一般对话的人类测试中,Seed-Thinking-v1.5超越了DeepSeek R1,证明了其现实世界的相关性。
团队指出,在可验证任务上的训练增强了对创意领域的泛化能力,这是由严格的数学工作流程驱动的。
对技术团队和企业的意义
对于管理LLM生命周期的技术领导者,Seed-Thinking-v1.5提供了一个将高级推理整合到企业AI系统中的模型。
其模块化训练,结合可验证数据集和多阶段强化学习,适合需要精确控制的LLM开发团队。
Seed-Verifier和Seed-Thinking-Verifier增强了可信的奖励建模,对于面向客户或受监管的环境至关重要。
对于时间紧迫的团队,VAPO和动态采样减少了迭代周期,简化了特定任务的微调。
混合基础设施,包括SRS和FP8优化,提升了训练吞吐量和硬件效率,适用于云和本地系统。
模型的自适应奖励反馈解决了管理多样化数据管道的挑战,确保跨领域的一致性。
对于数据工程师,严格的数据过滤和专家验证的重点强调了高质量数据集在提升模型性能中的价值。
未来展望
由吴永辉领导、林海滨公开代表的字节跳动Seed LLM系统团队开发的Seed-Thinking-v1.5,基于Doubao 1.5 Pro的努力,采用了共享的RLHF和数据精选技术。
团队旨在改进强化学习,专注于训练效率和不可验证任务的奖励建模。发布BeyondAIME等基准测试将推动推理导向的AI研究的进一步进展。








 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
 谷歌推出虚假来电检测功能,以防范AI深度伪造冒充诈骗
谷歌周二宣布,Android将推出虚假来电检测功能,以防范利用AI深度伪造技术实施的冒充诈骗。该功能将于本月通过“Phone by Google”在全球范围内面向Android 12及以上版本的设备逐步推出,首先适用于Pixel设备。随着人们越来越不愿接听陌生号码的来电,诈骗分子正改变策略,通过伪造可信的电话号码,并利用AI深度伪造技术模仿权威人士、家人或雇主的语气进行诈骗。例如,某人可能会接到一
 小鹏汽车旗下的Dogotix完成9亿美元融资
小鹏汽车旗下的Dogotix部门正在研发IRON人形机器人。来源:小鹏汽车效仿其他全球主要汽车制造商的做法,小鹏汽车正将业务拓展至类人机器人领域。 这家电动汽车制造商今日宣布,其机器人子公司Dogotix在首轮融资中筹集了超过9亿美元,此轮融资前的估值为50亿美元,交易后的估值超过63亿美元。据小鹏汽车称,这笔资金将用于推进软硬件开发、收集运营数据、训练物理AI模型、建立量产设施,并推动全球业务扩

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai

Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.












