


 Heim
ByteDance enthüllt Seed-Thinking-v1.5 KI-Modell zur Verbesserung der Denkfähigkeiten
Das Rennen um fortschrittliche denkende KI begann mit OpenAIs o1-Modell im September 2024 und gewann mit dem Start von DeepSeeks R1 im Januar 2025 an Dynamik.
Wichtige KI-Entwickler konkurrieren nun darum, schnellere, kostengünstigere denkende KI-Modelle zu entwickeln, die präzise, gut durchdachte Antworten durch verkettete Denkprozesse liefern und Genauigkeit vor der Antwort sicherstellen.
ByteDance, die Muttergesellschaft von TikTok, hat mit Seed-Thinking-v1.5, einem neuen großen Sprachmodell (LLM), das in einem technischen Bericht beschrieben wird, das Ziel, die Denkfähigkeit in STEM- und allgemeinen Bereichen zu verbessern.
Das Modell ist noch nicht verfügbar, und seine Lizenzierung – ob proprietär, Open-Source oder hybrid – bleibt unklar. Der Bericht bietet jedoch wichtige Einblicke, die vor der Veröffentlichung erkundet werden sollten.
Nutzung des Mixture-of-Experts (MoE) Frameworks
Nach Metas Llama 4 und Mistrals Mixtral verwendet Seed-Thinking-v1.5 die Mixture-of-Experts (MoE)-Architektur.
Dieser Ansatz steigert die Effizienz durch die Integration mehrerer spezialisierter Modelle in einem, die jeweils auf unterschiedliche Domänen fokussiert sind.
Seed-Thinking-v1.5 nutzt nur 20 Milliarden seiner 200 Milliarden Parameter gleichzeitig, um die Leistung zu optimieren.
Der auf GitHub veröffentlichte Bericht von ByteDance hebt den Fokus des Modells auf strukturiertes Denken und bewusste Antwortgenerierung hervor.
Es übertrifft DeepSeek R1 und konkurriert mit Googles Gemini 2.5 Pro und OpenAIs o3-mini-high in Benchmarks von Drittanbietern und übertrifft sie sogar im ARC-AGI-Benchmark, einem wichtigen Maß für Fortschritte hin zu künstlicher allgemeiner Intelligenz, die menschliche Leistungen in wirtschaftlich wertvollen Aufgaben übertrifft, gemäß den Standards von OpenAI.
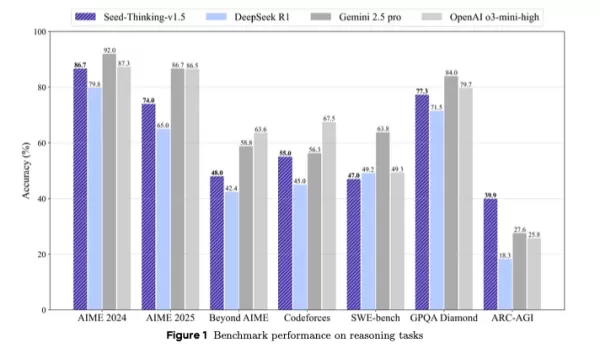
Als kompakte, aber leistungsstarke Alternative zu größeren Modellen positioniert, liefert Seed-Thinking-v1.5 starke Benchmark-Ergebnisse durch innovatives Verstärkendes Lernen, kuratierte Trainingsdaten und fortschrittliche KI-Infrastruktur.
Benchmark-Leistung und Kernstärken
Seed-Thinking-v1.5 glänzt bei schwierigen Aufgaben mit 86,7 % beim AIME 2024, 55,0 % pass@8 bei Codeforces und 77,3 % beim GPQA-Wissenschafts-Benchmark und liegt damit nahe an oder übertrifft Modelle wie OpenAIs o3-mini-high und Googles Gemini 2.5 Pro in Denkfähigkeitsmetriken.
Bei nicht-denkenden Aufgaben erreichte es eine um 8,0 % höhere Präferenzrate bei Menschen gegenüber DeepSeek R1, was Vielseitigkeit jenseits von Logik und Mathematik zeigt.
Um der Benchmarksättigung entgegenzuwirken, entwickelte ByteDance BeyondAIME, einen schwierigeren Mathematik-Benchmark, um Auswendiglernen zu verhindern und die Modellleistung besser zu bewerten. Dieser sowie der Codeforces-Satz werden öffentlich freigegeben, um zukünftige Forschung zu unterstützen.
Ansatz für Trainingsdaten
Die Datenqualität war entscheidend bei der Entwicklung von Seed-Thinking-v1.5. Für das überwachte Feintuning wurden 400.000 Proben kuratiert: 300.000 überprüfbare STEM-, Logik- und Programmieraufgaben sowie 100.000 nicht überprüfbare Aufgaben wie kreatives Schreiben.
Für Verstärkendes Lernen wurden die Daten unterteilt in:
- Überprüfbare Probleme: 100.000 sorgfältig ausgewählte STEM-Fragen und Logikrätsel aus Elitewettbewerben, validiert von Experten.
- Nicht überprüfbare Aufgaben: Datensätze mit menschlichen Präferenzen für offene Aufforderungen, bewertet über paarweise Belohnungsmodelle.
Über 80 % der STEM-Daten konzentrierten sich auf fortgeschrittene Mathematik, mit Logikaufgaben wie Sudoku und 24-Punkte-Rätseln, die an den Modellfortschritt angepasst wurden.
Innovationen im Verstärkenden Lernen
Seed-Thinking-v1.5 verwendet angepasste Actor-Critic (VAPO)- und Policy-Gradient (DAPO)-Frameworks, um Verstärkendes Lernen zu stabilisieren und Probleme in langen verketteten Denk-Szenarien zu lösen.
Zwei Belohnungsmodelle verbessern die RL-Überwachung:
- Seed-Verifier: Ein regelbasiertes LLM, das mathematische Äquivalenz zwischen generierten und Referenzantworten sicherstellt.
- Seed-Thinking-Verifier: Ein denkbasierter Richter für konsistente Bewertung, resistent gegen Belohnungsmanipulation.
Dieses duale System unterstützt präzise Bewertungen bei einfachen und komplexen Aufgaben.
Skalierbares Infrastrukturdesign
ByteDances HybridFlow-Framework, unterstützt von Ray-Clustern, ermöglicht effizientes Training großer Modelle mit kollokiertem Training und Inferenz, um GPU-Leerlaufzeiten zu minimieren.
Das Streaming Rollout System (SRS) trennt die Modellevolution vom Laufzeitbetrieb und beschleunigt Iterationen bis zu dreimal durch asynchrones Management von Teilgenerierungen.
Zusätzliche Techniken umfassen:
- Gemischte Präzision (FP8) für Speichereffizienz
- Experten-Parallelismus und Kernel-Auto-Tuning für MoE-Optimierung
- ByteCheckpoint für robustes Checkpointing
- AutoTuner für optimierte Parallelismus- und Speichereinstellungen
Menschzentrierte Bewertung und Anwendungen
Menschliche Tests in kreativem Schreiben, Geisteswissenschaften und allgemeinen Gesprächen zeigten, dass Seed-Thinking-v1.5 DeepSeek R1 übertrifft und seine Relevanz in der realen Welt beweist.
Das Team stellt fest, dass das Training mit überprüfbaren Aufgaben die Verallgemeinerung auf kreative Domänen verbesserte, angetrieben durch rigorose mathematische Arbeitsabläufe.
Bedeutung für technische Teams und Unternehmen
Für technische Leiter, die LLM-Lebenszyklen überwachen, bietet Seed-Thinking-v1.5 ein Modell zur Integration fortschrittlicher Denkfähigkeiten in Unternehmens-KI-Systeme.
Sein modulares Training mit überprüfbaren Datensätzen und mehrphasigem Verstärkendem Lernen eignet sich für Teams, die LLM-Entwicklung mit präziser Kontrolle skalieren.
Seed-Verifier und Seed-Thinking-Verifier verbessern vertrauenswürdige Belohnungsmodellierung, entscheidend für kundenorientierte oder regulierte Umgebungen.
Für Teams mit engen Zeitplänen reduzieren VAPO und dynamisches Sampling Iterationszyklen und optimieren aufgabenspezifisches Feintuning.
Die hybride Infrastruktur, einschließlich SRS und FP8-Optimierung, steigert den Trainingsdurchsatz und die Hardwareeffizienz, ideal für Cloud- und lokale Systeme.
Das adaptive Belohnungsfeedback des Modells löst Herausforderungen bei der Verwaltung vielfältiger Datenpipelines und gewährleistet Konsistenz über Domänen hinweg.
Für Dateningenieure unterstreicht der Fokus auf rigoroses Datenfiltern und Expertenverifikation den Wert hochwertiger Datensätze zur Steigerung der Modellleistung.
Ausblick
Entwickelt vom Seed LLM Systems-Team von ByteDance unter der Leitung von Yonghui Wu und öffentlich vertreten durch Haibin Lin, baut Seed-Thinking-v1.5 auf Bemühungen wie Doubao 1.5 Pro auf, unter Verwendung gemeinsamer RLHF- und Datencuration-Techniken.
Das Team zielt darauf ab, Verstärkendes Lernen zu verfeinern, mit Fokus auf Trainingseffizienz und Belohnungsmodellierung für nicht überprüfbare Aufgaben. Die Veröffentlichung von Benchmarks wie BeyondAIME wird weitere Fortschritte in der denkfokussierten KI-Forschung vorantreiben.
Verwandter Artikel
 OpenAI bringt eine sicherere Version von ChatGPT für Jugendliche auf den Markt, Jahre nachdem diese begonnen hatten, die Plattform zu nutzen
Nach einer Reihe von Gerichtsverfahren wegen fehlender Sicherheitsvorkehrungen bei KI-Chatbots – die zu Selbstmorden unter Jugendlichen und anderen psychischen Krisen beigetragen hatten – stellte Open
Google führt eine Funktion zur Erkennung gefälschter Anrufe ein, um vor Betrugsversuchen durch Deepfakes mit KI zu schützen
Google gab am Dienstag bekannt, dass Android eine Funktion zur Erkennung gefälschter Anrufe einführt, um vor Betrugsversuchen durch KI-Deepfakes zu schützen. Die Funktion wird diesen Monat weltweit in
Dogotix von XPeng Motors sichert sich Finanzierung in Höhe von 900 Millionen US-Dollar
Die XPeng-Tochter Dogotix entwickelt den humanoiden Roboter „IRON“. Quelle: XPengDem Beispiel anderer großer globaler Automobilhersteller folgend, weitet XPeng Motors seine Aktivitäten auf den Bereich
Empfehlungen zu verwandten Spezialthemen
Schreiben
 KI-Tools zur Gliederung von Artikeln für das Verfassen langer Texte
2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
 9 Tools
 xix.ai
Chatbot
Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

 Kommentare (1)
![ChristopherDavis]()
Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.
Das Rennen um fortschrittliche denkende KI begann mit OpenAIs o1-Modell im September 2024 und gewann mit dem Start von DeepSeeks R1 im Januar 2025 an Dynamik.
Wichtige KI-Entwickler konkurrieren nun darum, schnellere, kostengünstigere denkende KI-Modelle zu entwickeln, die präzise, gut durchdachte Antworten durch verkettete Denkprozesse liefern und Genauigkeit vor der Antwort sicherstellen.
ByteDance, die Muttergesellschaft von TikTok, hat mit Seed-Thinking-v1.5, einem neuen großen Sprachmodell (LLM), das in einem technischen Bericht beschrieben wird, das Ziel, die Denkfähigkeit in STEM- und allgemeinen Bereichen zu verbessern.
Das Modell ist noch nicht verfügbar, und seine Lizenzierung – ob proprietär, Open-Source oder hybrid – bleibt unklar. Der Bericht bietet jedoch wichtige Einblicke, die vor der Veröffentlichung erkundet werden sollten.
Nutzung des Mixture-of-Experts (MoE) Frameworks
Nach Metas Llama 4 und Mistrals Mixtral verwendet Seed-Thinking-v1.5 die Mixture-of-Experts (MoE)-Architektur.
Dieser Ansatz steigert die Effizienz durch die Integration mehrerer spezialisierter Modelle in einem, die jeweils auf unterschiedliche Domänen fokussiert sind.
Seed-Thinking-v1.5 nutzt nur 20 Milliarden seiner 200 Milliarden Parameter gleichzeitig, um die Leistung zu optimieren.
Der auf GitHub veröffentlichte Bericht von ByteDance hebt den Fokus des Modells auf strukturiertes Denken und bewusste Antwortgenerierung hervor.
Es übertrifft DeepSeek R1 und konkurriert mit Googles Gemini 2.5 Pro und OpenAIs o3-mini-high in Benchmarks von Drittanbietern und übertrifft sie sogar im ARC-AGI-Benchmark, einem wichtigen Maß für Fortschritte hin zu künstlicher allgemeiner Intelligenz, die menschliche Leistungen in wirtschaftlich wertvollen Aufgaben übertrifft, gemäß den Standards von OpenAI.
Als kompakte, aber leistungsstarke Alternative zu größeren Modellen positioniert, liefert Seed-Thinking-v1.5 starke Benchmark-Ergebnisse durch innovatives Verstärkendes Lernen, kuratierte Trainingsdaten und fortschrittliche KI-Infrastruktur.
Benchmark-Leistung und Kernstärken
Seed-Thinking-v1.5 glänzt bei schwierigen Aufgaben mit 86,7 % beim AIME 2024, 55,0 % pass@8 bei Codeforces und 77,3 % beim GPQA-Wissenschafts-Benchmark und liegt damit nahe an oder übertrifft Modelle wie OpenAIs o3-mini-high und Googles Gemini 2.5 Pro in Denkfähigkeitsmetriken.
Bei nicht-denkenden Aufgaben erreichte es eine um 8,0 % höhere Präferenzrate bei Menschen gegenüber DeepSeek R1, was Vielseitigkeit jenseits von Logik und Mathematik zeigt.
Um der Benchmarksättigung entgegenzuwirken, entwickelte ByteDance BeyondAIME, einen schwierigeren Mathematik-Benchmark, um Auswendiglernen zu verhindern und die Modellleistung besser zu bewerten. Dieser sowie der Codeforces-Satz werden öffentlich freigegeben, um zukünftige Forschung zu unterstützen.
Ansatz für Trainingsdaten
Die Datenqualität war entscheidend bei der Entwicklung von Seed-Thinking-v1.5. Für das überwachte Feintuning wurden 400.000 Proben kuratiert: 300.000 überprüfbare STEM-, Logik- und Programmieraufgaben sowie 100.000 nicht überprüfbare Aufgaben wie kreatives Schreiben.
Für Verstärkendes Lernen wurden die Daten unterteilt in:
- Überprüfbare Probleme: 100.000 sorgfältig ausgewählte STEM-Fragen und Logikrätsel aus Elitewettbewerben, validiert von Experten.
- Nicht überprüfbare Aufgaben: Datensätze mit menschlichen Präferenzen für offene Aufforderungen, bewertet über paarweise Belohnungsmodelle.
Über 80 % der STEM-Daten konzentrierten sich auf fortgeschrittene Mathematik, mit Logikaufgaben wie Sudoku und 24-Punkte-Rätseln, die an den Modellfortschritt angepasst wurden.
Innovationen im Verstärkenden Lernen
Seed-Thinking-v1.5 verwendet angepasste Actor-Critic (VAPO)- und Policy-Gradient (DAPO)-Frameworks, um Verstärkendes Lernen zu stabilisieren und Probleme in langen verketteten Denk-Szenarien zu lösen.
Zwei Belohnungsmodelle verbessern die RL-Überwachung:
- Seed-Verifier: Ein regelbasiertes LLM, das mathematische Äquivalenz zwischen generierten und Referenzantworten sicherstellt.
- Seed-Thinking-Verifier: Ein denkbasierter Richter für konsistente Bewertung, resistent gegen Belohnungsmanipulation.
Dieses duale System unterstützt präzise Bewertungen bei einfachen und komplexen Aufgaben.
Skalierbares Infrastrukturdesign
ByteDances HybridFlow-Framework, unterstützt von Ray-Clustern, ermöglicht effizientes Training großer Modelle mit kollokiertem Training und Inferenz, um GPU-Leerlaufzeiten zu minimieren.
Das Streaming Rollout System (SRS) trennt die Modellevolution vom Laufzeitbetrieb und beschleunigt Iterationen bis zu dreimal durch asynchrones Management von Teilgenerierungen.
Zusätzliche Techniken umfassen:
- Gemischte Präzision (FP8) für Speichereffizienz
- Experten-Parallelismus und Kernel-Auto-Tuning für MoE-Optimierung
- ByteCheckpoint für robustes Checkpointing
- AutoTuner für optimierte Parallelismus- und Speichereinstellungen
Menschzentrierte Bewertung und Anwendungen
Menschliche Tests in kreativem Schreiben, Geisteswissenschaften und allgemeinen Gesprächen zeigten, dass Seed-Thinking-v1.5 DeepSeek R1 übertrifft und seine Relevanz in der realen Welt beweist.
Das Team stellt fest, dass das Training mit überprüfbaren Aufgaben die Verallgemeinerung auf kreative Domänen verbesserte, angetrieben durch rigorose mathematische Arbeitsabläufe.
Bedeutung für technische Teams und Unternehmen
Für technische Leiter, die LLM-Lebenszyklen überwachen, bietet Seed-Thinking-v1.5 ein Modell zur Integration fortschrittlicher Denkfähigkeiten in Unternehmens-KI-Systeme.
Sein modulares Training mit überprüfbaren Datensätzen und mehrphasigem Verstärkendem Lernen eignet sich für Teams, die LLM-Entwicklung mit präziser Kontrolle skalieren.
Seed-Verifier und Seed-Thinking-Verifier verbessern vertrauenswürdige Belohnungsmodellierung, entscheidend für kundenorientierte oder regulierte Umgebungen.
Für Teams mit engen Zeitplänen reduzieren VAPO und dynamisches Sampling Iterationszyklen und optimieren aufgabenspezifisches Feintuning.
Die hybride Infrastruktur, einschließlich SRS und FP8-Optimierung, steigert den Trainingsdurchsatz und die Hardwareeffizienz, ideal für Cloud- und lokale Systeme.
Das adaptive Belohnungsfeedback des Modells löst Herausforderungen bei der Verwaltung vielfältiger Datenpipelines und gewährleistet Konsistenz über Domänen hinweg.
Für Dateningenieure unterstreicht der Fokus auf rigoroses Datenfiltern und Expertenverifikation den Wert hochwertiger Datensätze zur Steigerung der Modellleistung.
Ausblick
Entwickelt vom Seed LLM Systems-Team von ByteDance unter der Leitung von Yonghui Wu und öffentlich vertreten durch Haibin Lin, baut Seed-Thinking-v1.5 auf Bemühungen wie Doubao 1.5 Pro auf, unter Verwendung gemeinsamer RLHF- und Datencuration-Techniken.
Das Team zielt darauf ab, Verstärkendes Lernen zu verfeinern, mit Fokus auf Trainingseffizienz und Belohnungsmodellierung für nicht überprüfbare Aufgaben. Die Veröffentlichung von Benchmarks wie BeyondAIME wird weitere Fortschritte in der denkfokussierten KI-Forschung vorantreiben.








 OpenAI bringt eine sicherere Version von ChatGPT für Jugendliche auf den Markt, Jahre nachdem diese begonnen hatten, die Plattform zu nutzen
Nach einer Reihe von Gerichtsverfahren wegen fehlender Sicherheitsvorkehrungen bei KI-Chatbots – die zu Selbstmorden unter Jugendlichen und anderen psychischen Krisen beigetragen hatten – stellte Open
 Google führt eine Funktion zur Erkennung gefälschter Anrufe ein, um vor Betrugsversuchen durch Deepfakes mit KI zu schützen
Google gab am Dienstag bekannt, dass Android eine Funktion zur Erkennung gefälschter Anrufe einführt, um vor Betrugsversuchen durch KI-Deepfakes zu schützen. Die Funktion wird diesen Monat weltweit in
 Dogotix von XPeng Motors sichert sich Finanzierung in Höhe von 900 Millionen US-Dollar
Die XPeng-Tochter Dogotix entwickelt den humanoiden Roboter „IRON“. Quelle: XPengDem Beispiel anderer großer globaler Automobilhersteller folgend, weitet XPeng Motors seine Aktivitäten auf den Bereich

2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.












